
Pairing Matters: el harness cambia el resultado
Índice de contenidos
Cambiar de modelo parece la respuesta natural cuando un agente de programación falla. No encuentra el archivo, entra en un bucle, modifica la función equivocada o anuncia que ha terminado cuando los tests siguen rojos. La reacción habitual consiste en probar un modelo mayor, subir el presupuesto de tokens o cambiar de proveedor. Pero hay otra variable que solemos tratar como una pieza secundaria: el entorno de ejecución que decide qué ve el modelo, qué puede hacer y cómo termina su trabajo.
El artículo científico Pairing Matters: Performance, Failures, and Efficiency in Lightweight Coding Agents, de Lu Zhao, Christopher M. Poskitt y David Lo, publicado el 23 de octubre de 2026, convierte esa intuición en un experimento controlado. Sus autores cruzan seis harnesses con tres modelos de código de pesos abiertos sobre cien incidencias de SWE-bench Verified. Son 18 combinaciones y 1.800 ejecuciones evaluadas. En un mismo modelo, la distancia entre el mejor y el peor harness alcanza 44 puntos porcentuales. Y la historia no termina en el porcentaje de aciertos: también cambia el tipo de error y el gasto de tokens.
Este texto no pretende repetir Harness Engineering: el wrapper que gana, donde expliqué qué es un harness y por qué importa. Tampoco sustituye Harness²: agentes que mejoran su propio harness, centrado en optimizar ese entorno. Aquí la pregunta es más incómoda y más medible: ¿podemos decir que un modelo es bueno sin especificar con qué harness, en qué tareas y con qué presupuesto se probó?
El agente no es una llamada al modelo
Un modelo de lenguaje recibe mensajes y produce una respuesta. Un agente de código, en cambio, tiene que localizar archivos, leer instrucciones, ejecutar comandos, editar el repositorio, observar errores, corregirlos y producir un parche. Entre la petición inicial y el resultado hay una cadena de decisiones. Algunas las toma el modelo; otras, el software que lo rodea.
A ese software lo llamamos harness. No es solo un prompt del sistema. Incluye la interfaz de herramientas, el modo de entregar resultados de terminal, los límites de ejecución, la persistencia del estado, la política de reintentos, la selección de contexto y las condiciones para dar por terminada una tarea. Dos harnesses pueden utilizar exactamente los mismos pesos de un modelo y, aun así, conducirlo por caminos distintos. Uno invita a buscar primero; otro facilita editar inmediatamente. Uno entrega errores estructurados; otro devuelve una salida de consola difícil de interpretar. Uno detecta que no hay progreso; otro permite repetir la misma operación hasta agotar el presupuesto.
Esto tiene una consecuencia práctica para quien desarrolla en solitario: el catálogo de modelos no basta para escoger un agente. La configuración real es una pareja modelo–harness, además de la versión, las herramientas, el entorno y las tareas. Incluso un benchmark impecable deja de describir tu experiencia si cambias cualquiera de esas piezas.
La novedad del trabajo no es afirmar que el harness influye. Eso ya estaba documentado. La novedad es comparar todas las combinaciones seleccionadas sobre el mismo conjunto de tareas, conservar sus trayectorias y estudiar simultáneamente éxito, fallos y eficiencia.
Qué se evaluó exactamente: 6 × 3 × 100
Los autores eligieron OpenCode, OpenHands, mini-SWE-agent, SWE-agent, AutoCodeRover y Agentless. No representan seis interfaces equivalentes. Los cuatro primeros utilizan bucles de acción y observación dirigidos por el modelo. AutoCodeRover combina recuperación estructural y fases de reparación. Agentless sigue una secuencia más fija de localización, generación de parche y evaluación.
También hay diferencias importantes dentro de la muestra. mini-SWE-agent ofrece una interfaz centrada en Bash. OpenHands trabaja con un entorno persistente y herramientas de ejecución y edición. OpenCode expone herramientas estructuradas de búsqueda, lectura y modificación. SWE-agent incorpora una interfaz de interacción con el ordenador y un procedimiento de entrega de parches. No hay razón para esperar que el mismo modelo se comporte igual ante todas esas opciones.
Los modelos fueron Qwen3-Coder-Next, con 80.000 millones de parámetros totales y unos 3.000 millones activos por token; GLM-4.7-Flash, con 30.000 millones totales y unos 3.000 millones activos; y Devstral-Small, un modelo denso de 24.000 millones. El experimento utilizó GLM con razonamiento explícito activado y los otros dos en las configuraciones sin ese modo. No se trataba de probar que uno fuera universalmente superior, sino de explorar arquitecturas y protocolos de herramientas distintos.
Las tareas proceden de SWE-bench Verified, un conjunto de 500 incidencias reales de proyectos Python revisadas para mejorar la calidad de su evaluación. El estudio seleccionó 100, mediante un muestreo con semilla fija y cuotas por repositorio y dificultad. Es importante: no son los 500 casos del benchmark completo, y la distribución final no reproduce exactamente la proporción original de repositorios. Django aporta 33 tareas; otras bibliotecas aportan muchas menos. No es una muestra de aplicaciones Android, frontend, Kotlin ni mantenimiento cotidiano de un portfolio.
La multiplicación es sencilla: seis harnesses, tres modelos, cien tareas por pareja. Cada casilla representa cien intentos evaluados; el estudio conserva un intento final por combinación y tarea, no múltiples repeticiones con semillas distintas.
El esfuerzo de controlar las condiciones
La comparación es interesante porque los investigadores intentaron reducir las diferencias externas. Sirvieron los modelos de manera secuencial mediante vLLM, utilizando una NVIDIA H100 NVL para inferencia y un equipo CPU separado para ejecutar los harnesses. Todos accedían al modelo por una interfaz compatible con OpenAI. Las tareas, el procedimiento oficial de evaluación y el registro de tokens se mantuvieron comunes.
El proxy de medición registró solicitudes, respuestas, consumo de tokens y, cuando estaban disponibles, tiempos y datos de caché. Los parches se pasaron por el evaluador Docker oficial de SWE-bench. Las ejecuciones sin parche válido contaron como fallidas. El límite compartido fue de 262.144 tokens de salida acumulados por ejecución, no de tokens totales. Esto último importa cuando se habla de eficiencia: el límite de generación no equivale al consumo global de contexto.
Ahora bien, controlado no significa idéntico. El propio paper reconoce límites y tiempos de espera específicos de cada harness, ajustados en algunos casos para hacer viable el experimento. Los adaptadores de integración respetaron el flujo de trabajo de cada herramienta, pero los entornos no quedaron igualados hasta el último detalle. Además, las configuraciones concretas de AutoCodeRover y Agentless omitieron determinadas fases internas de validación. Los resultados describen esas configuraciones evaluadas, no necesariamente todas las formas posibles de instalar cada proyecto.
Es una distinción esencial. Cuando leemos que un harness obtuvo menos aciertos, no podemos concluir automáticamente que su arquitectura sea inferior en cualquier versión. Sí podemos concluir que esa combinación concreta, con esas condiciones, resolvió menos casos.
Los 18 resultados, sin esconder los malos
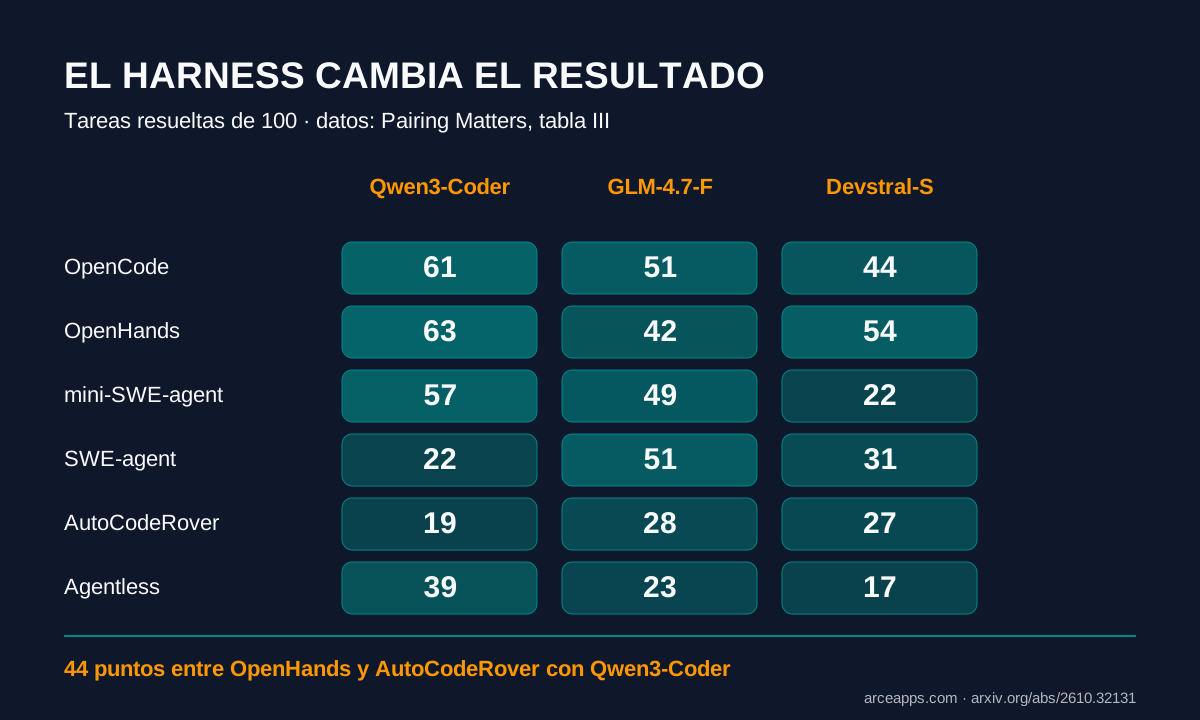
Esta es la tabla III del estudio, expresada como tareas resueltas de cien. Al tener exactamente cien tareas por pareja, el número coincide con el porcentaje de resolución.
| Harness | Qwen3-Coder-Next | GLM-4.7-Flash | Devstral-Small |
|---|---|---|---|
| OpenCode | 61 | 51 | 44 |
| OpenHands | 63 | 42 | 54 |
| mini-SWE-agent | 57 | 49 | 22 |
| SWE-agent | 22 | 51 | 31 |
| AutoCodeRover | 19 | 28 | 27 |
| Agentless | 39 | 23 | 17 |
| Resueltas por algún harness | 79 | 62 | 64 |
Fuente: tabla III del paper, página 5. Las negritas marcan el mejor valor por modelo; en GLM hay empate.
Hay varias lecturas útiles. Con Qwen, OpenHands resuelve 63 y AutoCodeRover 19: 44 puntos de diferencia. Con GLM, OpenCode y SWE-agent empatan en 51, mientras Agentless obtiene 23: 28 puntos. Con Devstral, OpenHands llega a 54 y Agentless a 17: 37 puntos. Esas diferencias son puntos porcentuales, no mejoras relativas del 44 %. Confundir ambos conceptos exageraría todavía más un resultado que ya es notable.
También cambia el orden. OpenHands lidera con Qwen y Devstral, pero no con GLM. SWE-agent obtiene 22 con Qwen y 51 con GLM. Si alguien evaluara SWE-agent solo con Qwen podría descartarlo; si lo evaluara solo con GLM llegaría a una conclusión distinta. Esa es precisamente la interacción que un ranking de componentes aislados no captura.
La tabla no autoriza a decir que OpenHands es el mejor harness del mercado. Solo compara seis alternativas, tres modelos y una selección concreta de tareas, con versiones y límites definidos. El mejor resultado global observado es 63/100, no una garantía de éxito del 63 % en cualquier repositorio.
La columna más interesante no corresponde a ningún harness
La última fila dice que Qwen resuelve 79 tareas con al menos uno de los seis harnesses, aunque su mejor pareja individual resuelve 63. Para GLM, la unión llega a 62 frente a 51; para Devstral, 64 frente a 54. Esto revela que las parejas no fallan exactamente en los mismos problemas.
Pero hay una trampa interpretativa. La unión se construye a partir de seis intentos por tarea, uno con cada harness. No demuestra que cambiar de harness sea mejor que repetir seis veces el mismo harness con semillas o condiciones diferentes. Los investigadores lo señalan expresamente. Para probar complementariedad real necesitaríamos comparar ambas estrategias con presupuestos equiparables y varias repeticiones.
La diferencia entre cobertura y consistencia merece atención. Qwen tiene la mayor unión, 79 tareas, pero solo cinco se resuelven con sus seis harnesses. GLM alcanza una unión menor, 62, aunque quince tareas se resuelven con los seis. Devstral tiene 64 en la unión y dieciséis tareas resueltas por exactamente un harness. No son métricas intercambiables: una habla de alcance potencial, otra de estabilidad frente al cambio de entorno.
Para un proyecto personal esto sugiere una idea modesta, no una receta milagrosa: mantener un segundo harness puede ser útil cuando el primero se atasca, pero antes hay que medir si aporta casos resueltos adicionales y cuánto cuesta ejecutar esa alternativa. La estrategia correcta no es lanzar seis agentes a ciegas sobre cada issue. Es aprender qué fallos justifican un segundo intento y con qué configuración.
Una victoria numérica puede ocultar un proceso desastroso
El paper no se conforma con contar parches aprobados. Analiza 1.100 ejecuciones fallidas mediante una taxonomía de cinco mecanismos, aplicando criterios en orden y asignando una categoría principal por fallo. Esto importa porque una puntuación de 40/100 puede significar cosas muy distintas.
Los bucles sin progreso o agotamiento de presupuesto suman 386 fallos, el 35,1 %. Los arreglos incorrectos o incompletos son 362, el 32,9 %. La validación insuficiente explica 141, el 12,8 %. La localización equivocada del defecto suma 129, el 11,7 %. Y las rupturas del intercambio entre modelo y entorno son 82, el 7,5 %. Son categorías de la clasificación de los autores, no diagnósticos universales aplicables a cualquier agente.
El orden de asignación también importa. Si una ejecución no llega a completar el parche por un fallo irrecuperable del entorno, no se etiqueta además como solución incorrecta. Si el parche toca archivos distintos de los de referencia, puede clasificarse como localización errónea. La etiqueta resume la causa observable predominante según una rúbrica; no contiene toda la complejidad causal de la ejecución.
Hay un detalle metodológico interesante: la clasificación no se limita a contar mensajes con palabras como «error» o «timeout». Utiliza trayectorias, parches y resultados de evaluación. Incluye revisión asistida y decisiones de adjudicación documentadas. Sigue habiendo juicio humano o asistido, y los autores admiten incertidumbre en etiquetas como validación insuficiente frente a reparación incorrecta. Esa cautela hace más valioso el análisis, no menos.
Cinco fallos, cinco preguntas diferentes
Ruptura del intercambio: el modelo solicita una herramienta que no se ejecuta, el entorno pierde el parche o una respuesta queda truncada. La primera pregunta no es «¿necesitamos un modelo más listo?», sino «¿el contrato entre modelo y herramientas funciona?». Hay que inspeccionar argumentos, permisos, salida y recuperación de errores.
Bucle sin progreso: el agente repite búsquedas, vuelve a editar lo mismo o sigue generando pasos sin acercarse a un parche verificable. Aquí interesan indicadores de avance, límites razonables, detección de acciones repetidas y un criterio de abandono o cambio de estrategia. Más tokens pueden prolongar el problema.
Localización incorrecta: el agente cambia archivos ajenos al defecto. El remedio candidato es mejorar la búsqueda y la comprensión de dependencias, pero no asumir que añadir una base vectorial resolverá cualquier caso. Una mala consulta a un índice perfecto sigue devolviendo contexto equivocado.
Validación insuficiente: el agente afirma haber solucionado el problema sin pruebas adecuadas o ignora resultados contradictorios. La intervención razonable es introducir verificaciones independientes y criterios explícitos de aceptación. No basta con escribir «ejecuta tests» en un prompt si el entorno no puede ejecutarlos.
Arreglo incorrecto o incompleto: el agente llega al área relevante, produce un parche y este no satisface los tests de referencia. Aquí puede faltar razonamiento, comprensión del contrato, capacidad de modificación o cobertura de casos límite. Cambiar el harness quizá ayude, pero hay problemas que requieren un modelo más capaz o intervención humana.
El valor de esta clasificación es que evita aplicar una sola medicina a cinco enfermedades diferentes.
El mismo modelo puede cambiar de forma de fallar
La comparación más reveladora es Qwen con SWE-agent. Entre las ejecuciones fallidas de esa pareja, el 95 % se clasifica como bucle sin progreso o agotamiento del presupuesto. Con AutoCodeRover, esa categoría representa el 64 %; con OpenCode, 51 %; con OpenHands, 32 %. No es una pequeña variación alrededor de una personalidad fija del modelo.
El fenómeno aparece también al mantener el harness constante. Bajo SWE-agent, los fallos de bucle o presupuesto representan el 95 % de los fallos de Qwen, el 35 % de GLM y el 25 % de Devstral. Un diagnóstico del tipo «SWE-agent siempre entra en bucle» sería tan simplista como «Qwen siempre entra en bucle».
Los agregados por modelo aportan otra capa. Qwen concentra 193 de sus 339 fallos, un 57 %, en progreso o presupuesto. Devstral distribuye sus 405 fallos entre reparaciones incorrectas, validación insuficiente, localización y bucles. GLM tiene como primera categoría las reparaciones incorrectas o incompletas, con 128 de 356. Los perfiles son diferentes, pero el harness modula su gravedad.
Conviene leer estos porcentajes con el denominador correcto. Decir «95 % de fallos de bucle» no significa «95 % de todas las tareas fracasan por bucles». Significa que, dentro de los intentos fallidos de esa pareja, casi todos recibieron esa etiqueta. Un porcentaje de fallos sin el número de éxitos puede llevar a conclusiones opuestas a las que permiten los datos.
Tokens por solución: la métrica que obliga a contar los fracasos
La tercera pregunta del estudio es económica en el sentido operativo, aunque no mide dinero directamente. Los autores suman tokens de entrada y salida de todas las ejecuciones de una pareja, exitosas y fallidas, y dividen por el número de tareas resueltas. Llaman a esto charged tokens per resolved task. Es una medida de cuánto tráfico de inferencia se necesita, en promedio, para producir un éxito evaluado.
La fórmula es:
tokens_por_tarea_resuelta =
    suma(tokens_prompt + tokens_completion de TODOS los intentos)
    / número_de_tareas_resueltas
La palabra todos es fundamental. Si un agente resuelve diez tareas consumiendo poco, pero gasta una fortuna en las noventa restantes, su eficiencia real será mala. Calcular solo la media de los éxitos ocultaría ese coste. Tampoco debemos confundir esta métrica con el coste monetario: los precios de proveedores, la cuantización, el consumo eléctrico, la caché y la infraestructura pueden cambiar la relación entre tokens y euros.
Para Qwen, los valores del estudio van desde 4,8 millones de tokens por tarea resuelta con AutoCodeRover hasta 87,8 millones con SWE-agent, entre los harnesses iterativos. OpenHands marca 15,6 millones; OpenCode, 26,3. La diferencia entre AutoCodeRover y SWE-agent es enorme, pero AutoCodeRover resuelve solo 19 tareas frente a las 22 de SWE-agent. No basta con elegir el menor coste por éxito: también importan la cobertura, la calidad del resultado y la probabilidad de resolver los casos que realmente te interesan.
Agentless aparece con cifras mucho menores, del orden de 0,1–0,2 millones, porque utiliza un procedimiento de pocas llamadas y un patrón de ejecución distinto. Compararlo directamente con un bucle interactivo sin explicar esa arquitectura sería engañoso. Los propios autores separan las conclusiones de los harnesses iterativos.
Menos llamadas no equivale a más eficiencia
El estudio registra además la mediana de llamadas al modelo por ejecución. Con mini-SWE-agent, Devstral necesita una mediana de 62 llamadas, frente a 92 de GLM. Sin embargo, Devstral consume 9,9 millones de tokens por tarea resuelta y GLM 6,2 millones. Menos intercambios no garantizan menos tokens si cada intercambio transporta más contexto o si los intentos fallidos pesan más.
Entre los cinco harnesses iterativos, Devstral tiene la menor mediana de llamadas en todos ellos. Qwen tiene la mayor en cuatro. Pero tampoco eso basta para decidir: el tamaño de los mensajes, las herramientas disponibles, los reintentos y el número de parches aprobados alteran la eficiencia final.
Una consecuencia práctica es que medir solo el número de llamadas a la API resulta insuficiente. También hay que registrar tokens por llamada, crecimiento del contexto, tiempo total, finalización de la tarea y motivo de cierre. Si no puedes reconstruir por qué una ejecución gastó muchos tokens, tampoco puedes optimizar el harness con criterio.
El artículo contrasta sus resultados con dos referencias externas de modelos de frontera ejecutados con OpenHands sobre las mismas cien tareas. Los autores estiman el consumo de tokens de esas referencias a partir de trayectorias públicas, mientras que para sus 18 parejas disponen de medición por proxy. No son mediciones homogéneas y el paper advierte que la comparación es orientativa. No sería honesto transformarla en una tabla de precios o en una afirmación de que un modelo de frontera es siempre más barato.
Cómo leer el experimento sin convertirlo en publicidad
Hay al menos seis límites que conviene recordar antes de elegir herramientas a partir de la tabla. El primero es la ausencia de repeticiones: un solo intento final por pareja y tarea impide estimar la variabilidad entre ejecuciones. Una diferencia pequeña puede ser ruido de muestreo o de comportamiento estocástico. Las grandes distancias merecen atención, pero tampoco son una ley universal.
El segundo es la selección de tareas. Cien casos permiten comparar 18 combinaciones con un presupuesto razonable, pero no permiten extrapolar el porcentaje a los 500 casos de SWE-bench Verified. El tercero es el dominio: se trata de incidencias Python de proyectos conocidos, no de interfaces Android, migraciones de datos, tareas DevOps o edición de contenidos.
El cuarto límite son los límites de ejecución específicos de cada harness. Si un sistema tiene menos tiempo o pasos, parte de su diferencia puede venir del presupuesto y no del diseño conceptual. El quinto es la configuración de inferencia: H100, vLLM, caché de prefijos, protocolos de herramientas y modos de razonamiento concretos. Cambiar a un mini PC con cuantización y menos memoria puede alterar latencias, errores y resultados.
El sexto es la definición de éxito. SWE-bench ejecuta pruebas sobre el parche, pero no certifica mantenibilidad, legibilidad, seguridad o que el cambio sea el adecuado para un producto real. Un parche que pasa tests puede seguir siendo una mala decisión de ingeniería. Para un blog técnico, una métrica sin sus límites no es rigor: es marketing.
Una guía para evaluar tus propias parejas
Si tuviera que adaptar esta investigación a un proyecto independiente, no intentaría reproducir las 1.800 ejecuciones. Diseñaría un conjunto pequeño de tareas representativas: un bug de UI, una regresión de lógica, una actualización de dependencia, una prueba rota y una modificación que atraviese varios módulos. El objetivo sería decidir qué pareja me ayuda en mi repositorio, no crear otro ranking global.
Primero congelaría las condiciones: commit inicial, descripción de la tarea, versión del modelo, versión del harness, herramientas, permisos, temperatura, límite de tokens, tiempo máximo y reglas de acceso a red. Si una pareja puede consultar documentación externa y otra no, ya no estoy midiendo solo el harness.
Después definiría criterios de aceptación independientes: tests, comprobación visual cuando proceda, revisión de diff, ausencia de archivos ajenos y prohibición de modificar tests para hacer pasar una solución falsa. Los criterios se establecen antes de ejecutar agentes; no se negocian después de ver qué ha producido cada uno.
Por último, repetiría cada tarea varias veces si el presupuesto lo permite. Esto separa, al menos parcialmente, la variación del harness de la variación estocástica del modelo. Las diferencias pequeñas necesitan más datos que las enormes. Para un indie, cinco tareas bien escogidas con varias repeticiones pueden ser más informativas que cien tareas irrelevantes.
No propongo utilizar un único número de «calidad». Querría ver tasa de éxito, tokens por tarea resuelta, duración, cambios innecesarios, categoría de fallo y esfuerzo de revisión humana. Esa última métrica rara vez aparece en un leaderboard, pero es la que determina si el agente te ahorra trabajo o te obliga a revisar una hora de código frágil.
Un registro mínimo que sí puedes mantener
No hace falta montar una plataforma de observabilidad completa para empezar. Un archivo JSONL por intento, generado por un pequeño envoltorio de ejecución, puede bastar. El siguiente ejemplo es un esquema ilustrativo de datos, no una API real de OpenCode ni una reproducción del código de los investigadores:
{
  "task_id": "bug-014",
  "repo_commit": "sha-del-estado-inicial",
  "model": "modelo-y-version",
  "harness": "harness-y-version",
  "seed": 2,
  "resolved": false,
  "failure_type": "no_progress",
  "model_calls": 41,
  "prompt_tokens": 182400,
  "completion_tokens": 24100,
  "wall_seconds": 740,
  "patch_sha256": "hash-del-parche",
  "validation": "failed"
}
Con registros así se pueden sumar tokens de éxitos y fracasos sin depender de impresiones. La fórmula para comparar parejas es reproducible y cabe en unas líneas de Python:
def tokens_per_resolved_task(runs):
    resolved = sum(bool(run["resolved"]) for run in runs)
    if resolved == 0:
        return None  # No hay denominador válido.
    total = sum(
        run["prompt_tokens"] + run["completion_tokens"]
        for run in runs
    )
    return total / resolved
El ejemplo no se ha ejecutado aquí contra el repositorio de ArceApps y no pretende producir un resultado experimental propio. Su propósito es explicar la métrica con claridad. En una prueba real habría que validar el formato, gestionar reintentos, distinguir tokens de caché, registrar el entorno y conservar evidencias sin guardar secretos ni contenido privado en logs públicos.
También registraría el motivo de parada. «No resuelto» es demasiado genérico. Un timeout, un parche incorrecto y una herramienta inaccesible requieren intervenciones distintas. Si el harness no expone esas señales, su observabilidad ya es una limitación operativa.
Qué haría con un agente que entra en bucle
Imaginemos un agente que lleva quince minutos leyendo los mismos archivos, cambiando el mismo condicional y ejecutando una prueba que falla de idéntica manera. Hay dos respuestas fáciles: aumentar el límite o pedirle que «reflexione mejor». Ninguna garantiza nada. La investigación sugiere mirar la trayectoria, no únicamente el resultado.
Buscaría primero un patrón observable: mismas llamadas con argumentos casi idénticos, ausencia de cambios útiles en el diff, tests que no cambian de estado o consumo creciente de tokens sin nuevas hipótesis. Un detector de estancamiento podría interrumpir la ejecución y solicitar un resumen verificable de lo intentado. Si sigue sin haber progreso, terminaría el intento y lo clasificaría.
Después comprobaría si el problema procede del modelo o del contrato del harness. ¿La herramienta devuelve un error ambiguo? ¿Se pierde el resultado entre pasos? ¿El agente carece de un comando para ejecutar una prueba concreta? ¿El contexto se ha llenado de salidas repetidas? Corregir la causa es preferible a añadir diez instrucciones genéricas al prompt.
Finalmente, probaría una modificación cada vez: una herramienta de búsqueda más precisa, un límite de iteraciones sin progreso, una política de resumen de estado o un verificador independiente. Si cambias todo a la vez y el resultado mejora, no sabrás qué intervención funcionó. Harness² explora precisamente la optimización del entorno; Pairing Matters recuerda por qué hay que medir la pareja concreta antes de celebrar la mejora.
Elegir entre más aciertos y menos tokens
Un caso delicado aparece cuando una pareja resuelve más tareas, pero gasta muchos más recursos. Supongamos dos configuraciones hipotéticas: A resuelve 7 de 10 tareas y consume 900.000 tokens; B resuelve 6 de 10 y consume 300.000. A tiene mejor tasa de éxito, mientras B gasta menos tokens por solución. Ninguna es automáticamente superior.
Si las tareas son críticas y la revisión humana cuesta mucho, quizá compense A. Si son cambios triviales, B podría ofrecer mejor relación entre coste y utilidad. Si las tareas resueltas por A y B son distintas, una estrategia de escalado selectivo podría ser mejor que cualquiera de las dos por separado. Pero habría que medir el coste de detectar cuándo escalar y el riesgo de introducir más cambios.
El paper no resuelve esta decisión de producto. Aporta los datos necesarios para dejar de confundir «más tokens» con «más trabajo útil». También obliga a distinguir eficiencia en tokens de coste económico. Un modelo pequeño servido localmente puede consumir muchos tokens sin generar una factura por token; aun así ocupa GPU, energía, memoria y tiempo. Un modelo remoto puede ser rápido y caro por solicitud. La métrica adecuada depende del objetivo.
En una herramienta de desarrollo personal, el recurso más escaso puede ser la atención. Una ejecución barata que exige una revisión larga quizá sea peor que otra que consuma más inferencia y produzca un parche fácil de entender. Ninguna cifra del paper mide directamente esa carga. Por eso no publicaría una clasificación de «mejor harness para todos» a partir de sus resultados.
¿Y si trabajas con modelos locales?
El interés del estudio crece cuando no puedes permitirte utilizar siempre un modelo enorme. Qwen3-Coder-Next y GLM-4.7-Flash son arquitecturas de expertos dispersos: activan una parte de sus parámetros por token, pero siguen necesitando alojar sus pesos. No debe confundirse «3.000 millones activos» con «modelo que ocupa lo mismo que uno de 3.000 millones de parámetros». Devstral-Small, por su parte, es denso.
La evaluación se hizo con una H100 NVL, no con una GPU de consumo ni con un mini PC doméstico. No se puede trasladar el resultado directamente a una máquina con cuantización agresiva, contexto reducido o límites térmicos. La latencia puede afectar el número de pasos que caben antes de un timeout; una ventana de contexto menor puede modificar el comportamiento del agente; un parser de llamadas a herramientas diferente puede cambiar su tasa de errores.
Aun así, la lección metodológica es perfectamente transportable: antes de descartar un modelo local porque «programa mal», comprueba si el harness lo está ayudando o entorpeciendo. Y antes de celebrar una cifra de benchmark, pregunta qué interfaz de herramientas, versión y presupuesto la produjeron.
Una prueba doméstica razonable empezaría con dos harnesses, un modelo y cinco tareas, registrando los mismos campos. Si la diferencia observada merece una investigación mayor, ampliaría a otro modelo y repetiría. Empezar con dieciocho parejas puede consumir más tiempo de infraestructura que el que pretende ahorrar.
Qué no demuestra Pairing Matters
El trabajo no demuestra que modificar el harness de un agente concreto vaya a aumentar siempre su rendimiento. Compara configuraciones existentes. Tampoco demuestra que la unión de seis harnesses sea mejor que seis intentos del mismo harness. No demuestra que una puntuación alta en Python prediga buen comportamiento en Android. No demuestra que el harness con menos tokens sea el más barato en euros ni que los parches aprobados sean mantenibles.
Tampoco prueba causalmente qué componente interno explica cada diferencia. Un cambio de prompt, de herramientas, de política de reintentos o de presupuesto puede interactuar con el modelo. Para aislar causas habría que hacer ablaciones: modificar una pieza, mantener las demás constantes y repetir tareas. Los autores plantean ese diagnóstico de interacciones como trabajo futuro.
El artículo es un preprint y conviene leer sus afirmaciones con ese estatus. Su fortaleza está en la matriz completa, los registros publicados y el análisis de trayectorias. Su principal límite está en que un diseño factorial con un intento por celda y tarea describe patrones observados, pero no estima por sí solo toda la variabilidad de ejecución ni todos los mecanismos causales.
Esta cautela no reduce el valor práctico. Lo sitúa donde corresponde: una base para diseñar evaluaciones mejores, no una tabla definitiva de compras.
Un pequeño protocolo antes de cambiar de modelo
Mi protocolo de decisión sería el siguiente. Cuando un agente falla, conservaría el diff, los tests y la trayectoria. Clasificaría si el problema fue de intercambio, progreso, localización, validación o reparación. Si hubo un error de herramienta, corregiría primero el entorno. Si hubo un bucle, probaría un mecanismo de detección y salida. Si hubo una reparación errónea, contrastaría con otro modelo o pediría revisión humana.
Después ejecutaría la misma tarea con una pareja alternativa sin cambiar los criterios de éxito. Compararía qué archivos tocó, qué pruebas ejecutó, cuánto contexto consumió y cómo terminó. Si una configuración gana una vez, no la declararía campeona; repetiría antes de convertir esa observación en regla. Mantendría las decisiones y los límites documentados, porque un benchmark sin configuración no es reproducible.
Para no confundir optimización con acumulación de complejidad, preferiría primero reutilizar herramientas de CI y tests existentes. Un verificador que ya funciona es más fiable que un agente adicional encargado de decidir si todo está bien. Y si la nueva capa de harness exige más mantenimiento que el ahorro que produce, probablemente no merece la pena.
Esta forma de trabajar conecta con el principio de SDD + TDD: del requisito a la prueba verificable: una tarea debe tener criterios comprobables, y una ejecución debe terminar con evidencia, no con una afirmación de éxito. El harness facilita el proceso, pero no sustituye el juicio de quien mantiene el proyecto.
Bibliografía y materiales para reproducir el análisis
- Fuente principal: Lu Zhao, Christopher M. Poskitt y David Lo, Pairing Matters: Performance, Failures, and Efficiency in Lightweight Coding Agents, arXiv:2610.32131, versión de 23 de octubre de 2026. Las tablas III, IV y V sustentan las cifras comentadas.
- Datos y scripts de los autores: lisazhao-gz/pairing-matters. El paper declara disponibles las 1.800 ejecuciones, trayectorias, parches, etiquetas y configuraciones.
- Benchmark: SWE-bench Verified y presentación de su proceso de validación, para entender qué mide y qué deja fuera.
- Herramientas evaluadas: OpenCode, OpenHands, mini-SWE-agent, SWE-agent, AutoCodeRover y Agentless.
- Lecturas relacionadas en ArceApps: Harness Engineering, Harness² y SDD + TDD.
La conclusión que me llevo
La frase fácil sería «el harness importa más que el modelo». No es lo que demuestra el estudio. Lo que muestra es más interesante: el rendimiento observable, el modo de fallar y la eficiencia pertenecen a la combinación, no a una pieza aislada. Un modelo puede mejorar mucho al cambiar de entorno; un harness que lidera con un modelo puede perder con otro; y un agente que resuelve más tareas puede consumir una cantidad de tokens difícil de justificar.
La próxima vez que vea una tabla de agentes con un porcentaje enorme, buscaré la letra pequeña: qué modelo, qué harness, qué tareas, qué versión, qué límites, qué costes y qué evidencia. Si esas preguntas no tienen respuesta, todavía no tengo una evaluación. Tengo una cifra bonita.
Y si un agente de mi flujo de trabajo se atasca, antes de pagar por más inteligencia intentaré averiguar si el entorno le está permitiendo utilizar bien la que ya tiene.
También te puede interesar
Harness²: agentes que mejoran su propio harness
Analiza Harness² de Google Research: sus dos ciclos de mejora recursiva, resultados, riesgos de seguridad y aplicaciones prácticas para agentes de código.
HybridAgents: razonar en latente y actuar con herramientas
Explora Hybrid Reasoning Agents: cómo combina razonamiento latente, memoria continua y herramientas, qué demuestra el paper y qué falta por validar.

DeepSeek Harness Desktop: análisis de su app
Descubre DeepSeek Harness Desktop: instalación, plugins, automatización, seguridad y límites reales de su nueva aplicación para agentes de IA.