
SDD + TDD: del requisito a la prueba verificable
Índice de contenidos
Antes de empezar: ya tenemos en ArceApps una introducción al desarrollo guiado por especificaciones, una guía de IA + TDD en Android y un análisis de grill-me aplicado al SDD. Aquí no repetiré qué es cada sigla: vamos a unirlas en un cambio pequeño, verificable y mantenible.
El contrato que nadie ejecuta y el test que no entiende el producto
Hay dos maneras habituales de engañarnos cuando programamos con agentes. La primera consiste en redactar una especificación muy elaborada, pedir al modelo que la implemente y asumir que un diff grande y una explicación convincente significan que se ha cumplido. La segunda es lo contrario: escribir pruebas unitarias para los detalles que el agente ya decidió y presentar todos los tests verdes como prueba de que el producto hace lo correcto.
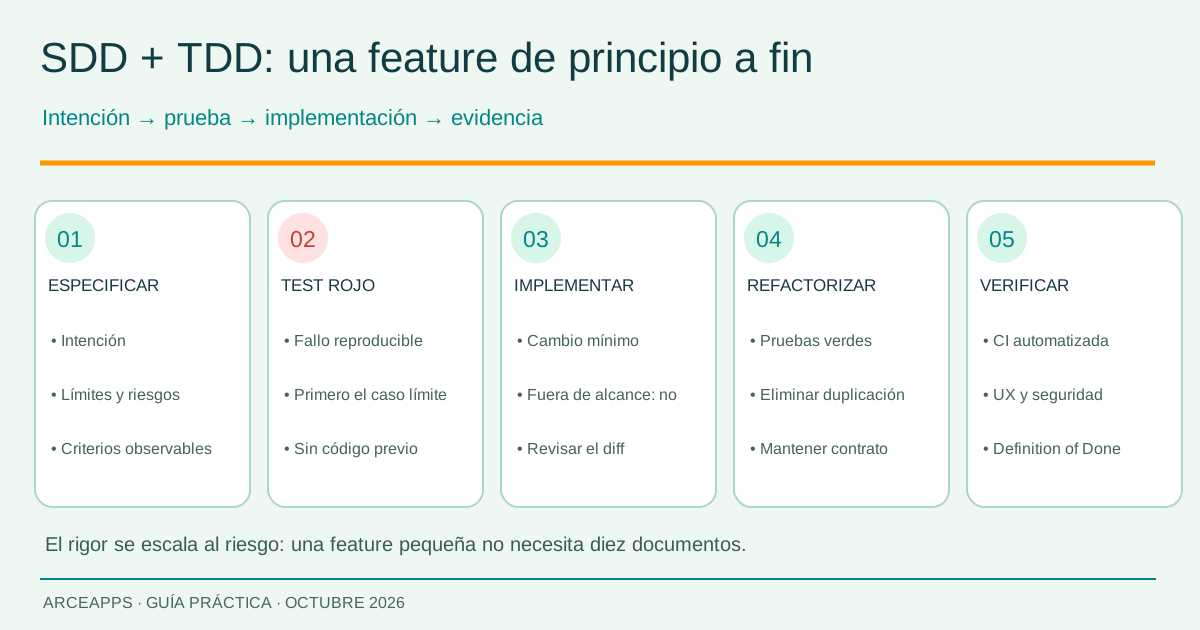
Ambos caminos pueden producir código impecable que resuelve el problema equivocado. Una especificación no es un test, y un test no demuestra nada sobre requisitos que nunca llegaron a escribirse. De ahí la combinación que ha reaparecido en las conversaciones de octubre: SDD → criterios de aceptación → TDD → implementación → verificación.
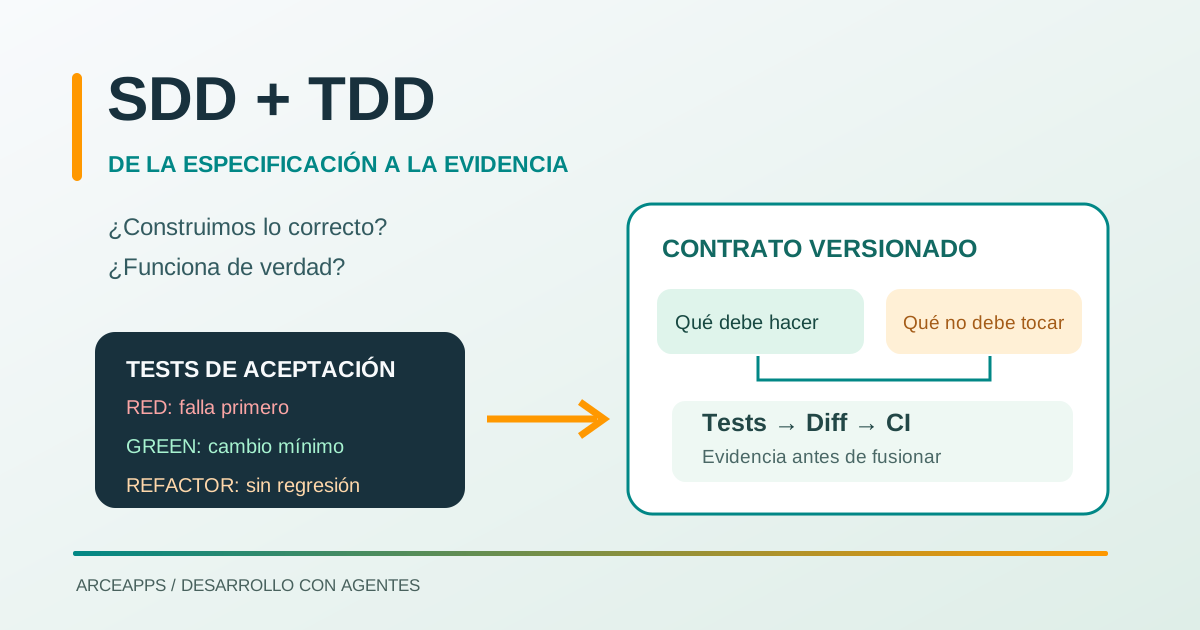
Un debate del 6 de octubre en r/ClaudeCode formulaba una distinción útil: SDD sirve para comprobar que construimos lo adecuado; TDD, para guiar cómo lo construimos; las pruebas de aceptación, para verificar el comportamiento visible. No son tres metodologías idénticas ni tres ceremonias que debamos aplicar a toda línea modificada.
Mi propuesta es más pequeña: conservar la intención fuera del chat, traducir los casos importantes en comprobaciones ejecutables, hacer que un test falle de verdad antes de arreglarlo y exigir evidencia en CI antes de fusionar. Cuando el riesgo es bajo, ese flujo cabe en una descripción breve y unas pocas pruebas. Cuando hay datos persistentes o permisos, merece más profundidad.
Por qué SDD y TDD encajan, y dónde pueden estorbarse
SDD establece el contrato: quién utilizará una funcionalidad, qué comportamiento espera, qué límites existen y cuáles son las señales de éxito. Un buen contrato no debería depender de cómo decidamos implementarlo. «No descontar dos intentos por repetir la misma petición» es una regla del producto; «usar un Set de JavaScript» es una posible implementación.
TDD desciende a un nivel diferente. Partimos de una observación que falta, escribimos una prueba que debe fallar (Red), introducimos el cambio mínimo para satisfacerla (Green) y mejoramos la estructura sin perder el comportamiento (Refactor). Cuando el agente participa, la prueba funciona también como un límite externo a sus explicaciones: una respuesta persuasiva no cambia la salida de un test.
Hay una trampa, sin embargo. Podemos convertir la especificación en un catálogo de decisiones de implementación y después obligar al agente a escribir pruebas que comprueban exactamente ese diseño. Eso elimina el espacio para resolver mejor el problema y produce tests frágiles. También podemos escribir casos de aceptación demasiado vagos, como «la experiencia será fluida», que no dicen qué verificar.
Para evitarlo, separo tres niveles: necesidad de usuario, comportamiento observable y detalle técnico. Cada decisión del tercer nivel debe justificarse con las dos anteriores o con una restricción del repositorio. El resultado ideal no son más documentos; es una menor distancia entre lo que pedimos y lo que CI puede confirmar.
El ejemplo: tres intentos diarios en una aplicación pequeña
Vamos a utilizar una funcionalidad sintética, independiente de los repositorios existentes de ArceApps: una aplicación concede tres intentos por día. El usuario envía una petición con un identificador único; repetir la misma petición por un error de red no debe consumir dos intentos. Al pasar a un día posterior, se restablece el contador. Un evento que retrocede en el calendario se rechaza.
El motivo de elegir este caso es que empieza pareciendo trivial y enseguida aparecen preguntas que un prompt apresurado ocultaría. ¿El día lo calcula el cliente o el servidor? ¿Qué ocurre si la conexión se repite? ¿El contador puede ser negativo? ¿Qué hacemos con un día imposible como el 30 de febrero? ¿Cómo impedir dos escrituras concurrentes sobre el mismo saldo?
El alcance será deliberadamente acotado: una función pura de transición de estado en Node.js, sin base de datos y sin servidor HTTP. Recibe un estado existente y una solicitud, devuelve un estado nuevo y un resultado. Esto permite probar la lógica sin fingir que ya hemos resuelto concurrencia entre procesos, sincronización del reloj o persistencia duradera.
La característica importante es la idempotencia. En las redes reales, una petición puede haberse procesado aunque el cliente nunca recibiera su respuesta. Si se repite con la misma clave, el sistema debe reconocerla en vez de descontar de nuevo. Ese requisito pertenece a la especificación incluso antes de decidir cómo guardar los identificadores.
Paso 1: escribir la especificación antes del código
Un documento de una página puede ser suficiente para este ejercicio. El objetivo se define así: «permitir hasta tres acciones aceptadas por día lógico y evitar descuentos duplicados por reintentos». El usuario no conoce ni necesita conocer la estructura interna del estado. Le importa que una acción válida se acepte y que no pierda crédito por un reintento.
De ese objetivo salen requisitos observables: R1 aceptar una nueva petición si queda saldo; R2 no volver a descontar un identificador ya procesado ese día; R3 no producir un saldo negativo; R4 reiniciar el saldo en un día posterior; R5 rechazar peticiones de días anteriores; R6 rechazar entradas vacías o fechas imposibles. Dejaría también escrito que la petición incluye un día lógico ISO calculado por una capa externa.
Los límites son tan importantes como la lista positiva. Este módulo no decide la zona horaria, no autentica al usuario, no administra una base de datos y no garantiza atomicidad ante dos procesos. No son defectos ocultos: son funciones que se tratarán en otro nivel. Un pequeño contrato puede declarar esos límites sin convertirse en una especificación monumental.
La definición de terminado inicial contiene tres pruebas de tipo distinto: casos positivos y negativos automatizados, revisión del diff para evitar cambios fuera de alcance y una nota explícita sobre los riesgos no cubiertos. Todavía no hemos escrito ninguna línea de la función. Esa separación nos permite detectar decisiones del producto antes de confundirlas con detalles del código.
Paso 2: convertir los requisitos en ejemplos comprobables
Los criterios de aceptación no deben limitarse a frases que la IA pueda repetir. Han de permitir construir un oráculo: dada una entrada, hay una salida esperada. Por ejemplo, con tres créditos y ninguna petición registrada, una nueva solicitud debe devolver dos créditos y el resultado accepted. Al repetir el mismo identificador, el resultado será duplicate y el estado permanecerá idéntico.
Cuando el crédito llega a cero, otra solicitud nueva devuelve exhausted sin restar nada. Si la fecha avanza, el saldo se reconstruye desde tres y se aplica el nuevo intento. Si retrocede, se lanza un error de rango. Si la fecha no existe, el módulo debe rechazarla como entrada inválida.
La decisión sobre el resultado de los duplicados merece atención: en un producto podríamos devolver el resultado original exitoso para hacer el endpoint completamente idempotente. Para este ejemplo usamos una señal explícita duplicate, útil en el dominio interno. No es una regla universal; es una decisión documentada en nuestro contrato de prueba.
Esta fase admite una tabla breve requisito → prueba, pero no necesita una matriz empresarial. Si una regla crítica no tiene al menos una observación que pueda fallar, la especificación todavía no guía la verificación. Si un test no se corresponde con ninguna regla relevante, conviene comprobar si aporta valor o si solo congela accidentalmente una implementación.
Paso 3: primer test en rojo
Podemos usar el ejecutor incorporado de Node.js, sin framework ni dependencias externas. Creamos quota.test.mjs e importamos la función que todavía no existe o devuelve un resultado incorrecto. Un primer test define la transición positiva:
import test from 'node:test';
import assert from 'node:assert/strict';
import { recordAttempt } from './quota.mjs';

const start = { day: '2026-10-08', remaining: 3, seen: [] };

test('accepts first attempt and uses one credit', () => {
  const result = recordAttempt(start, {
    day: '2026-10-08',
    requestId: 'req-1'
  });

  assert.equal(result.outcome, 'accepted');
  assert.equal(result.state.remaining, 2);
  assert.deepEqual(start.seen, []);
});
El tercer assert merece explicarse: comprueba que la entrada no ha sido mutada. No es un capricho de estilo. Una transición que altera silenciosamente el estado original dificulta comparar resultados y depurar reintentos, especialmente cuando la función termina dentro de un servicio más complejo.
La prueba debe fallar por la razón esperada antes de que implementemos la función. Si empieza verde porque se ha importado otro módulo, porque el test es demasiado débil o porque el agente lo ha escrito después del código, no tenemos evidencia de que el test vaya a detectar el defecto. El rojo es una observación, no una ceremonia estética.
Paso 4: una implementación pequeña y explicable
Este es el núcleo de la implementación usada en el ejercicio. Recibe el estado, valida los datos, diferencia día actual y día posterior, reconoce solicitudes repetidas y descuenta solo cuando procede.
export function recordAttempt(state, request) {
  const iso = request.day;
  const epoch = typeof iso === 'string'
    ? Date.parse(`${iso}T00:00:00Z`)
    : NaN;
  const validDay = /^\d{4}-\d{2}-\d{2}$/.test(iso)
    && Number.isFinite(epoch)
    && new Date(epoch).toISOString().slice(0, 10) === iso;

  if (!validDay || !request.requestId?.trim()) {
    throw new TypeError('Invalid request');
  }
  if (request.day < state.day) throw new RangeError('Stale day');

  const current = request.day === state.day
    ? state
    : { day: request.day, remaining: 3, seen: [] };

  if (current.seen.includes(request.requestId)) {
    return { state: current, outcome: 'duplicate' };
  }
  if (current.remaining === 0) {
    return { state: current, outcome: 'exhausted' };
  }
  return {
    state: {
      ...current,
      remaining: current.remaining - 1,
      seen: [...current.seen, request.requestId],
    },
    outcome: 'accepted',
  };
}
La lógica es deliberadamente poco espectacular. No hay clases genéricas, factorías, eventos distribuidos ni abstracciones que no exija el contrato. Esta sencillez también es un mecanismo de seguridad: cuanto menos código se interpone entre un requisito y su resultado, más fácil resulta auditarlo.
Paso 5: siete pruebas, y un rojo que apareció de verdad
Ejecuté este ejemplo de forma aislada con Node.js 22.16.0 y el runner integrado node —test. Primero había seis pruebas que cubrían aceptación, reintento idempotente, agotamiento, reinicio, día anterior y entradas mal formadas. Después añadí una séptima: un día imposible del calendario, 2026-02-30, debía producir un TypeError.
La versión inicial validaba solo el formato mediante una expresión regular. Aquella prueba falló. Más exactamente, al llegar a la comparación con un estado anterior produjo un RangeError en lugar del TypeError esperado. El fallo era útil: había demostrado que distinguir un formato plausible de una fecha real forma parte del contrato.
La corrección fue validar también que la fecha calculada al interpretarla corresponde exactamente a la cadena recibida. Así detectamos normalizaciones como convertir un día inexistente a un día válido posterior. Volví a ejecutar el conjunto completo y obtuve siete pruebas superadas, cero fallos. Ese resultado corresponde exclusivamente al ejemplo sintético ejecutado para este artículo, no a un pipeline de producción.
El ciclo Red-Green existe, por tanto, como evidencia reproducible. No basta con escribir «apliqué TDD» a posteriori. Sabemos qué caso cambió, qué resultado no cumplía y qué condición nueva introdujimos para hacerlo pasar. Esa trazabilidad vale más que una colección de capturas de consola con todos los indicadores en verde.
El test que un agente podría haber pasado sin resolver el defecto
Imaginemos que pedimos al agente «arregla el test del 30 de febrero». Hay un atajo tentador: cambiar el assert para aceptar el RangeError que ya devuelve la versión defectuosa. El conjunto de tests quedaría verde, pero habríamos cambiado el contrato para acomodarlo a la implementación. Es una forma sutil de validar el error en lugar de solucionarlo.
La defensa consiste en exigir que los criterios de aceptación se definan y revisen antes de que el agente vea una implementación conveniente. El agente puede cuestionar una regla si encuentra una contradicción real, pero no debería reescribir silenciosamente el comportamiento esperado para conseguir una ejecución verde. Cualquier cambio de contrato debe aparecer como decisión explícita.
La misma precaución vale para mocks. Si un test solo verifica que una función simulada fue llamada con ciertos parámetros, quizá nunca compruebe el resultado que importa al usuario. Los dobles de prueba son útiles cuando aíslan dependencias difíciles, pero no deben sustituir el comportamiento principal por una ilusión que nosotros mismos hemos programado.
Por eso una revisión de tests generados por IA pregunta «¿qué fallo real detectaría?» y «¿podría pasar aunque el comportamiento sea incorrecto?». Una respuesta clara a ambas preguntas es una señal más valiosa que un porcentaje de cobertura alto.
Refactorizar no es dejar que el modelo embellezca el código
El tercer paso de TDD es refactorizar manteniendo todas las pruebas verdes. Eso implica mejorar el diseño sin modificar el comportamiento observable. Un agente tiende a proponer abstracciones vistosas: separar la validación en varias clases, crear un módulo de políticas, añadir un repositorio genérico. A veces tiene sentido; muchas veces no.
En el ejemplo podríamos extraer una función isValidDay si la validación de fechas se reutiliza en otro lugar. Si no existe esa necesidad, quizá el helper solo añada distancia entre el contrato y el código. La refactorización útil debe responder a un problema localizado, como duplicación, nombre engañoso o una dependencia innecesaria.
Después de refactorizar, repetimos todos los tests y comprobamos el diff. TDD no convierte automáticamente el diseño en óptimo. Las pruebas protegen los comportamientos que se han especificado; no garantizan legibilidad, rendimiento, seguridad ni ausencia de acoplamiento. Son una red de seguridad, no un sustituto del criterio técnico.
El punto donde SDD vuelve a intervenir es precisamente este: el plan identifica decisiones arquitectónicas que deben preservarse. Si el agente introduce una capa que contradice la arquitectura existente, aunque pase los tests, el cambio puede seguir siendo inaceptable.
El límite más importante del ejemplo: concurrencia
Tenemos siete pruebas verdes. ¿Significa eso que ya podríamos usar la función en un servidor real con varios dispositivos? No. El ejemplo es una transición pura aplicada de manera secuencial sobre un estado que su llamador le entrega. Dos peticiones simultáneas podrían leer el mismo saldo anterior, ambas creer que pueden descontar un crédito y sobrescribir después el resultado de la otra.
Una implementación de producción tendría que garantizar atomicidad donde se guarda el estado: transacción de base de datos, control de versión optimista, operación condicional o mecanismo equivalente. La clave idempotente también debe persistirse con una restricción apropiada; una lista local en memoria no garantiza la deduplicación entre reinicios o nodos diferentes.
La separación entre fecha lógica y reloj también permanece sin resolver. El ejemplo confía en que otra capa entregue el día correcto. Una aplicación con usuarios en distintas zonas horarias y cambios de horario de verano necesita definir qué significa «día» y quién tiene autoridad para calcularlo.
Esto no invalida el ejercicio; confirma el valor de escribir límites explícitos. SDD evita que confundamos el comportamiento del dominio con las garantías de infraestructura. TDD demuestra la función dentro de sus premisas. La verificación de sistema debe comprobar después que esas premisas siguen cumpliéndose.
Cómo delegaría este flujo a un agente de código
Daría al agente un encargo dividido en decisiones que permitan observación. Primero: leer la estructura real del repositorio y su CI, y localizar implementaciones existentes de la regla. Segundo: proponer un contrato de una página, distinguiendo casos positivos, negativos y fuera de alcance. Tercero: mostrar qué tests van a fallar antes de empezar. Cuarto: implementar el cambio mínimo y ejecutar las pruebas relevantes.
En la revisión del resultado exigiría evidencia: nombre del test que estaba rojo, causa del fallo, diff que lo corrige, tests que pasan y dudas pendientes. No pediría al agente que cree nuevos scripts de validación si el repositorio ya tiene una acción que realiza la misma comprobación de forma fiable.
Para cambios con impacto real, además revisaría seguridad, accesibilidad, responsive o privacidad según corresponda. Esas preocupaciones no deben aparecer por defecto como quince documentos adicionales. Deben traducirse en pruebas o revisiones proporcionadas al riesgo.
El mejor papel del agente es reducir el coste de ejecutar estas actividades sin borrar los puntos de decisión humana. La automatización de un proceso defectuoso solo hace que el error llegue antes al merge.
Cuando el SDD cuesta más de lo que ahorra
Es importante incluir la crítica, porque el debate sobre SDD está lleno de ejemplos positivos escogidos con cuidado. En r/SpecDrivenDevelopment, un participante relató que, tras meses usando un flujo completo de propuestas y revisiones, no consiguió demostrar una mejora consistente frente a una petición inicial bien delimitada. También informó de mayor uso de tokens y más tiempo en sus tareas.
Es una experiencia comunitaria, no un estudio controlado ni una prueba de que SDD no sirva. Sin embargo, plantea la pregunta correcta: ¿qué incertidumbre estamos pagando por reducir? Para una corrección de nombre o un ajuste de CSS sin riesgo, una especificación de varias páginas probablemente sea desperdicio. Para una regla de facturación, permisos o migración de datos, discutir y probar los casos extremos puede evitar una regresión cara.
Mi criterio es graduar el esfuerzo: cambio trivial, propósito y test relevante; cambio mediano, pequeño contrato y plan; cambio de alto riesgo, pruebas de aceptación explícitas, revisión de arquitectura y migraciones. Una metodología solo merece conservarse si mejora la entrega de software, no si produce documentación impecable que nadie vuelve a consultar.
La sofisticación de Spec Kit, OpenSpec o BMAD puede aportar valor, pero también crear capas innecesarias. No confundamos disponer de un framework con necesitar utilizar todos sus comandos para cada tarea.
Spec Kit y otras herramientas: qué aportan al puente entre especificar y probar
La documentación oficial de GitHub Spec Kit define procesos para convertir intención en especificación, planificación, ejecución y convergencia. Sus plantillas exigen escenarios y requisitos comprobables; su comando de especificación dedica atención a criterios de éxito y casos límite. Eso es compatible con TDD, pero no lo sustituye automáticamente.
Hay además propuestas comunitarias de presets orientados a test-first y trazabilidad, como el issue #3502. Una propuesta abierta no equivale a una funcionalidad estable y universal, pero demuestra la misma necesidad conceptual: conectar contratos con pruebas sin que el equipo tenga que hacerlo todo manualmente.
En el flujo ligero que defiendo, no necesitamos adoptar un framework entero para capturar esas ventajas. Bastan un archivo de plan y otro de tareas cuando el cambio lo justifique, los tests en el lenguaje del proyecto y CI como fuente de verdad sobre su resultado. Si el proceso empieza a repetir siempre las mismas comprobaciones, entonces sí tiene sentido automatizarlo.
La herramienta elegida debe adaptarse a la arquitectura existente. No conviene imponer un formato ajeno que convierta una tarea pequeña en mantenimiento de plantillas. El mejor harness para SDD + TDD es el que mantiene claro el contrato y deja ejecutar evidencia reproducible.
Checklist de cierre que realmente usaría
Antes de fusionar una PR con código generado o asistido por IA, revisaría cinco preguntas. ¿Se puede rastrear cada comportamiento importante a un requisito real? ¿Los tests relevantes fallaron antes de la corrección? ¿Los casos negativos y los límites importantes están representados? ¿El diff respeta arquitectura, privacidad y alcance? ¿Las comprobaciones automáticas que ya tenemos han terminado correctamente?
No necesitamos un informe de decenas de páginas para responder. Una descripción breve de la PR puede enlazar especificación, casos de aceptación y resultado de CI. Si falta una prueba visual o manual, se anota sin convertirla en un «PASS» ficticio.
También es obligatorio reconocer lo que no se cubrió. En nuestro ejemplo, persistencia y concurrencia no están resueltas. Declararlo permite planificar el siguiente nivel de trabajo y evita que alguien reutilice la función creyendo que ofrece garantías que no tiene.
La Definition of Done no es una felicitación que se escribe al final. Es el umbral que nos permite decir que una feature merece permanecer en la rama principal, incluso cuando el agente lleva media hora convencido de que ya está terminada.
Conclusión: intención versionada, comportamiento ejecutable
SDD y TDD no compiten por el mismo puesto. SDD obliga a expresar qué esperamos y qué límites no queremos cruzar. TDD introduce una prueba que puede desmentir nuestro optimismo y guía la implementación en incrementos pequeños. La revisión y CI ofrecen una capa de evidencia que no depende de cuánto le guste al modelo el código que ha escrito.
El ejemplo de cuota diaria es modesto, pero enseña una lección importante. Un test adicional detectó una fecha imposible, produjo un fallo observable y obligó a corregir la validación. Después los siete casos pasaron. Esa es la clase de iteración concreta que me interesa, más que un documento bonito lleno de promesas sobre agentes autónomos.
Escala el proceso al riesgo, no al número de herramientas de IA instaladas. Una especificación corta y un test realmente útil pueden ahorrar más mantenimiento que toda una ceremonia. Cuando el software importa, el objetivo no es que el agente diga «terminado», sino que podamos demostrar por qué lo está.
Bibliografía
- GitHub Spec Kit: documentación oficial — procesos, contratos y criterios verificables.
- Comando specify y checklist — requisitos comprobables y casos límite.
- Spec Kit: contribuciones y pruebas — tests positivos/negativos y regresiones.
- Propuesta de preset test-first — ejemplo de evolución, no función estable asumida.
- Debate SDD + TDD en r/ClaudeCode — motivación y preguntas reales.
- Crítica de coste de SDD en Reddit — experiencia comunitaria con límites metodológicos.
- Introducción al SDD en ArceApps y IA + TDD en Android — fundamentos tratados previamente.
Ejemplo independiente del código de ArceApps; probado localmente con Node.js 22.16.0 el 10 de octubre de 2026. La fecha editorial de la serie es el 8 de octubre de 2026.
También te puede interesar

DeepSeek Harness Desktop: análisis de su app
Descubre DeepSeek Harness Desktop: instalación, plugins, automatización, seguridad y límites reales de su nueva aplicación para agentes de IA.
Jev: IA para decidir, no para escribir
Descubre Jev y los System One Models: instalación, API, SDK, Agent Skill, CLI/MCP comunitarios y patrones para decisiones tipadas en software.
Codex Agent Router: Orquestar agentes externos
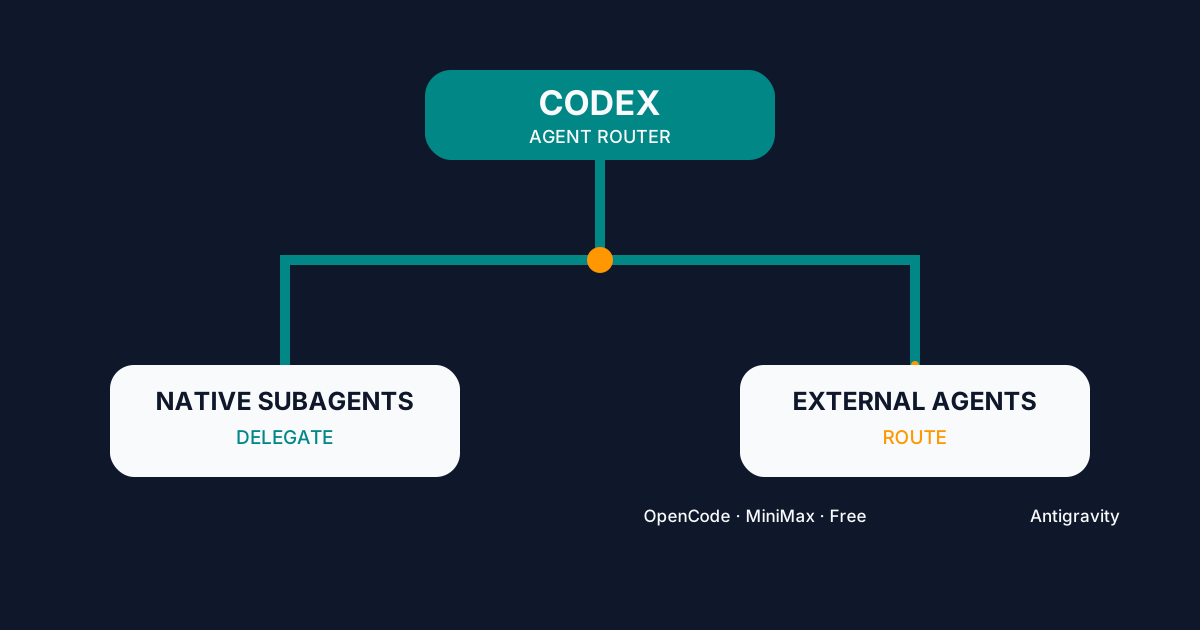
Configura Codex Agent Router para delegar en subagentes internos o enrutar trabajo a OpenCode, MiniMax, Big Pickle y Antigravity desde una sola interfaz.