
Harness²: agentes que mejoran su propio harness
Índice de contenidos
El modelo importa, pero no trabaja solo. Un agente también depende de las instrucciones que recibe, las herramientas disponibles, la memoria, los permisos y la forma de evaluar el resultado. Todo ese sistema alrededor del modelo es el harness. ¿Y si en lugar de ajustarlo manualmente pudiéramos mejorar esas piezas a partir de la evidencia de sus propias ejecuciones?
Harness²: Recursive Agent Harnessing for an Open World, publicado en arXiv el 9 de octubre de 2026 por Ruiyao Xu y colaboradores, investiga precisamente esta posibilidad. El código está disponible en google-research/harness2, bajo Apache 2.0. Aunque el repositorio pertenece a Google Research, el propio proyecto aclara que no es un producto oficial con soporte de Google.
En Harness Engineering: el wrapper que gana ya argumenté que un agente no se resume en su modelo. Aquí la pregunta cambia: ¿cómo demostrar que una modificación del harness realmente ayuda? ¿Podemos aprender de una tarea para mejorar la siguiente, sin reentrenar un LLM?
El harness no es un prompt con un nombre nuevo
El trabajo enumera ocho componentes editables: system prompt, guardrails, memory, tool guidance, subagents, skills, scripts y plugins. Son piezas con responsabilidades diferentes. Las instrucciones ayudan a decidir; las herramientas permiten actuar; los guardrails restringen acciones; los scripts y las skills encapsulan procedimientos; la memoria permite recuperar información; los subagentes distribuyen trabajo.
Un cambio de prompt puede ser irrelevante si faltan herramientas. Una skill que recomienda ejecutar pruebas no funciona si el entorno no tiene las dependencias instaladas. Y un agente equipado con shell sin aislamiento puede resultar peligroso aunque sus instrucciones parezcan prudentes.
En un proyecto independiente, estas fricciones son reconocibles. Ajustamos un archivo de instrucciones, añadimos una comprobación o modificamos la secuencia de trabajo y esperamos que el agente deje de repetir un error. Lo difícil es separar la mejora real de la suerte o del efecto de haber cambiado simultáneamente varias cosas.
El problema: tareas que nadie anticipó
Los procedimientos automáticos de mejora suelen utilizar una puntuación: test aprobado, respuesta correcta, recompensa de un juego. Pero los agentes trabajan en entornos abiertos. Una tarea puede implicar revisar una web, producir un documento o corregir un componente, y no siempre conocemos la solución antes de ejecutar al agente.
Harness² trata dos dificultades. La primera es mejorar el harness de la tarea actual sin disponer de un verificador que conozca la respuesta correcta. La segunda es extraer experiencias transferibles para tareas futuras. La respuesta del paper son dos recursiones conectadas.
Primera recursión: Propose–Probe–Compose
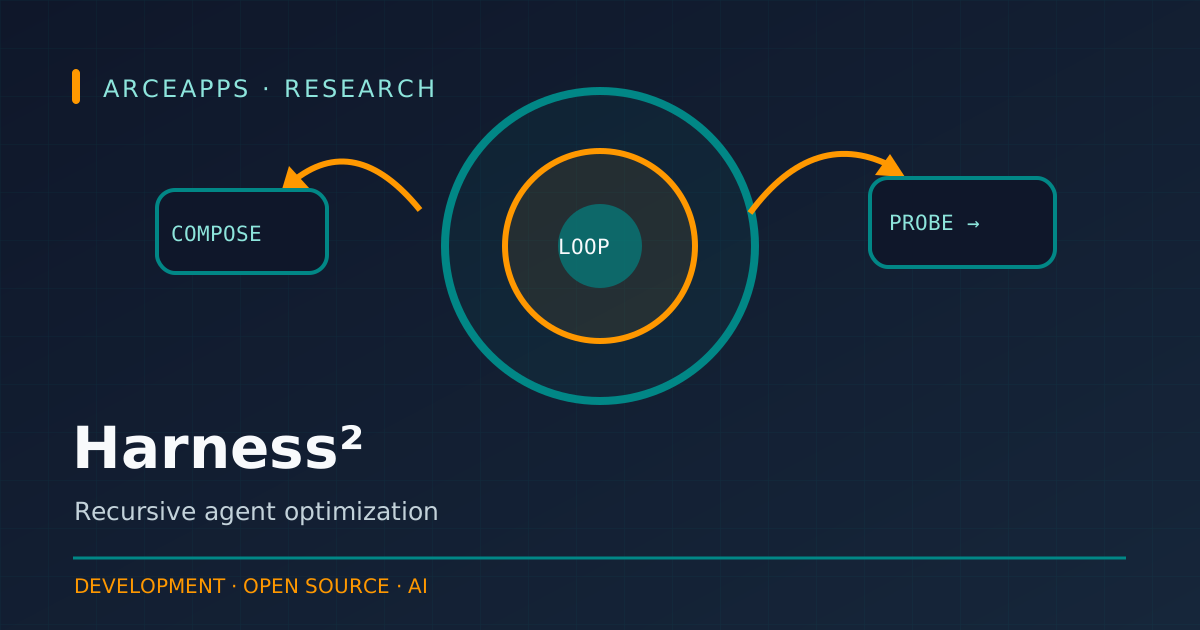
El mecanismo de nivel de tarea se llama Propose–Probe–Compose. Primero propone variaciones concretas del harness. Después prueba su efecto con ejecuciones de la misma tarea. Por último, compone una versión refinada comparando los comportamientos observados.
                 Tarea nueva
                     |
              Harness inicial
                     |
                   Propose
               /      |      \
           Variante A  B       C
               \      |      /
                     Probe
           comparar trayectorias
                     |
                   Compose
                     |
             Harness refinado
Esto va más allá de pedir al agente «piensa qué has hecho mal». Las variantes permiten observar cambios de comportamiento. La comparación puede producir señales útiles aunque no exista una respuesta perfecta disponible durante la tarea.
Pero hay una limitación importante: comparar dos comportamientos no significa saber cuál es correcto. Un agente puede responder con mayor seguridad y seguir cometiendo un error. Puede completar una tarea saltándose una comprobación que parecía costosa. La evaluación independiente sigue siendo necesaria.
El sistema permite explorar varias variantes en paralelo o refinar secuencialmente un candidato. Aumentar el presupuesto de recursión puede mejorar resultados, pero también multiplica ejecuciones, llamadas a herramientas, tokens y tiempo. No hay una mejora gratis.
Segunda recursión: una memoria de mejoras
Tras la tarea, Harness² actualiza un improvement harness persistente, incorporando los harnesses adoptados y lecciones respaldadas por evidencias. El objetivo es que la siguiente tarea no comience desde cero. Este segundo nivel intenta generalizar lo aprendido.
Tarea A -> variantes -> evaluación -> lección A
                                        |
                                        v
                            improvement harness
                                        |
Tarea B -> usar lección A -> nueva evidencia
                                        |
                                        v
                            memoria de mejoras
La idea es atractiva, pero exige una distinción: recordar que una estrategia funcionó en una tarea concreta no implica que deba convertirse automáticamente en regla universal. Si una limitación de archivos ayudó en un bug local, quizá bloquee una reparación que requiere cambiar un componente compartido.
Por eso, cualquier memoria de mejoras debería incluir contexto, condiciones, evidencias y posibilidad de reversión. No conservaría únicamente una recomendación. Guardaría también el problema en el que se probó y las alternativas descartadas.
Los resultados del artículo científico
Los autores reportan mejoras sobre sus harnesses base de hasta 11,5 puntos en WorkBuddy-Bench, 4,5 puntos en JobBench y 11,8 puntos porcentuales en la tasa de aprobación parcial de LAB. Las pruebas incluyen cuatro configuraciones modelo–harness con GLM-5 y Gemini 3.5 Flash.
Son resultados de investigación, no una promesa universal. «Hasta» no significa que cada configuración mejore lo mismo. Tampoco es necesariamente más barato: cada candidato requiere nuevas ejecuciones. Hay que distinguir la calidad de salida del coste total de la exploración.
El hallazgo interesante es la mejora sin modificar los pesos del modelo. Para quienes utilizamos modelos de terceros, optimizar el entorno resulta mucho más accesible que entrenar un modelo desde cero.
No obstante, un benchmark no sustituye la evaluación longitudinal de un repositorio vivo. En proyectos reales interesan las regresiones, los efectos acumulativos y la capacidad de mantener el sistema meses después.
Qué se puede ejecutar realmente
El repositorio incluye ejecutores para OpenCode y Codex, además de una demostración local con editores deterministas y ejecuciones de Python, que no requiere credenciales de un modelo. Según su README, los requisitos básicos son Linux, Python 3.12 y uv. El arranque documentado es:
uv venv --python 3.12 .venv
source .venv/bin/activate
uv pip install -e '.[render]'
harness2-demo --output runs/demo --k 2
No he ejecutado esta instalación: reproduzco las instrucciones oficiales para explicar el alcance de la release. La demostración ayuda a entender ambos niveles de recursión, pero no equivale a reproducir los benchmarks con modelos comerciales. Para estos últimos existen dependencias específicas de cada suite.
El proyecto documenta recursión paralela y secuencial, la opción de usar Codex como ejecutor y mecanismos para guardar resultados de tareas, reflexiones y harnesses adoptados. Eso permite auditar experimentos, aunque la calidad de esa auditoría depende de cómo se configure el entorno.
El riesgo de seguridad que aparece en el README
Hay un aviso que no deberíamos pasar por alto. La documentación señala que el acceso a red del ejecutor es ilimitado y que Codex se ejecuta con el sandbox deshabilitado en el entorno experimental descrito. También recuerda que las rúbricas públicas de benchmarks pueden estar accesibles desde la red y contaminar las evaluaciones.
No montaría Harness² directamente sobre un repositorio privado con credenciales ni le daría acceso al proceso de despliegue. Lo probaría en un directorio desechable, sin secretos, con conectividad restringida y datos sintéticos. Un sistema capaz de modificar sus instrucciones no debería poder modificar sin control las reglas que lo supervisan.
Las advertencias del repositorio no invalidan el paper; aclaran que una configuración experimental no es automáticamente una arquitectura segura para producción.
Una prueba pequeña que sí haría
Imaginemos una app web mantenida por una sola persona. Ya tenemos tests y CI. Queremos que el agente evite cambios innecesarios y detecte problemas responsive antes de abrir un PR.
Elegiría cuatro tareas conocidas, cada una con un commit inicial fijo. Probaría tres harnesses: el actual, uno con instrucciones de alcance más estrictas y otro con una verificación visual adicional. Todos usarían el mismo modelo, las mismas herramientas y límites de ejecución.
Para cada ejecución registraría:
- si el resultado supera los criterios funcionales;
- cuántas regresiones detectan los tests independientes;
- cuántos archivos se modifican sin necesidad;
- tiempo total, coste y llamadas a herramientas;
- acciones sensibles intentadas y revisabilidad del diff.
La decisión de adopción sería externa al agente. Un harness que acaba antes porque omite pruebas no sería mejor. Tampoco aceptaría una versión más costosa solo porque redacta explicaciones más bonitas. El objetivo es reducir defectos reales, no obtener una buena valoración estética.
Aprender de un bug responsive: ejemplo
Supongamos que el agente arregla un encabezado que ocupa dos líneas en móvil. Un harness le ordena usar solo pruebas unitarias; otro añade comprobaciones visuales; un tercero impide tocar archivos fuera del componente.
Si el segundo resuelve el defecto sin regresiones y el tercero falla porque el problema nace en el contenedor compartido, la lección no es «usar siempre el segundo». Es comprobar visualmente las tareas de layout y delimitar el alcance según las dependencias reales.
Esa lección puede guardarse junto con la evidencia. Si aparece un problema de base de datos, no tendría sentido trasladar mecánicamente una política de screenshots. Un sistema que aprende debe aprender también cuándo no generalizar.
El problema de optimizar una métrica equivocada
Cualquier optimizador puede terminar persiguiendo la puntuación en lugar del objetivo. Un agente puede aprender a aprobar ciertas pruebas escribiendo código rígido. Puede esconder errores o producir instrucciones que favorezcan su evaluación. En un benchmark público podría explotar información disponible del entorno.
La defensa es un verificador externo, pruebas no incluidas en el contexto del agente y un historial de éxitos y fracasos. El harness que se optimiza no debe poder cambiar libremente el criterio que decide si ha mejorado.
En ingeniería personal esta disciplina suele ser más útil que cualquier promesa de autonomía total. Lo que queremos no es una IA que se felicite a sí misma, sino una herramienta que deje el repositorio en un estado mejor y demostrable.
Harness² frente a DeepSeek Harness
En DeepSeek Harness vimos una arquitectura basada en plugins. Esa flexibilidad permite cambiar componentes. Harness² investiga cómo buscar, probar y seleccionar variantes de esos componentes.
Uno proporciona un espacio de configuraciones; el otro un método para mejorar dentro de ese espacio. Ninguno sustituye por sí solo un test independiente, una política de permisos o la revisión del código final.
También encaja con el análisis de DeepSeek Harness Desktop: una interfaz cómoda mejora la experiencia, pero no determina qué combinación de memorias, herramientas y reglas resuelve mejor una tarea.
Cuándo no merece la pena
No utilizaría un sistema recursivo para ajustar una regla trivial cuyo efecto pueda comprobar con un único test. Tampoco lo introduciría donde no existen requisitos medibles. Las pruebas de candidatos consumen recursos, y una colección de instrucciones editadas automáticamente puede volverse más compleja que el problema original.
Antes de instalar una infraestructura nueva, preguntaría: ¿podemos conseguir casi todo el beneficio con una mejor skill, una tarea de CI y una checklist de verificación? Si la respuesta es sí, esa solución es preferible.
Cómo separaría las responsabilidades del agente y del evaluador
La mejora automática necesita una frontera clara. El agente de ejecución tiene permiso para resolver tareas dentro de un entorno delimitado. El agente optimizador puede proponer cambios de instrucciones y configuraciones. El evaluador, en cambio, conserva criterios y pruebas que ninguno de los otros dos debería poder editar durante el experimento.
Esa separación no garantiza que todo funcione, pero impide una trampa frecuente: permitir que el mismo sistema que genera una solución también cambie las condiciones de aprobación. Si una variante de harness decide no ejecutar una prueba incómoda y luego se declara vencedora, el experimento no nos ha enseñado nada sobre calidad.
Para un proyecto con CI, el papel del evaluador externo puede repartirse entre pruebas de contrato, tests unitarios, comprobaciones de rutas internas y revisión de cambios. La comparación puede incorporar métricas cualitativas, pero estas también deben tener criterios definidos antes de conocer las variantes.
La recomendación práctica sería guardar las ejecuciones bajo identificadores estables: commit inicial, versión del harness, modelo, configuración de esfuerzo, herramientas disponibles y resultado completo. Sin esa trazabilidad, seis meses después resulta imposible saber por qué se adoptó una instrucción.
Cómo evitar una memoria de reglas contradictorias
Una memoria persistente de mejoras plantea otro problema menos visible: con el tiempo acumula instrucciones que fueron útiles en circunstancias diferentes. Una lección dice «explora poco»; otra dice «revisa todas las dependencias antes de editar». Ambas pueden ser correctas según el contexto, pero incompatibles si se activan al mismo tiempo.
Yo modelaría las lecciones como hipótesis condicionadas, no como órdenes eternas. Cada entrada debería describir el tipo de tarea, la situación inicial, el cambio de harness probado, la evidencia observada y los posibles efectos adversos. Conviene conservar fecha y versión de las herramientas porque un consejo válido para una release antigua puede caducar.
Un segundo mecanismo debería detectar conflictos. Si dos lecciones recomiendan comportamientos opuestos, la decisión no se resuelve concatenando ambas al system prompt. Se resuelve por alcance: cuál es aplicable a la tarea actual y cuál tiene mejor evidencia de resultados comparables.
También necesitamos retirar aprendizajes. Una memoria que solo crece puede empeorar el contexto, introducir contradicciones y encarecer cada ejecución. La automatización debería poder decir «esta regla ya no aporta valor» y proponer su eliminación, siempre con verificación posterior.
Caso práctico: una migración que parece correcta
Pensemos en una app que guarda preferencias en una base de datos local. El objetivo es introducir una nueva columna y mantener compatibilidad con instalaciones anteriores. El harness inicial explica cómo modificar el esquema, pero no insiste en probar una migración desde una versión antigua.
El primer candidato añade una instrucción genérica: «verifica las migraciones». El segundo añade una guía de herramientas con un comando específico para crear una base antigua y ejecutar la migración. El tercero propone reestructurar las capas de persistencia para facilitar pruebas futuras.
Es posible que el segundo encuentre una regresión que los demás ignoran. El tercero quizá produzca una arquitectura más limpia, pero toque demasiados archivos. La comparación debería registrar no solo si el último test pasa, sino el tamaño del diff, los riesgos creados, el tiempo invertido y si los datos antiguos sobreviven.
El aprendizaje correcto podría ser: cuando cambia el esquema, ejecutar una prueba de migración desde un estado real anterior. Esa regla no requiere almacenar secretos ni adoptar toda una arquitectura recursiva. Requiere capturar una buena experiencia y convertirla en una comprobación verificable.
Esta es la clase de caso donde Harness² puede inspirar una práctica más útil que una guía general de prompts: vincular cada consejo a una clase de fallo que queremos prevenir.
La diferencia entre explorar y explotar
Los sistemas de optimización tienen una tensión clásica. Explorar significa probar opciones nuevas que quizá funcionen mejor. Explotar significa utilizar lo que ya sabemos que suele rendir bien. Harness² plantea esa tensión cuando admite recursión paralela y secuencial y cuando conserva aprendizajes para tareas siguientes.
Explorar todas las variantes en cada pequeño bug puede ser desproporcionado. Explotar siempre el harness histórico puede impedir descubrir alternativas mejores. Para una app personal elegiría un criterio sencillo: pocas variantes para tareas corrientes y experimentación adicional solo cuando exista un fallo repetido o una tarea suficientemente importante.
También establecería presupuestos máximos. Tiempo, llamadas a herramientas, coste monetario y número de candidatos deben estar limitados antes de empezar. Si una variante necesita diez veces más recursos para aportar una mejora marginal, quizá no sea la decisión adecuada para uso cotidiano.
La flexibilidad del método no debe convertirse en una excusa para ejecutar indefinidamente hasta conseguir un resultado bonito.
La frontera entre archivos internos y publicaciones
Hay un detalle operativo particularmente relevante para proyectos web con repositorio privado y espejo público. El harness puede necesitar documentos internos, resultados de pruebas y ejemplos de configuración. Esos artefactos no deben publicarse solo porque el agente los haya creado.
El pipeline correcto prepara una distribución limpia a partir del repositorio de desarrollo. Los archivos de experimentación y la memoria de mejoras permanecen privados; la web pública recibe exclusivamente el contenido y los assets necesarios. Un sistema de auto-mejora debería respetar esta separación aunque modifique sus propias guías.
De hecho, el optimizador no debería poder cambiar la lista de exclusiones de publicación sin una revisión específica. Un cambio que mejora el rendimiento del agente pero filtra un archivo privado sería un fracaso inaceptable. Las comprobaciones de privacidad deben mantenerse fuera del alcance editable del harness candidato.
Qué experimento demostraría que merece la pena
Antes de adoptar Harness² en serio, me gustaría comparar tres enfoques sobre el mismo conjunto de tareas: un harness estático cuidadosamente escrito, una iteración manual con revisión humana y una versión asistida por optimización recursiva. La comparación debe medir el coste total de llegar a un cambio verificable, no solo la última ejecución ganadora.
También mediría cuánto tiempo humano exige preparar tareas, revisar variantes y depurar decisiones. Un proceso que ahorra tokens pero duplica el mantenimiento de su infraestructura no necesariamente mejora el trabajo de una sola persona.
Y observaría la evolución: ¿las mejoras adoptadas en la primera semana siguen ayudando en la cuarta? ¿Alguna regla empieza a perjudicar nuevas tareas? ¿Podemos revertirla sin perder los aprendizajes buenos? Ahí está la diferencia entre una demo fascinante y una herramienta que realmente quiero conservar.
Una mejora necesita fecha de caducidad
Hay un riesgo que no aparece en las tablas de benchmarks: las instrucciones que funcionaban ayer pueden caducar. Cambian las interfaces de herramientas, se deprecian comandos y evoluciona la arquitectura del proyecto. Una regla que nació para corregir una regresión puede empezar a provocar otras nuevas.
Por eso guardaría cada aprendizaje con fecha, versión de herramientas, tipo de tarea y evidencia. Ante una actualización relevante, revisaría las reglas afectadas. Y permitiría proponer su eliminación: una memoria que no puede olvidar acaba convirtiéndose en una colección de consejos contradictorios.
Tampoco entrenaría el proceso de mejora únicamente contra las mismas tareas conocidas. Reservaría algunos casos de aceptación que el optimizador no pudiera inspeccionar. Una mejora real tiene que generalizar a problemas nuevos y superar verificaciones independientes, no aprender detalles superficiales de un benchmark.
El presupuesto es igualmente importante. Fijaría máximos de tiempo, llamadas a herramientas, candidatos y coste antes de iniciar un experimento. Si la mejora no aparece dentro de esos límites, registrar que no ha sido concluyente es un resultado válido. No necesitamos explorar indefinidamente para justificar la existencia del optimizador.
Conclusión
Harness² no demuestra que debamos dejar que los agentes gobiernen sus propias reglas sin supervisión. Demuestra algo más acotado y útil: el harness es un objeto medible y optimizable, y los cambios pueden guiarse por ejecuciones contrastadas y lecciones persistentes.
Me quedo con la metodología antes que con la promesa de autonomía: versionar instrucciones, ensayar cambios, conservar evidencias, evaluar por separado y revertir cuando haga falta. Eso ya nos permite construir mejores agentes sin convertir cada proyecto en un laboratorio de infraestructura.
Referencias
- Harness² — paper en arXiv.
- Harness² — repositorio oficial.
- Harness Engineering: el wrapper que gana.
- DeepSeek Harness: todo es un plugin.
- DeepSeek Harness Desktop.
¿Qué mejora medirías primero en tu harness? Yo elegiría una que ya esté produciendo errores reales, no la que suene más avanzada.
También te puede interesar
HybridAgents: razonar en latente y actuar con herramientas
Explora Hybrid Reasoning Agents: cómo combina razonamiento latente, memoria continua y herramientas, qué demuestra el paper y qué falta por validar.

DeepSeek Harness Desktop: análisis de su app
Descubre DeepSeek Harness Desktop: instalación, plugins, automatización, seguridad y límites reales de su nueva aplicación para agentes de IA.
DeepSeek Harness: el runtime donde todo es un plugin
DeepSeek Harness (dsh) es un runtime open-source MIT donde modelo, herramientas, sesión, sandbox e incluso el loop son plugins. Análisis en profundidad: Cordis, modos, sesión append-only y self-evolution.