
Índice de contenidos
Una clasificación de memoria puede decir menos de lo que parece
Comparar sistemas de memoria para agentes parece sencillo. Alguien toma varias herramientas, formula preguntas sobre conversaciones antiguas, cuenta las respuestas acertadas y ordena los resultados de mayor a menor. La tabla final cabe en una captura de pantalla. El problema es que una tabla puede esconder casi todo lo que determina si el experimento es útil.
¿Se evaluó la recuperación de información o la respuesta final generada por un modelo? ¿Qué historia recibió cada sistema? ¿Se permitió modificar la configuración? ¿Se contabilizó la ingestión de las conversaciones? ¿El juez aceptaba respuestas equivalentes? ¿Cuántas preguntas había? ¿Era una tarea de recordar un dato reciente o una decisión corregida meses después?
Estas preguntas importan mucho más que un decimal. En ArceApps ya analicé Mem0 y Letta como stack y la arquitectura de memoria persistente. Aquí quiero cambiar la conversación: en lugar de preguntar qué producto ofrece más funciones, voy a revisar qué nos permiten inferir dos benchmarks abiertos de septiembre de 2026, dónde discrepan y por qué no sería correcto fundir sus números en un ranking universal.
Las dos fuentes principales son agent-memory-bench, de hamza-dev-tech, y agent-memory-benchmark, de Datapace. Ambos publican código y metodología, pero tienen condiciones muy distintas. Esa diferencia es una virtud para aprender, siempre que no finjamos que miden exactamente lo mismo.
Antes de medir: ¿qué hace «recordar bien»?
Un agente puede almacenar el historial completo y seguir respondiendo mal porque no encuentra la evidencia. También puede recuperar la frase correcta y generar una respuesta equivocada. Hay por tanto al menos tres etapas distintas: escritura de memoria, recuperación y uso de lo recuperado al responder.
En la escritura se decide qué guardar, qué condensar y cómo representar relaciones. En recuperación, el sistema busca los fragmentos adecuados para la consulta. En la respuesta, un modelo interpreta esos fragmentos y produce algo que debe ser evaluado. No conviene atribuir automáticamente un fallo de la tercera etapa a la segunda.
Una memoria útil también debe gestionar cambios. Si el usuario dijo en enero que prefiere una biblioteca y en marzo la sustituyó por otra, responder con la preferencia de enero no es «recordar» bien: es recuperar un hecho verdadero en su contexto histórico pero inválido como decisión actual. En agentes de programación ese detalle puede convertir una respuesta plausible en una regresión.
Hay preguntas multi-hop, que exigen combinar varias sesiones, y preguntas sin respuesta, para las que el comportamiento correcto es reconocer la falta de evidencia. Un benchmark que premie cualquier respuesta, aunque inventada, puede producir incentivos peligrosos. Para mí, rechazar una pregunta imposible es una capacidad positiva.
Por último, los sistemas no tienen la misma unidad arquitectónica. Mem0 puede actuar como capa de memoria dentro de una aplicación; Letta gestiona un agente con un modelo de memoria propio; Graphiti utiliza relaciones temporales y grafos; LangMem ofrece utilidades integrables con LangGraph. Una evaluación justa necesita declarar qué parte de cada sistema se está comparando.
Primer benchmark: agent-memory-bench y sus seis configuraciones
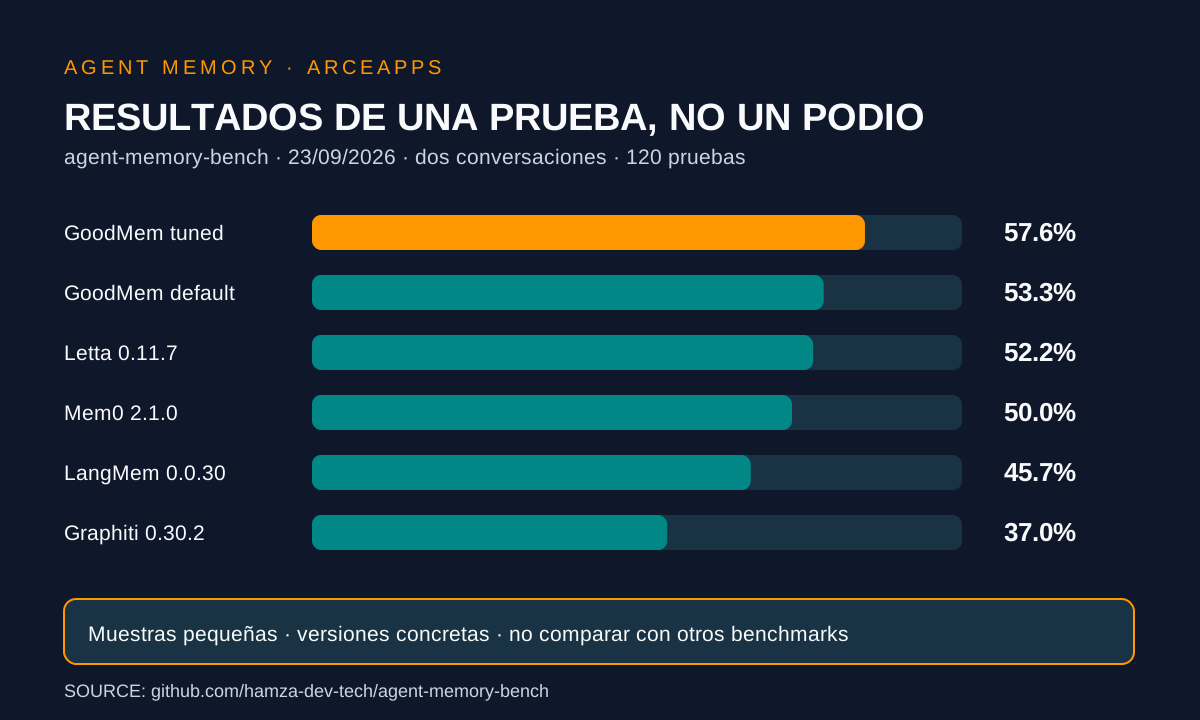
El repositorio de hamza-dev-tech describe una evaluación reproducible basada en conversaciones largas. Publica resultados de una ejecución del 23 de septiembre de 2026 con 419 turnos, 120 preguntas de prueba y dos conversaciones. El resumen del README menciona gpt-4o-mini con temperatura 0, pero su sección «Models» cita gpt-oss-120b servido por Groq. Esta inconsistencia documental impide asegurar cuál se utilizó en esa ejecución sin comprobar el manifiesto de resultados; sí se describe un modelo común de respuesta y un máximo de diez elementos recuperados por consulta.
Además de memoria, el estudio registra comportamiento ante preguntas adversariales sin respuesta, latencia de búsqueda, volumen de tokens recuperados y duración de ingestión por turno. Utiliza tanto coincidencia normalizada como un juez LLM para aceptar respuestas equivalentes, con revisión de discrepancias en un archivo específico.
La tabla publicada es instructiva, siempre que conservemos el contexto:
| Configuración | Recuerdo | Rechazo adversarial | Búsqueda p50 |
|---|---|---|---|
| GoodMem, ajustado por proveedor | 57,6 % | 82,1 % | 754 ms |
| GoodMem, valores por defecto | 53,3 % | 92,9 % | 633 ms |
| Letta 0.11.7 | 52,2 % | 92,9 % | 318 ms |
| Mem0 2.1.0 | 50,0 % | 92,9 % | 38 ms |
| LangMem 0.0.30 | 45,7 % | 85,7 % | 68 ms |
| Zep/Graphiti 0.30.2 | 37,0 % | 92,9 % | 163 ms |
No son puntuaciones universales de calidad. Son resultados de estas versiones y este conjunto de tareas. En particular, la diferencia de pocos puntos entre dos posiciones no debería tratarse como una victoria estadística concluyente con solo dos conversaciones.
Las velocidades tampoco representan un SLA comparable de todos los productos. El propio autor advierte de la distancia de red desde Pakistán a servicios alojados, mientras otras configuraciones son locales. Un p50 en esas condiciones mezcla arquitectura, red y despliegue.
Qué mide el benchmark y qué deja fuera
La metodología intenta evaluar la recuperación en un entorno común. Eso ayuda a observar si el sistema trae evidencia apropiada, pero una política fija de «top 10 resultados» puede favorecer una arquitectura y perjudicar otra. Hay productos diseñados para devolver pocos recuerdos condensados y otros que recuperan episodios más grandes.
Las memorias se crean a través de adaptadores que implementan operaciones comunes de reinicio, escritura, vaciado y búsqueda. Los adaptadores son deliberadamente pequeños, para evitar que cada producto reciba una estrategia de orquestación personalizada. Es una decisión defendible para comparación, aunque puede impedir que algunos sistemas aprovechen todo su potencial.
La versión configurada por un proveedor merece atención: GoodMem ajustado obtiene una cifra más alta en recuerdo que su modo por defecto, pero también cambia su comportamiento frente a preguntas adversariales. Esta es una demostración práctica de que configuración y tarea importan. No sería honesto publicar solo la configuración favorable y ocultar el resto de columnas.
El proyecto explica que las cifras promocionales de otros trabajos pueden estar muy por encima de las medidas aquí. Eso no prueba por sí solo que esas cifras sean falsas. Pueden usar otras muestras, otras reglas de evaluación, más contexto o un modelo diferente. La conclusión correcta es que deben compararse protocolos, no porcentajes aislados.
Una prueba reproducible ofrece código y parámetros. No convierte automáticamente una muestra pequeña en representativa de todos los usos profesionales o personales. Reproducción y generalización son propiedades diferentes.
Segundo benchmark: Datapace y un piloto deliberadamente pequeño
El repositorio de Datapace se presenta como un benchmark neutral entre proveedores con memoria y baselines sin un producto especializado. Su piloto del 7 de septiembre de 2026 utiliza solo diez preguntas de LongMemEval, una semilla y un historial de doce sesiones. El objetivo es comparar respuestas usando un mismo modelo local o gratuito, manteniendo la ingestión cronológica.
El trabajo resulta interesante por su selección de baselines: además de herramientas de memoria, incorpora un oracle que solo ve sesiones con evidencia, una ventana deslizante de 32k tokens y un agente que busca en archivos fechados. Ese último caso es crucial. Muchas evaluaciones omiten soluciones sencillas como archivos y grep, de modo que nunca demuestran si la nueva infraestructura realmente aporta valor sobre la alternativa más barata.
El informe registra, para una configuración concreta con Ling 3.0 Flash, un 90 sobre 100 para el oracle, 80 para dos baselines y 70 para Mem0 y LangMem. También observa que las herramientas de memoria pueden utilizar entre diez y cincuenta veces menos tokens de prompt por respuesta que ciertos baselines del piloto.
La lectura responsable es estrecha: diez preguntas y una sola semilla no bastan para establecer un ranking sólido. Una diferencia de una pregunta cambia diez puntos. Algunas combinaciones de modelo y sistema tampoco podían ejecutarse bajo los mismos requisitos, lo que introduce huecos en el diseño comparativo. Es mejor presentarlo como una demostración metodológica y una hipótesis para ampliar.
El resultado de los archivos es especialmente útil: obliga a preguntarse qué estamos comprando al añadir memoria semántica. Tal vez obtenemos una reducción de contexto; tal vez perdemos detalles que grep habría encontrado; tal vez el modelo de respuesta limita más que el sistema de memoria. Son preguntas de diseño, no eslóganes.
Los dos resultados no forman una sola liga
Sería tentador dibujar una tabla combinada y declarar ganador al producto con mayor porcentaje. Eso sería incorrecto. Los estudios tienen distintos conjuntos de preguntas, tamaños muestrales, modelos de respuesta, criterios de normalización, versiones de herramientas, políticas de ingestión y baselines.
Ni siquiera «accuracy» significa exactamente lo mismo cuando una evaluación valora la memoria recuperada y otra la respuesta final. Un sistema que recupera un fragmento correcto puede fracasar al responder si el modelo lo interpreta mal. Otro que devuelve menos evidencias puede acertar por conocimientos previos del modelo o pistas de la pregunta. La segunda evaluación no separa necesariamente esos mecanismos.
La latencia ofrece otro ejemplo. En un benchmark puede medirse solo búsqueda; en otro se informa latencia total incluyendo generación. Sumarlas o confrontarlas sin etiquetas equivale a comparar el tiempo que tarda una base de datos en devolver filas con el tiempo total de una aplicación en dibujar la pantalla.
Tampoco todas las configuraciones son representativas de producción. Algunos productos exigen servidores, modelos auxiliares, almacenamiento especializado o ajuste de índices. Una instalación por defecto puede ser una referencia honesta, pero no siempre la mejor implementación alcanzable.
Por eso defiendo dos tablas separadas, con sus protocolos al lado. La disciplina de no mezclar cifras es más valiosa que elegir rápidamente una marca.
Rechazar preguntas sin respuesta es parte de recordar
Un agente que siempre produce una respuesta puede parecer competente hasta que se enfrenta a una pregunta para la que sus memorias no contienen evidencia. En un asistente personal esto deriva en preferencias inventadas; en programación, en decisiones arquitectónicas falsas o instrucciones sobre dependencias que nunca existieron.
El primer benchmark incluye preguntas adversariales sin respuesta y registra qué porcentaje fue correctamente rechazado. Es un buen contrapeso a la simple métrica de recuerdo. Una memoria muy agresiva puede recuperar algo superficialmente parecido y animar al modelo a completar las lagunas.
Una evaluación más completa distinguiría: recuperación de evidencia correcta, omisión de evidencia necesaria, recuperación de contenido contradictorio y respuesta no fundamentada. También separaría desconocimiento legítimo de error de búsqueda. Si el documento correcto no está en el almacén, la responsabilidad puede estar en ingestión; si está pero no aparece, en recuperación; si aparece y el modelo inventa, en la etapa de uso.
Para elegir una herramienta, miraría especialmente qué ocurre cuando una decisión cambia. Un sistema que recuerda un valor obsoleto con mucha seguridad es peligroso incluso si tiene un porcentaje alto de respuestas consideradas correctas en preguntas estáticas.
La curva del olvido y los hechos que se sustituyen
Las conversaciones largas no son solo más texto. Contienen evolución temporal. Una preferencia inicialmente válida puede ser corregida. Una versión de librería cambia. Un proyecto pasa de usar un proveedor a otro. Un sistema de memoria necesita saber qué información se sustituyó y qué información sigue vigente.
Datapace incluye entre las dimensiones que pretende medir la degradación según la distancia a la evidencia y el retorno de valores ya reemplazados. Me parecen dos preguntas importantes para flujos reales de desarrollo. Un benchmark que pregunta «¿qué dije ayer?» no evalúa necesariamente «¿cuál es la decisión actual después de tres correcciones?».
Los grafos temporales pueden representar relaciones y cambios de validez, pero necesitan ingestión y consultas correctas. Los sistemas de memorias condensadas pueden actualizar hechos sin conservar toda la historia. Los archivos fechados guardan la secuencia de forma muy legible, aunque obligan a interpretar cuál es la última decisión. No existe solución gratuita de compromisos.
Para experimentar prepararía historias con hechos que cambian dos veces, referencias a versiones y decisiones explícitamente revocadas. Las preguntas deberían distinguir «¿qué se decidió en mayo?» de «¿qué decisión está vigente?». Un sistema que responde igual a ambas todavía tiene un problema temporal.
La evaluación debería conservar fuentes y fechas, porque muchas respuestas sin ellas son imposibles de verificar.
Coste: separar lectura, escritura y mantenimiento
Un producto puede recuperar recuerdos rápidamente y tardar mucho en ingerir cada turno. Otro puede ingerir casi sin procesamiento y necesitar una etapa de razonamiento costosa al buscar. Comparar solo latencia de lectura favorece a sistemas que desplazan trabajo a la escritura, y comparar solo ingestión favorece a los que lo hacen en consulta.
En agent-memory-bench se publican ambas dimensiones. Por ejemplo, Mem0 muestra búsqueda p50 de 38 ms en las condiciones reportadas, pero ingestión por turno de 1,52 segundos; LangMem, 68 ms y 4,15 segundos; Letta, 318 ms y 0,37 segundos. No extrapolaría esos tiempos a otro hardware o servicio. Sirven para ilustrar que los perfiles de coste son muy diferentes.
También cuenta la extracción mediante LLM, generación de embeddings, almacenamiento vectorial o de grafos, actualización de índices y reingestión tras cambiar modelos. Cuando un agente trabaja varias horas al día, el coste acumulado de mantener la memoria puede ser superior al de algunas consultas.
Haría cuatro presupuestos separados: ingestión inicial, actualización incremental, búsqueda y restauración/migración. Solo entonces los agregaría para un patrón de uso definido. El coste por respuesta no puede interpretarse sin saber cuántas sesiones se guardaron y durante cuánto tiempo.
Calidad de los datos: el problema anterior a cualquier algoritmo
Un benchmark puede ser reproducible y aun así describir un mundo muy distinto de nuestro proyecto. Los diálogos sintéticos simplifican la complejidad de conversaciones reales. Los usuarios cambian de tema, corrigen frases, escriben abreviaturas, mezclan idiomas y suponen cosas que nunca han dicho explícitamente.
El repositorio de Hamza reconoce que LoCoMo es una colección sintética con edición humana. Eso no la invalida: una colección controlada permite comparar sistemas. Pero obliga a comprobar resultados con un segundo conjunto representativo antes de inferir que una herramienta funcionará igual sobre repositorios de software o notas personales.
Para una aplicación de desarrollo indie, crearía un conjunto pequeño de preguntas procedentes de decisiones reales debidamente anonimizadas y revisadas, no un volcado de conversaciones privadas. Incluiría cuestiones sobre herramientas instaladas, requisitos confirmados, alternativas descartadas y cambios de arquitectura.
Las respuestas esperadas deberían estar respaldadas por archivos verificables, con fecha y estado de decisión. Así el benchmark no termina premiando recordar una frase que parecía una decisión pero era solo una propuesta.
La gestión de datos personales es parte del experimento: si el conjunto no se puede compartir legalmente, la documentación de resultados debe permitir auditar al menos el protocolo sin exponer contenidos.
El juez LLM también puede equivocarse
Muchos benchmarks usan un modelo como juez porque las respuestas equivalentes pueden tener distinto formato. «El 3 de mayo» y «2026-05-03» dicen lo mismo; una comparación literal fallaría. Un juez puede corregir ese problema, pero introduce sus propios criterios y sesgos.
Es importante fijar modelo, temperatura, prompt de evaluación y reglas de aceptación. Conviene conservar discrepancias entre coincidencia exacta y juez, y revisar manualmente una muestra. El primer benchmark publica un archivo de casos discrepantes para revisión, un detalle que mejora la transparencia.
Una respuesta puede mencionar el hecho correcto junto a otro falso. ¿Se considera válida? ¿Y una respuesta parcialmente correcta que omite la condición temporal? Sin reglas explícitas, el porcentaje final depende tanto del juez como del sistema de memoria.
En casos de seguridad o privacidad no basta la evaluación semántica general. Si la memoria devuelve datos de otro usuario, el fallo existe aunque la respuesta al enunciado sea literalmente acertada. Hay criterios de corrección que no pueden reducirse a similitud textual.
La mejor métrica es la que sabemos interpretar; la peor es la que parece precisa porque tiene una cifra con un decimal.
Cómo diseñaría una comparación útil en ArceApps
Mi protocolo tendría un conjunto de tareas común y varias categorías: recuperación literal, hechos corregidos, preguntas multi-sesión, ausencia de evidencia, razonamiento sobre dos fuentes y recuperación de decisiones de un proyecto. Congelaría versiones, modelos, infraestructura y conjuntos de datos. La misma información entraría en cada sistema siguiendo el orden temporal.
Definiría dos experimentos relacionados pero separados. El primero mediría retrieval: qué evidencia aparece en el contexto final, con precisión y cobertura. El segundo mediría answering con un modelo fijo: qué respuesta produce a partir de esa evidencia. Así podría distinguir un buscador pobre de un generador que no utiliza correctamente buenos fragmentos.
Usaría como baselines archivos fechados con búsqueda textual, una ventana reciente y un oracle de evidencia. Mediría tokens, latencia, ingestión, tiempo de actualización y capacidad de restauración. Registraría los rechazos correctos de preguntas imposibles y los errores de recuperación fuera de ámbito.
Repetiría las ejecuciones con varias semillas y conjuntos separados, si el coste lo permite. Publicaría el número real de muestras, desviaciones y configuración, nunca un ranking descontextualizado. También revisaría algunas trayectorias incorrectas para entender si el problema es temporal, semántico o de extracción.
Este es un protocolo propuesto, no un experimento propio ya realizado. Es la diferencia entre una recomendación basada en evidencias ajenas y una promesa de rendimiento que no puedo respaldar.
Qué herramienta elegir según el problema
Si lo principal es extraer y actualizar hechos breves de sesiones, Mem0 merece una evaluación práctica. Si quieres un agente con memoria integrada en su modo de funcionamiento, Letta ofrece una perspectiva diferente. Si las relaciones temporales y entidades son centrales, Graphiti puede ser pertinente. Si ya trabajas con LangGraph, LangMem puede encajar con menos cambios conceptuales.
Pero esas son hipótesis de elección, no un ranking. Antes de añadir cualquiera probaría la solución más simple que pueda cumplir el contrato: Markdown versionado, búsqueda local, enlaces a decisiones y un mecanismo de revisión. La complejidad adicional solo se justifica si mejora la recuperación, el mantenimiento o la utilidad real de los agentes.
El resultado de Datapace nos recuerda que los archivos pueden funcionar sorprendentemente bien; el de Hamza, que configuraciones y costes operativos cambian mucho las comparaciones. Ninguno permite afirmar que el producto que aparece primero sea la mejor opción universal.
Quien use memoria en producción debería priorizar también exportación, control de acceso, borrado, observabilidad y recuperación tras fallos. Una mejora marginal en una métrica de recuerdo no compensa necesariamente una pérdida de control sobre datos importantes.
Conclusiones: elegir por evidencia, no por un podio
La conclusión más valiosa de esta investigación no es «gana X». Es que una memoria para agentes debe evaluarse en varias dimensiones y con baselines honestos. Recuperar, contestar, reconocer desconocimiento, actualizar hechos, proteger ámbitos y controlar costes son capacidades distintas.
Los dos proyectos abiertos son útiles precisamente porque publican métodos, configuraciones y limitaciones. Merece la pena reproducirlos, cuestionarlos y ampliarlos. La comparación responsable conserva sus condiciones originales en lugar de transformar resultados pequeños en proclamaciones comerciales.
En el blog de ArceApps seguiré prefiriendo una arquitectura que pueda explicar y verificar a una solución que solo presuma de un porcentaje. Cuando un agente tiene que recordar por qué descarté una opción, lo importante no es que lo haga rápido: es que recuerde la decisión correcta, su contexto y su fuente.
Bibliografía y recursos
- agent-memory-bench, datos y protocolo de la ejecución del 23/09/2026.
- agent-memory-benchmark de Datapace, código y escenarios.
- Resultados piloto Datapace, diez preguntas y una semilla.
- Mem0, proyecto de referencia.
- Letta, agente y memoria.
- Graphiti, grafo temporal.
- LangMem, integración con LangGraph.
- En ArceApps: Mem0 y Letta, Graphicle y memoria persistente.
Cierre. Antes de fiarte de un porcentaje, pregunta qué recuerda, cuándo lo recuerda, cómo se juzga y qué pasa cuando el dato cambia. Esa conversación será más provechosa que celebrar al ganador de la próxima tabla.
También te puede interesar
Mem0 y MemGPT: Stack de Memoria Cognitiva para Agentes IA
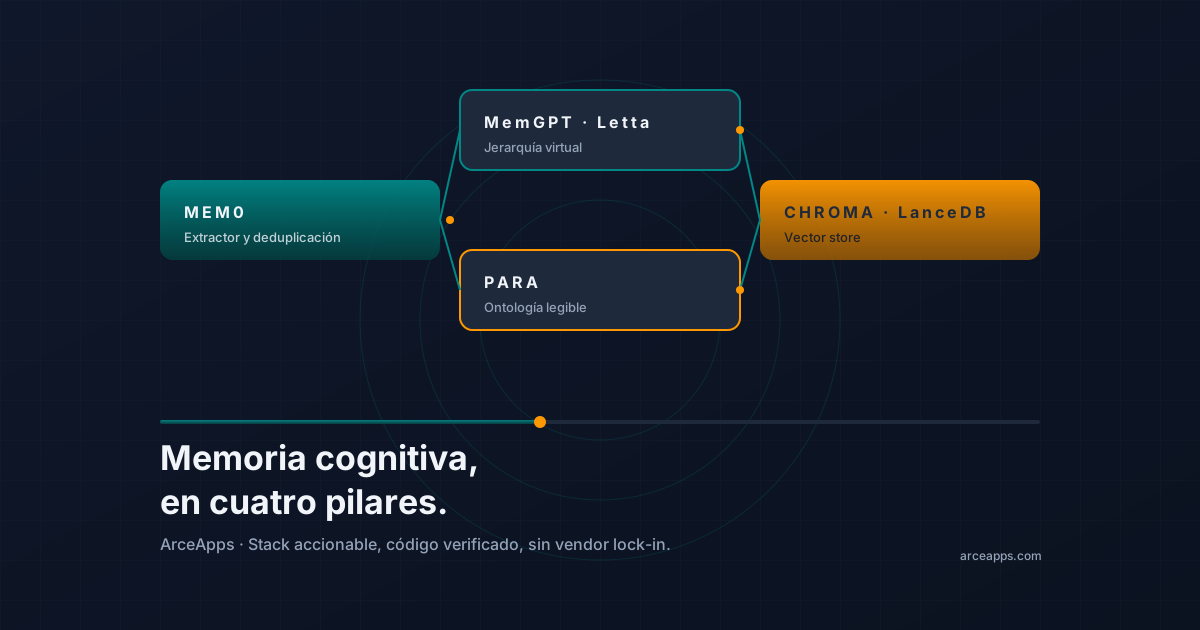
Construye un stack de memoria cognitiva para agentes IA con Mem0, MemGPT/Letta, PARA y Chroma o LanceDB. Arquitectura accionable con código.
AgentMemRec: memoria IA como sistema de recomendaciones
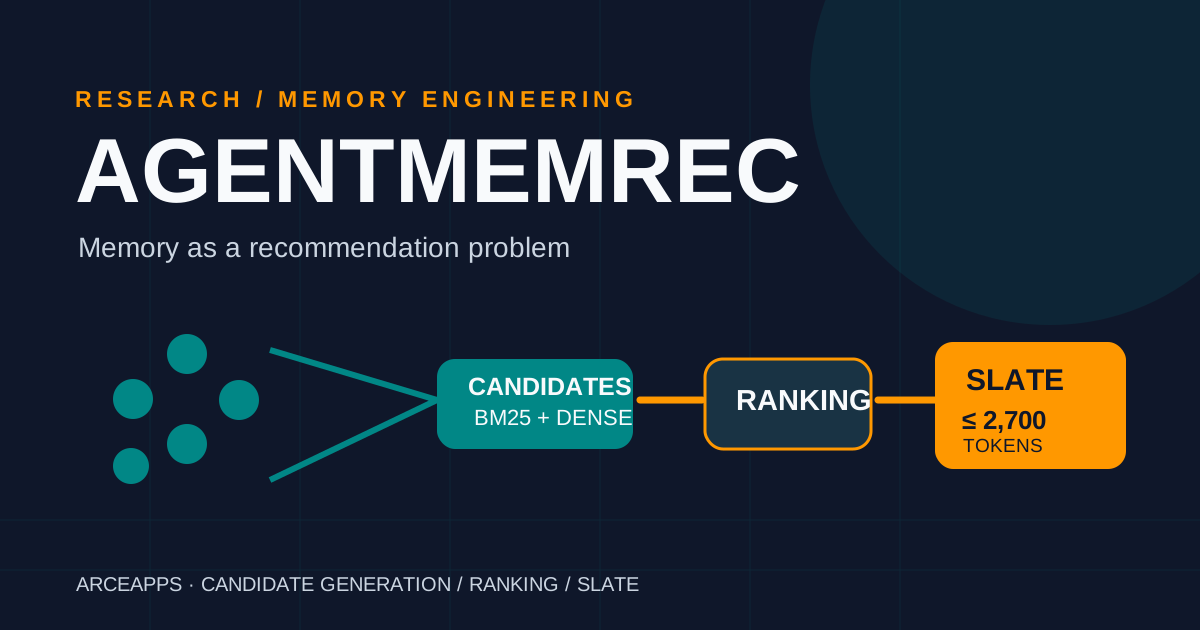
Analiza AgentMemRec, la propuesta para seleccionar recuerdos con BM25, ranking y presupuestos de contexto sin llamadas LLM durante la recuperación.
Graphicle: grafo de código y memoria para agentes IA
Descubre cómo Graphicle conecta código, documentación y memoria para agentes IA; analizamos su arquitectura, privacidad, benchmarks y alternativas.