
OpenClaw 2.0: un Gateway fiable y seguro
Índice de contenidos
Lectura relacionada: en ArceApps ya hemos comparado Hermes Agent y OpenClaw y presentado un stack básico de agentes autónomos. Este artículo cubre otro problema: qué hace falta para mantener un OpenClaw instalado y accesible cada día, no solo para conseguir que arranque una vez.
El día que el agente que debía arreglarlo todo dejó de arrancar
Hay una paradoja especialmente desagradable en los agentes personales persistentes: cuando funcionan, pueden diagnosticar errores, editar archivos y automatizar reparaciones; cuando falla el proceso que los aloja, desaparece precisamente la herramienta que íbamos a utilizar para recuperarlos. Una sesión bonita, una memoria extensa y decenas de plugins sirven de poco si el Gateway no consigue arrancar después de actualizarse.
Esta no es una preocupación imaginaria. En septiembre de 2026, OpenClaw reconoció públicamente que las actualizaciones estaban rompiendo configuraciones y dejando usuarios sin agente operativo. En su artículo «Shipping OpenClaw updates that don’t break», Jason Sy explica que el salto a la generación 2.0 volvió ese problema demasiado visible como para seguir posponiéndolo. La solución que el proyecto empezó a desplegar se denomina atomic updates.
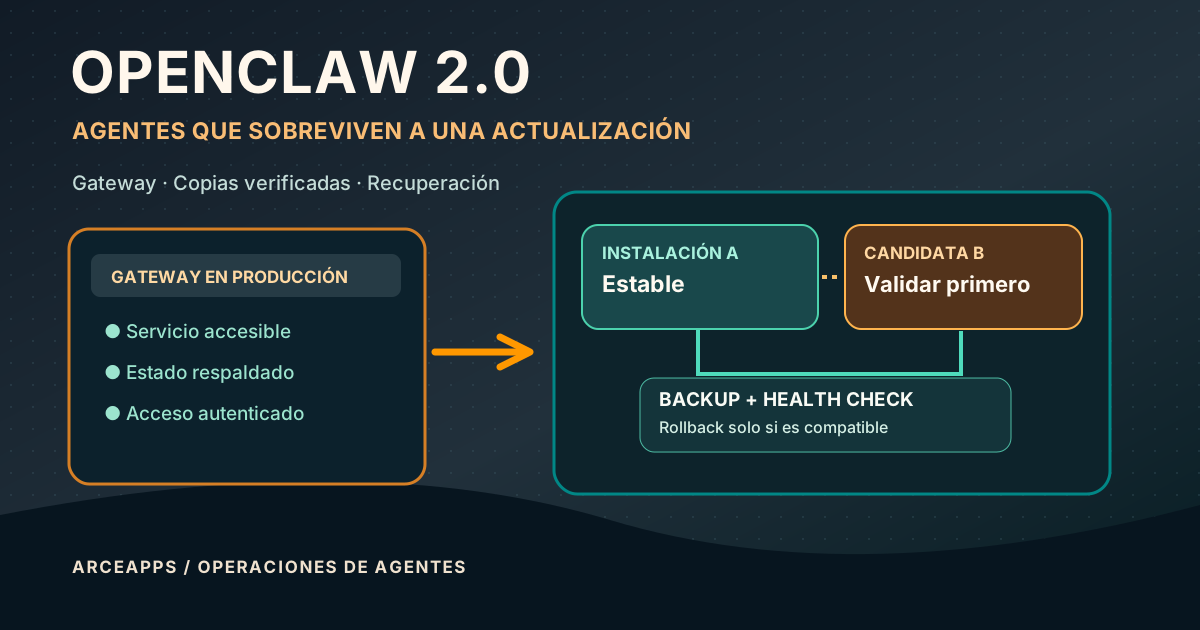
El término suena a garantía absoluta. No lo es. Su propuesta es mantener viva la versión actual mientras se prepara y valida una candidata, cambiar a esta última solo cuando sea admisible y recuperar el estado anterior si el fallo y la compatibilidad lo permiten. Las migraciones de bases de datos, las configuraciones obsoletas y los estados parciales siguen complicando las restauraciones.
Por eso este artículo no trata de instalar cinco plugins nuevos. Trata de ingeniería operativa para un desarrollador independiente: límites de confianza, copias, servicios, actualizaciones, acceso remoto y un protocolo de verificación que deja claro qué sabemos y qué aún no hemos probado.
Qué significa realmente «OpenClaw 2.0»
Conviene separar la generación del producto de su numeración de release. La conversación pública utiliza «2.0» para describir una revisión mayor del runtime y de su operación, mientras que las versiones oficiales distribuidas durante septiembre aparecen con fechas como 2026.9.3, 2026.9.5, 2026.9.7 y 2026.9.8. Al escribir un procedimiento de actualización importa mucho más el identificador real instalado que la etiqueta comercial.
La lista oficial de notas de versión permite seguir la evolución: mejor recuperación de actualizaciones, nuevas vistas para plugins y skills, recarga de determinadas extensiones sin reiniciar el Gateway, sesiones más resistentes y controles de seguridad. No conviene trasladar capacidades de una versión a otra por intuición. Un tutorial válido para 2026.9.5 podría no describir exactamente el estado de una instalación posterior.
OpenClaw tampoco es únicamente una interfaz de chat. Un Gateway gestiona conexiones, identidades, sesiones, capacidades y acceso a diferentes canales. Su configuración determina dónde escucha el servidor y cómo se autentican navegadores y clientes. Los plugins y skills añaden funciones; el modelo remoto o local es otra dependencia. Un fallo puede ocurrir en cualquiera de esas capas y no todos se reparan reinstalando el paquete.
La primera regla de diagnóstico es, por tanto, no cambiar varias capas a la vez. Hay que identificar la versión del binario, el usuario y directorio de estado que utiliza el proceso, el supervisor del servicio y la ruta de acceso de los clientes. Solo con ese inventario podemos decidir si el incidente es de instalación, migración, permisos, red o autenticación.
Arquitectura operativa: proceso, estado y cliente
En un mini PC Linux que sirve de host podemos pensar en tres piezas. Primera, el proceso Gateway que ejecuta el runtime y atiende conexiones; segunda, el estado persistente en disco, incluyendo configuración, bases de datos, sesiones y credenciales; tercera, los clientes de escritorio o móvil que se conectan al Gateway a través de una ruta de red autorizada.
Esto permite diferenciar incidentes. Si el proceso se cae pero la configuración y las bases de datos están intactas, reiniciar el servicio podría bastar. Si el proceso funciona pero el navegador no conecta, quizá hay un problema de Tailscale, proxy, origen o emparejamiento. Si la versión nueva ha migrado la base de datos a un esquema incompatible con el binario anterior, una reinstalación antigua puede producir una avería peor.
El puerto por defecto del Gateway es 18789, como confirma la referencia de configuración. Ese número no explica por sí mismo si el servicio es seguro: gateway.bind, el modo de autenticación y la exposición del host son los factores importantes. Un servicio escuchando en loopback y alcanzable mediante Tailscale Serve tiene un modelo de riesgo distinto de un puerto publicado en Internet.
Para una instalación personal, prefiero que el proceso tenga un supervisor claro, por ejemplo systemd cuando corresponde, y que la UI sea un cliente sustituible. Eso no exige montar una plataforma de observabilidad desproporcionada. Exige saber cómo consultar el servicio, dónde se guardan sus logs y qué comando debe detenerlo sin saltarse el ciclo de apagado del propio producto.
El error que los atomic updates intentan evitar
El patrón problemático de un actualizador ingenuo suele ser este: detener el servicio, reemplazar archivos, migrar estado, arrancar de nuevo y confiar en que todo funcione. Si el paquete quedó incompleto, se perdió una dependencia o un fichero tiene un formato no esperado, la herramienta ya no está disponible para informar y ayudar a recuperar la instalación.
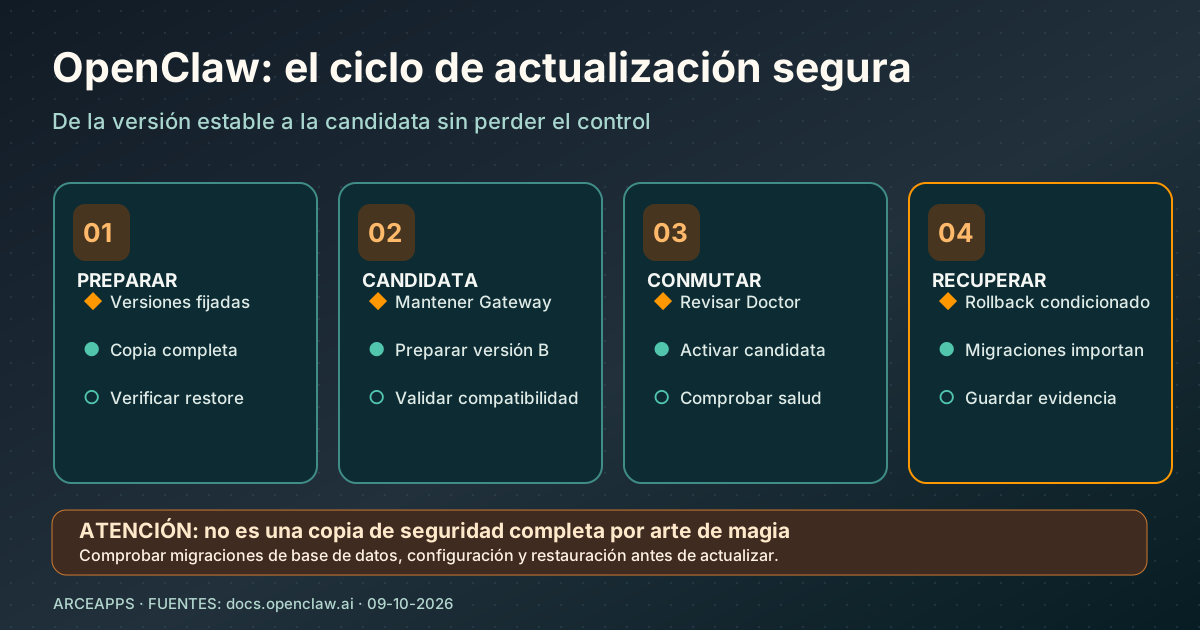
OpenClaw describe un orden diferente: mantener el Gateway anterior en funcionamiento mientras se prepara una versión candidata, validar las condiciones de admisión y activar el nuevo árbol solo cuando corresponda. Si la actualización no es válida y el estado sigue siendo compatible, se restaura el conjunto previo. El sistema incorpora también mecanismos de diagnóstico e informe de fallos para no depender exclusivamente de intuiciones.
Es importante hablar de condiciones y no de magia. Que una actualización sea «atómica» no convierte en reversibles las escrituras externas, las acciones ya ejecutadas por plugins o las migraciones incompatibles realizadas por procesos que siguieron vivos. Tampoco reconstruye archivos que nunca fueron incluidos en una copia. El propio equipo ha advertido que aún existen combinaciones de configuración que fallan.
Para comprender el cambio, imagina dos instalaciones: A funciona y B es la candidata. Primero verificamos el estado que B necesita, construimos la candidata y ensayamos sus comprobaciones. Después cambiamos el punto de entrada de A a B. Si B falla antes de activar cambios incompatibles, puede volver A. Si una base de datos avanzó de esquema y A ya no sabe leerla, el rollback requiere además un punto de restauración verificado del estado correspondiente, no solo copiar de vuelta la carpeta del programa.
Copias verificadas: la diferencia entre tranquilidad y recuperación
La guía oficial de actualización es explícita: una copia automática de la configuración no constituye una copia de seguridad completa del estado. Un agente guarda información que no vive necesariamente en un solo JSON: historiales, bases de datos, memoria, credenciales, índices, plugins y datos de canales pueden existir en lugares diferentes.
Por eso una copia utilizable necesita tres propiedades. Integridad: todos los archivos esperados están presentes. Coherencia: las bases de datos se capturaron en un estado que puede restaurarse, idealmente con el servicio detenido o mediante un procedimiento consistente admitido oficialmente. Comprobabilidad: podemos verificar el archivo y demostrar que el estado se recupera en un entorno aislado.
Una estrategia de ingeniería razonable registra versión, ruta de estado, tipo de instalación, configuración efectiva y supervisor; crea un respaldo según la documentación de la versión; verifica que el respaldo contiene las bases descubiertas; y ensaya la restauración cuando el riesgo lo justifica. Guardar un ZIP y asumir que sirve no es verificación.
Además hay un problema temporal. Si el servicio continuó aceptando mensajes y escribiendo resultados después de realizar el respaldo, restaurarlo supone perder esos cambios posteriores. Esa pérdida puede ser aceptable para un laboratorio y crítica para una automatización real. El diseño de la recuperación debe indicar explícitamente desde qué momento se restaurará y cuál es el impacto esperado.
Doctor: un migrador y validador, no una solución universal
El comando openclaw doctor suele aparecer en cualquier conversación de mantenimiento de OpenClaw, y con razón. Es la herramienta de diagnóstico para configuración, estado antiguo, autenticación de modelos, plugins y aspectos de preparación del Gateway. Con —fix puede aplicar determinadas reparaciones y migraciones soportadas. Ese poder requiere tratarlo como una operación con efectos persistentes.
La documentación de migraciones de configuración y estado y sesiones explica que algunos formatos antiguos se han retirado. Los archivos cuya versión de origen queda fuera de la ventana de migración no se convierten automáticamente; en muchos casos Doctor conserva los originales y pide pasar por una release intermedia compatible.
Es una política sensata, porque intentar adivinar cómo migrar un formato no soportado puede destruir información. Pero obliga a revisar cuidadosamente el informe antes de pulsar «arreglar todo». Una recomendación concreta en esas guías es utilizar 2026.9.5 o 2026.9.7 como versiones puente para determinados estados antiguos, ejecutar Doctor allí y después actualizar al destino, siguiendo el caso exacto.
El detalle clave es no ejecutar una versión antigua directamente contra una base de datos escrita por otra más nueva sin comprobar compatibilidad. Un downgrade de binario y una restauración de datos son operaciones diferentes. Si se confunden, el primer intento de recuperación puede invalidar el segundo.
Preparación de una actualización con un checklist mínimo
Antes de tocar el paquete haría una fotografía textual del entorno. No hace falta un script de cien líneas: basta con registrar la versión que está ejecutando el Gateway, el usuario propietario de los procesos, la ruta de estado y configuración, y el estado del servicio supervisor. También comprobaría qué clientes dependen de él y si hay tareas largas activas.
Comandos de solo lectura útiles, según tipo de instalación:
openclaw --version
openclaw gateway status --deep
openclaw doctor
En una instalación administrada por systemd pueden ser útiles systemctl —user status y journalctl —user; no son un sustituto del diagnóstico de OpenClaw ni sirven en todos los entornos. Conviene observar el proceso realmente instalado y evitar cambiar a la fuerza el puerto, la carpeta de estado o el usuario ejecutor como parte del upgrade.
A continuación vendrían la copia completa verificada, la revisión de notas de versión y la confirmación del camino de reversión. Si una actualización exige migrar archivos antiguos mediante una versión puente, esa migración debe convertirse en una tarea explícita. El orden importa: respaldo, comprobación, transformación, comprobación posterior y solo entonces activación.
No ejecutaría todos los comandos destructivos de una guía copiada sin leer su condición de aplicación. En particular, cambiar gestores de paquetes a mitad de camino —npm frente a pnpm o Bun— puede dejar instalaciones duplicadas y hacer que un servicio ejecute un binario diferente al que muestra nuestra shell.
Actualizar sin olvidar quién es dueño del servicio
OpenClaw puede instalarse mediante npm, pnpm, Bun u otros empaquetados, pero el propietario del proceso debe quedar claro. La guía de updating distingue un Gateway administrado por el CLI de otro levantado por un supervisor externo. Detener el servicio incorrecto y reemplazar un paquete distinto es una receta clásica para terminar con dos versiones.
Para un Gateway administrado por OpenClaw, la documentación incluye comandos como openclaw gateway stop, openclaw doctor —fix, openclaw gateway start y openclaw gateway status —deep como parte de procedimientos concretos. No deben ejecutarse indiscriminadamente ni tratarse como una receta universal. Un proceso propio de systemd, un contenedor o un host remoto puede tener otro contrato de arranque.
Después de la actualización comprobaría primero el binario usado por el servicio, no únicamente el que resuelve la terminal interactiva. Después observaría la salud del Gateway, la carga de plugins esenciales, el acceso desde un cliente y el comportamiento de una tarea mínima. Finalmente leería los informes del actualizador y confirmaría que no quedan snapshots retenidos por fallos pendientes.
La condición de éxito no es «el comando terminó con exit code cero». Es que el agente vuelve a aceptar conexiones sin perder el estado esperado ni ampliar permisos accidentalmente. Ese criterio es verificable y ofrece una definición de terminado mucho más útil.
Hot reload de plugins: menos cortes, no menos riesgo
La release 2026.9.5 anunció recarga en caliente para plugins compatibles. Esto permite instalar o recargar determinadas extensiones sin reiniciar completamente el Gateway. Para tareas de larga duración puede ser una mejora visible: se reduce la interrupción y no hace falta cerrar toda la conversación para modificar una parte del entorno.
Pero «hot reload» no significa que cualquier plugin pueda reemplazarse sin consecuencias. Un componente puede mantener conexiones, manejadores de eventos, estado interno o referencias persistentes. Si una actualización cambia su interfaz o sus datos, la carga en caliente puede necesitar límites y verificaciones específicos. Es prudente comprobar las notas de versión y las condiciones de compatibilidad del plugin concreto.
Hay otra implicación de seguridad: instalar código dinámico en un proceso con credenciales no equivale a instalar una extensión decorativa en un editor. Cada plugin habilitado puede ampliar capacidades. Eliminar un reinicio reduce fricción operativa, pero la validación del origen, permisos y dependencias sigue siendo necesaria.
En la práctica separaría plugins esenciales de experimentales. Los primeros se fijan, documentan y verifican después de cada actualización; los segundos se ensayan primero en un perfil o instancia aislada. La facilidad para cambiar piezas solo aporta fiabilidad cuando existe un inventario de cuáles eran las piezas correctas.
Tailscale Serve: acceso remoto sin abrir el puerto al mundo
Una ventaja de mantener el Gateway en un mini PC es poder utilizarlo desde otro ordenador o desde Android. Pero un proceso que escucha en 18789 no debería exponerse directamente a Internet. La documentación de Tailscale recomienda Serve para acceso privado a través de la tailnet, mientras que Funnel introduce una superficie pública que exige controles más estrictos.
El enfoque preferido es dejar el Gateway escuchando en loopback y utilizar la integración administrada de Tailscale Serve cuando corresponda. Esa integración puede verificar la identidad del nodo mediante Tailscale y hacer más cómodo el acceso a Control UI. Aun así, sigue existiendo una identidad de dispositivo y un proceso de emparejamiento para conexiones que lo necesitan; estar en la tailnet no equivale automáticamente a tener todos los permisos.
La configuración de ejemplo debe adaptarse a la instalación real. La referencia oficial distingue gateway.tailscale.mode: “serve” de gateway.bind, que son conceptos diferentes. No aconsejaría copiar una IP o un hostname ajeno ni cambiar a un bind público solo para superar un error de conexión. Primero verificamos la URL segura https:// o wss:// generada para el host y comprobamos los dispositivos autorizados.
Un acceso privado bien diseñado mantiene fuera del alcance público el puerto del Gateway, exige identidad y permite revocar nodos o credenciales. También evita convertir un cliente Android en razón para desactivar la autenticación del servidor. La comodidad de enlazar el móvil nunca compensa regalar control administrativo al primero que encuentre el endpoint.
Serve administrado frente a Serve externo: el error del proxy
Aquí existe una distinción técnica fácil de pasar por alto. OpenClaw puede gestionar su propio modo Tailscale Serve, pero también es posible configurar tailscale serve externamente para apuntar al listener normal. Aunque ambas rutas parezcan iguales desde el navegador, su contexto de confianza no es idéntico.
La documentación oficial advierte que un Serve externo se considera entrada mediante proxy genérico. Requiere definir con precisión la dirección de origen del proxy en gateway.trustedProxies y proporcionar una IP reenviada válida. Si faltan esos datos, las rutas protegidas pueden responder con proxy_attribution_required. No basta con que el navegador muestre el certificado de la tailnet.
Hay que evitar una solución peligrosa: añadir rangos amplios a trustedProxies o desactivar la autenticación hasta que desaparezca el mensaje. Ese ajuste define quién puede afirmar la dirección del cliente y, dependiendo del modo, puede participar en la frontera de autenticación. La cabecera X-Forwarded-For debe sobrescribirse correctamente; no debemos aceptar una cabecera arbitraria enviada por un cliente externo.
Para un uso personal, la alternativa más simple suele ser usar el Serve administrado por OpenClaw con la configuración recomendada. Si necesitamos Serve externo porque el host publica varios servicios o puertos, hay que documentar las rutas, preservar la autenticación por token o contraseña y seguir el runbook oficial. gateway.trustedProxies no es un amuleto: es una lista de orígenes en los que realmente estamos dispuestos a confiar.
Emparejamiento, URL segura y permisos del móvil
Los dispositivos móviles son una fuente frecuente de confusión porque intervienen distintos conceptos: el URL al Gateway, el transporte cifrado, la identidad del cliente, el emparejamiento y las capacidades concedidas. Un código de vinculación no es intercambiable con un token administrativo, y un cliente autorizado para conversar puede no necesitar permisos para actualizar el servidor.
La documentación de red diferencia conexiones locales seguras mediante loopback o LAN privada de conexiones remotas que requieren una URL protegida. Para el acceso remoto por tailnet, wss:// y HTTPS son el camino natural. Una URL ws:// publicada en un host público o detrás de un proxy sin TLS apropiado expone la sesión y los secretos de transporte.
El mensaje que pide una URL segura no debería resolverse con ajustes que deshabiliten verificaciones de origen o identidad. Hay que inspeccionar cómo se generó el código, qué URL anuncia el Gateway y si el modo Tailscale coincide con esa URL. En una arquitectura con servicio remoto, es importante que un cliente no intente hablar por defecto con un gateway local que ni siquiera está instalado.
Para separar riesgo, daría permisos limitados a dispositivos que solo deben conversar y reservaría el perfil administrativo para el equipo de mantenimiento. El objetivo es que perder un móvil no implique perder el control del servidor. La revocación de emparejamiento y rotación de credenciales deben formar parte de la documentación operativa.
Seguridad del Gateway: la red privada no basta
La guía de exposición aconseja evitar el port forwarding público del Gateway. No es una recomendación cosmética: una instancia de agente puede tener herramientas de shell, acceso a archivos, tokens de servicios y capacidades para actuar sobre otros sistemas. La exposición de su API es una superficie de ejecución de alto valor.
La configuración debe partir de un inventario de canales y permisos. ¿Qué usuarios pueden enviar mensajes? ¿Qué agentes pueden recibirlos? ¿Qué herramientas están disponibles para mensajes de origen remoto? ¿Existe sandbox para sesiones no confiables? ¿Dónde están las claves del proveedor de modelos? Sin esas respuestas, la distinción entre entorno «personal» y servicio público se vuelve engañosa.
La documentación también aclara que ciertos secretos compartidos usados para autenticar rutas HTTP representan prácticamente privilegios amplios de operador. Un token robado no debe tratarse como una simple contraseña de lectura. Si hay varios niveles de confianza, conviene utilizar puertas de entrada separadas o autenticación basada en identidades con permisos acotados.
Por último, un proxy TLS no sustituye automáticamente a un proxy de autenticación. gateway.auth.mode: “trusted-proxy” está pensado para proxys que verifican realmente la identidad; nunca para un terminador TLS que pasa cabeceras sin control. Si no estamos seguros de que el proxy elimina las cabeceras manipulables y es la única ruta hacia el Gateway, el modo sencillo de token o contraseña es una decisión más segura.
Monitorización ligera: saber antes de que algo esté roto
Un sistema personal no necesita una plataforma empresarial para saber si está vivo. Necesita suficientes señales para distinguir proceso caído, Gateway no preparado, cliente desconectado y tarea fallida. Como mínimo observaría el estado del servicio, la comprobación de salud y la última actualización exitosa. Separaría los fallos de transporte de los errores del proveedor de modelo.
Podemos definir una rutina de mantenimiento breve: comprobar semanalmente nuevas versiones y avisos de seguridad; registrar un backup verificado antes de cambios mayores; inspeccionar tareas programadas que llevan demasiado tiempo sin resultado; y confirmar que los clientes ya emparejados siguen conectando tras el upgrade. El detalle importa más que la frecuencia exacta.
Evitaría también la tentación de reiniciar el proceso cada vez que el panel tarda en responder. Un reinicio podría interrumpir la operación que precisamente queríamos recuperar. Primero capturaría logs y estado de la sesión. Si el Gateway continúa saludable pero la UI no, hay que investigar conexiones, sesión del navegador y proxy antes de matar el servidor.
La mejor alarma no es la que envía más notificaciones, sino la que permite actuar. «Servicio inactivo» es accionable. «La aplicación se comporta raro» suele requerir información adicional. Cuando una automatización es importante, su propio resultado debería incluir una señal de finalización para distinguir un éxito silencioso de una tarea que nunca se ejecutó.
Runbook de recuperación: primero preservar evidencia
Cuando una actualización falla, el primer impulso suele ser reinstalar. Resístelo. Anota exactamente qué versión intentaba arrancar, cuál era la anterior, qué archivos de estado existen y cuál es el último backup comprobado. Antes de editar la configuración, guarda el mensaje de error y los logs, sin copiar a una incidencia pública claves, tokens ni datos privados.
Segundo, determina si el fallo ocurrió antes o después de que la nueva versión pudiera escribir estado persistente. Esa frontera es central para decidir si basta un rollback de código o si hace falta restaurar bases de datos. La documentación de OpenClaw describe explícitamente condiciones donde el rollback automático no puede considerarse seguro, entre ellas snapshots incompletos o migraciones ya aplicadas.
Tercero, utiliza el procedimiento indicado por la release afectada. Si Doctor pide una versión puente para normalizar estado antiguo, haz la migración sobre una copia o con respaldo verificado. No borres bases de datos ni sidecars solo para que dejen de aparecer advertencias. Algunos archivos se conservan precisamente porque pueden contener información que una versión moderna ya no sabe importar.
Cuarto, prueba el servicio desde el host antes de culpar al acceso remoto. Cuando el Gateway ya responda localmente, revisa Tailscale o el proxy y después los clientes. Así delimitamos el problema sin mezclar fallos de arranque y red. Por último, registra qué cambió y cómo evitar repetir el incidente: la nota de recuperación es una herramienta de mantenimiento, no una memoria heroica de haber salvado el sistema.
Un pequeño experimento para medir la fiabilidad
Propondría una prueba reproducible con un entorno descartable y un Gateway de prueba, no con el agente que guarda toda nuestra memoria personal. Congelamos versión inicial, configuración y plugins, generamos una tarea de lectura inocua y preparamos una candidata. Registramos estados y tiempos sin secretos. Primero hacemos una actualización compatible y comprobamos que los clientes pueden reconectar.
Después simulamos una candidata inválida en un entorno controlado, sin corromper datos del servicio principal. Observamos si el Gateway anterior sigue operativo, qué informe emite el actualizador y qué intervención humana se necesita. Finalmente realizamos un ensayo de restauración completa desde la copia de seguridad en otra ruta, verificando que el estado esperado es accesible.
Los criterios de aceptación serían concretos: no perder datos anteriores al respaldo, no exponer el puerto a Internet, no aceptar clientes no autorizados, recuperar el servicio mediante procedimientos documentados y conservar evidencia suficiente para explicar el fallo. Si una actualización exige restauración manual, debe contarse como tal, aunque finalmente termine bien.
Estos experimentos permitirían comparar versiones y configuraciones con más rigor que un «actualicé y me funcionó». Aquí no publico resultados numéricos porque no he ejecutado la batería sobre un host. Lo que entrego es un protocolo y un análisis de los mecanismos documentados.
¿Merece la pena OpenClaw para un indie dev?
Sí puede merecerla cuando queremos un agente accesible desde varios dispositivos, con memoria persistente y automatizaciones conectadas a servicios que utilizamos con frecuencia. La ganancia no está en convertir cualquier tarea en una aventura de agentes; está en eliminar pequeñas interrupciones repetidas sin depender de tener abierto el portátil.
Pero hay costes ocultos: mantener versiones compatibles, custodiar credenciales, supervisar actualizaciones, comprobar copias y aprender lo suficiente sobre proxy y TLS para no exponer accidentalmente un servidor con herramientas de ejecución. Un desarrollador independiente debe comparar ese mantenimiento con el valor real de las tareas automatizadas. No todo merece vivir 24/7.
Para quien solo usa IA cuando programa, un asistente local en el IDE o en terminal puede ofrecer mejor relación simplicidad/valor. Para quien necesita continuidad entre móvil, servidor, automatizaciones y proyectos, el Gateway empieza a justificar sus capas adicionales. La pregunta no es cuál es «más potente» sino cuál aporta resultados verificables con menos riesgo y tiempo de administración.
La actualización atómica es un avance significativo, pero no elimina la necesidad de un runbook. De hecho, al hacer posible operaciones más transparentes, debería animarnos a elevar el estándar de recuperación: si el agente es importante, tenemos que poder mantenerlo aunque él no pueda ayudarnos.
Preguntas frecuentes
¿Las actualizaciones atómicas garantizan cero interrupciones?
No. El objetivo es preparar y validar la versión candidata sin perder inmediatamente el Gateway anterior y recuperar una versión compatible cuando algo falla. Migraciones de datos, plugins no compatibles, servicios externos y situaciones no previstas pueden impedir el rollback automático. La copia verificada sigue siendo imprescindible.
¿Debo actualizar siempre a la última versión?
No a ciegas. Revisa avisos de seguridad, notas de compatibilidad, versión actual y requisitos de migración. Para instalaciones antiguas puede ser obligatorio pasar por releases intermedias como 2026.9.5 y ejecutar Doctor. El proceso debe respetar el origen de instalación y el supervisor del servicio.
¿Tailscale sustituye al emparejamiento del dispositivo?
No. Tailscale establece una ruta privada y puede aportar identidad en determinados modos Serve, pero OpenClaw mantiene controles propios de cliente, autenticación y permisos. Un dispositivo móvil puede necesitar emparejamiento y autorización de capacidades.
¿Qué significa proxy_attribution_required?
Es una señal de que una conexión protegida llegó a través de una ruta de proxy cuyo origen o atribución de cliente no cumple las reglas esperadas. En Serve gestionado externamente hay que verificar el proxy inmediato, gateway.trustedProxies y las cabeceras reenviadas. Desactivar autenticación o confiar en todo Internet no es una solución válida.
Conclusión: que un agente sea autónomo no significa que se mantenga solo
La mejora más interesante de OpenClaw en septiembre no fue otro catálogo de herramientas. Fue reconocer un problema de fiabilidad básico: el usuario necesita conservar un agente capaz de diagnosticar el fallo, incluso cuando la actualización sale mal. Preparar candidatas, preservar el Gateway anterior y recuperar estados compatibles son pasos en esa dirección.
Sin embargo, la arquitectura más inteligente sigue necesitando límites. No es lo mismo revertir un paquete que restaurar una base de datos. No es lo mismo Serve administrado que un proxy externo. No es lo mismo permitir que un móvil converse que otorgarle control administrativo. Esas distinciones son las que convierten una demo brillante en un servicio personal digno de confianza.
Para mí, el siguiente paso razonable no es instalar más plugins: es documentar el estado, probar una restauración en pequeño y comprobar que una actualización fallida no convierte el mini PC en una caja negra. Un buen agente ahorra trabajo; un buen sistema de operación evita que ese ahorro se transforme en una nueva guardia de mantenimiento.
Bibliografía y fuentes
- OpenClaw: Shipping updates that don’t break — explicación de Jason Sy sobre updates atómicos, rollback y objetivos.
- Release notes oficiales — cambios de septiembre y documentación de versiones.
- Updating OpenClaw — actualizaciones soportadas, backups y migraciones.
- Config and migration repairs — formatos y Doctor.
- State, session and plugin repairs — comprobaciones y recuperación de estado.
- Tailscale Serve y Funnel — rutas, autenticación, proxy externo.
- Gateway configuration — puertos, bind, auth y proxies.
- Gateway exposure runbook — inventario y reducción de superficie.
- Trusted proxy auth — condiciones y advertencias.
- Debate comunitario sobre v2026.9.5 — experiencias e impresiones, no pruebas del runtime.
- Hermes vs OpenClaw en ArceApps — comparación previa, con enfoque distinto.
Artículo preparado el 10 de octubre de 2026, con fecha editorial del 9 de octubre para la serie. No se presentan pruebas ejecutadas ni métricas de producción como si hubieran sido verificadas personalmente.
También te puede interesar

DeepSeek Harness Desktop: análisis de su app
Descubre DeepSeek Harness Desktop: instalación, plugins, automatización, seguridad y límites reales de su nueva aplicación para agentes de IA.
SDD + TDD: del requisito a la prueba verificable
Aprende a combinar SDD y TDD con agentes de IA: especificaciones ligeras, criterios de aceptación, pruebas Red-Green-Refactor y revisión con CI.
Jev: IA para decidir, no para escribir
Descubre Jev y los System One Models: instalación, API, SDK, Agent Skill, CLI/MCP comunitarios y patrones para decisiones tipadas en software.