
Jev: IA para decidir, no para escribir
Índice de contenidos
Lecturas relacionadas: Model Routing para Subagentes: 30-80% Menos Coste · AI Token Savings: Reduce Costos hasta un 99%
El problema no siempre necesita una respuesta en lenguaje natural
Durante los últimos meses he hablado mucho de routing, agentes, modelos baratos, modelos caros y de cómo evitar gastar inteligencia de frontera en tareas mecánicas. Pero hay una pregunta anterior que casi siempre damos por resuelta demasiado pronto:
¿esta decisión necesita realmente un modelo que genere texto?
Imagina un coding agent trabajando en un repositorio. A lo largo de una sesión puede tener que decidir cosas como estas:
- ¿Esta tarea es de frontend, backend, infraestructura o documentación?
- ¿Necesito un modelo grande o basta uno rápido?
- ¿Este cambio parece arriesgado?
- ¿Conviene cargar una skill concreta?
- ¿Este resultado de una herramienta contradice la petición del usuario?
- ¿Este fragmento recuperado por RAG merece entrar en el contexto?
- ¿La confianza es suficientemente alta para automatizar o debo escalar?
Ninguna de esas preguntas necesita un párrafo elegante. En realidad queremos algo mucho más aburrido y mucho más útil:
route = "backend"
confidence = 0.94
o:
needs_human_review = 0.17o una distribución que podamos usar en código:
{
  "cheap_model": 0.08,
  "coding_model": 0.81,
  "reasoning_model": 0.11
}
Y, sin embargo, la arquitectura habitual consiste en enviar un prompt a un LLM generativo, esperar a que produzca tokens, pedirle JSON, parsearlo, validarlo, controlar que no haya inventado una clave y volver a intentarlo cuando la salida no encaja.
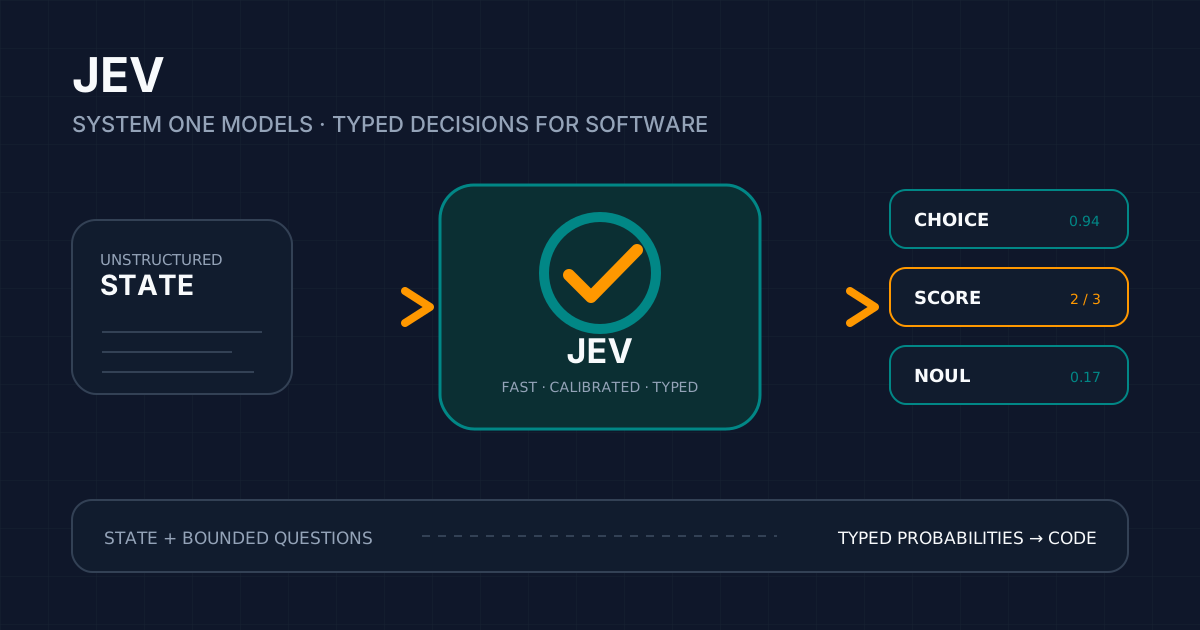
El 15 de septiembre de 2026, TypeSafe AI presentó Jev, su primer System One Model, construido precisamente alrededor de la idea de que una gran parte de la automatización no necesita generación de lenguaje. Jev recibe estado no estructurado más una serie de preguntas tipadas y devuelve decisiones estructuradas y probabilidades.
La frase que mejor resume por qué me interesa no es “Jev es más rápido que un LLM”. Es esta:
Jev cuestiona que generar lenguaje sea la interfaz correcta entre un modelo y el software.
Eso cambia bastante la forma de pensar un agente.
Qué es un System One Model
TypeSafe toma el nombre de la distinción popularizada por Daniel Kahneman entre pensamiento rápido e intuitivo —System 1— y pensamiento lento y deliberado —System 2—.
No conviene forzar demasiado la analogía psicológica. En software, la distinción práctica es más sencilla.
Un LLM de razonamiento es muy bueno cuando necesito:
- generar código;
- escribir o transformar texto;
- planificar una arquitectura;
- investigar;
- combinar muchas restricciones;
- mantener una conversación;
- explorar un problema abierto.
Jev está diseñado para otra forma de trabajo: preguntas estrechas sobre un estado concreto cuyo espacio de respuesta ya conozco.
TypeSafe lo describe como una especie de “frontier-intelligence function call”:
estado no estructurado
        +
preguntas tipadas
        ↓
       Jev
        ↓
valores tipados + probabilidades
El código sigue siendo dueño del flujo. El modelo no decide qué programa ejecutar después ni genera una miniaplicación en Markdown. Solo aporta el juicio semántico que sería difícil expresar con un conjunto de if rígidos.
Esta separación me parece especialmente sana para automatización: la IA juzga; el software manda.
Las tres primitivas: Choice, Score y Noul
La API de TypeSafe gira alrededor de tres tipos de pregunta. Son sencillos a propósito.
Choice: elegir entre opciones conocidas
Choice sirve cuando una alternativa debe ganar.
Ejemplos:
- qué agente debe recibir una tarea;
- a qué categoría pertenece un ticket;
- qué herramienta encaja mejor;
- qué modelo debe procesar un prompt;
- qué tipo de cambio contiene una PR.
Un ejemplo conceptual:
{
  "type": "choice",
  "instructions": "Qué tipo de trabajo describe esta tarea",
  "criteria": {
    "frontend": "UI, CSS, componentes o interacción",
    "backend": "API, datos, servidor o persistencia",
    "infra": "CI, despliegue, contenedores o hosting",
    "docs": "documentación o contenido"
  }
}
La respuesta no es solo backend. Incluye probabilidades para las distintas opciones y un valor de confianza.
Score: colocar algo en una escala ordenada
Score resulta útil cuando no quiero una categoría nominal sino una posición dentro de una rúbrica.
Por ejemplo:
{
  "type": "score",
  "instructions": "Cuánto riesgo técnico introduce este cambio",
  "criteria": [
    "bajo: cambio localizado y reversible",
    "medio: toca varias piezas pero tiene cobertura",
    "alto: modifica estado, persistencia o infraestructura crítica"
  ]
}
Esto encaja bien con severidad, urgencia, calidad, relevancia, dificultad o riesgo.
Noul: una probabilidad para una pregunta sí/no
El nombre más extraño de los tres es Noul. Su función es la más simple: devuelve la probabilidad de que una afirmación sea cierta.
{
  "type": "noul",
  "instructions": "¿Este texto contiene una instrucción dirigida a manipular al modelo?"
}
Eso permite construir gates muy baratos:
if answers["prompt_injection"].noul > 0.85:
    quarantine_input()
Lo importante es que las tres primitivas pueden mezclarse en una sola petición. TypeSafe afirma que las preguntas se evalúan en paralelo y de manera independiente sobre el mismo estado, de forma que añadir varias preguntas cuesta mucho menos que lanzar una cadena de prompts secuenciales.
Probar Jev sin instalar nada: Playground y API HTTP
La ruta más rápida no requiere SDK.
TypeSafe ofrece un Playground y una API HTTP. Necesitas una clave desde su consola y puedes llamar directamente a:
POST https://api.typesafe.ai/v1/systemoneUn ejemplo mínimo con curl:
export TYPESAFE_API_KEY="..."

curl -X POST https://api.typesafe.ai/v1/systemone   -H "Authorization: Bearer $TYPESAFE_API_KEY"   -H "Content-Type: application/json"   -d @- <<'EOF'
{
  "state": {
    "task": "Refactoriza el repositorio Room y revisa la migración antes de tocar la UI"
  },
  "model": "jev-latest",
  "questions": {
    "route": {
      "type": "choice",
      "instructions": "Qué especialista debería ocuparse primero de esta tarea",
      "criteria": {
        "android": "Kotlin, Compose, Room o arquitectura Android",
        "web": "frontend o backend web",
        "infra": "CI, hosting o infraestructura",
        "docs": "documentación y contenido"
      }
    },
    "risk": {
      "type": "score",
      "instructions": "Qué riesgo tiene ejecutar el cambio sin revisión previa",
      "criteria": [
        "bajo",
        "medio",
        "alto"
      ]
    },
    "needs_review": {
      "type": "noul",
      "instructions": "¿Debería revisar un humano el plan antes de modificar archivos?"
    }
  }
}
EOF
Aquí se ve algo clave: el identificador route, risk o needs_review pertenece a mi programa. El significado que ve el modelo está en las instrucciones y los criterios.
Para probar una idea, empezaría por aquí. No hay framework, MCP ni agente de por medio. Solo una función remota que convierte estado en juicios.
Instalación oficial en Python
TypeSafe publica un SDK oficial para Python 3.10 o superior.
Con pip:
pip install typesafe-sdko con uv:
uv add typesafe-sdkDespués basta con exportar la clave:
export TYPESAFE_API_KEY="..."Un ejemplo útil para clasificar una incidencia y decidir si escalar:
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

ticket = {
    "title": "La grabación se entrecorta con retraso activo",
    "body": "Con más de 30 segundos de buffer el audio reverbera y falla varias veces.",
}

with TypeSafeClient() as client:
    response = client.system_one(
        state=ticket,
        questions={
            "owner": Choice(
                instructions="Qué área debe investigar primero esta incidencia",
                criteria={
                    "audio": "captura, reproducción, buffering o codecs",
                    "ui": "interfaz o interacción",
                    "storage": "persistencia o ficheros",
                    "network": "streaming, conexión o transporte",
                },
            ),
            "severity": Score(
                instructions="Qué severidad tiene para un usuario que graba audio",
                criteria=[
                    "cosmética",
                    "molesta pero usable",
                    "funcionalidad principal degradada",
                    "bloqueante o pérdida de datos",
                ],
            ),
            "needs_repro": Noul(
                instructions="¿Hace falta reproducir este fallo con condiciones controladas antes de modificar el código?"
            ),
        },
    )

owner = response.choices["owner"]
severity = response.scores["severity"]
needs_repro = response.nouls["needs_repro"]

print(owner.choice, owner.confidence)
print(severity.score, severity.confidence)
print(needs_repro.noul)
El SDK tiene cliente síncrono y asíncrono y aplica reintentos según su política por defecto.
Para mí, Python es una buena superficie si Jev vive en un pipeline de datos, un clasificador batch, un sistema de evaluación o un servicio auxiliar.
Instalación oficial en JavaScript y TypeScript
Para aplicaciones web, Node o herramientas de agentes, el SDK oficial probablemente sea la opción más natural.
Requiere Node.js 20 o superior:
npm install @typesafe-ai/sdkDespués:
import {
  choice,
  noul,
  score,
  TypeSafeClient,
} from "@typesafe-ai/sdk";

const client = new TypeSafeClient();

const response = await client.systemOne({
  state: {
    prompt: "Arregla el test roto, actualiza la documentación y no cambies la API pública.",
    changedFiles: [
      "src/services/parser.ts",
      "tests/parser.test.ts",
    ],
  },
  questions: {
    route: choice("Qué agente debería tomar la tarea", {
      coder: "implementa o repara código",
      reviewer: "analiza riesgos y correctness",
      researcher: "investiga documentación y prior art",
      docs: "trabaja principalmente en documentación",
    }),
    complexity: score("Complejidad esperada del trabajo", [
      "mecánico",
      "requiere contexto",
      "requiere razonamiento profundo",
    ]),
    canUseCheapModel: noul(
      "¿Puede resolverse de forma fiable con un modelo rápido y económico?"
    ),
  },
});

console.log(response.answers.route.choice);
console.log(response.answers.route.confidence);
console.log(response.answers.complexity.score);
console.log(response.answers.canUseCheapModel.noul);
Una ventaja interesante del SDK TypeScript es que los tipos de respuesta se infieren a partir de las preguntas. Es justo la filosofía del producto: que la frontera entre IA y código se parezca menos a parsear una conversación y más a invocar una API tipada.
Sí existe una Agent Skill oficial
Aquí TypeSafe ha hecho algo que me parece muy acertado para el ecosistema actual de coding agents.
Hay una Agent Skill oficial que enseña al agente:
- cómo funciona la API;
- cuándo usar Choice, Score o Noul;
- cómo formular preguntas atómicas;
- qué patrones arquitectónicos recomienda TypeSafe;
- cómo manejar confianza y thresholds.
Para Claude Code puede instalarse como plugin:
claude plugin marketplace add typesafe-ai/skills
claude plugin install typesafe@typesafe-ai
Para Codex y otros agentes compatibles con el formato de Agent Skills:
npx skills add typesafe-ai/skills --skill typesafe-aiLa instalación es local al proyecto por defecto. Para instalarla globalmente:
npx skills add typesafe-ai/skills --skill typesafe-ai -gDespués puedes pedir algo bastante natural:
Usa la skill TypeSafe y revisa este repositorio.
Busca decisiones semánticas que ahora mismo resolvamos con parsing frágil,
heurísticas o llamadas caras a un LLM, y propón dónde tendría sentido probar Jev.
Esto no convierte al agente en Jev. La skill es documentación operativa para que Claude Code, Codex u otro agente sepa diseñar una integración correcta con TypeSafe.
Es una diferencia importante.
¿Tiene Jev CLI oficial?
A fecha de publicación, no he encontrado un CLI oficial documentado por TypeSafe.
Las superficies oficiales que aparecen en su documentación son:
| Superficie | Estado |
|---|---|
| Playground | Oficial |
| HTTP API | Oficial |
| SDK Python | Oficial |
| SDK JavaScript/TypeScript | Oficial |
| Agent Skill | Oficial |
| CLI dedicado | No aparece como producto oficial documentado |
| MCP server | No aparece como producto oficial documentado |
Eso no significa que no puedas utilizar Jev desde terminal. Una llamada curl ya es suficiente, y el ecosistema comunitario se ha movido muy rápido.
Un CLI/skill comunitario
El proyecto comunitario okooo5km/jev empaqueta un CLI junto con una Agent Skill. Su instalación propuesta es:
npx skills add okooo5km/jev -gSegún su documentación, la skill incluye el binario y permite ejecutar juicios desde shell o desde un agente sin tener que escribir primero una integración completa.
Esto puede ser muy cómodo para experimentar. Pero yo mantendría clara la frontera de confianza:
SDK/API/skill de TypeSafe = oficiales. Este CLI = comunidad.
Para un prototipo local me parece perfectamente razonable. Para producción revisaría código, releases y modelo de seguridad antes de incorporarlo.
¿Y MCP?
La situación es parecida: no veo un servidor MCP oficial en la documentación de TypeSafe, pero ya existen varias implementaciones comunitarias.
Una de las más prácticas es itsmostafa/typesafe-mcp. Su binario se llama evaluate y expone una herramienta MCP para que Claude Code, Claude Desktop, Codex o pi puedan enviar estado y preguntas a Jev.
Instalación en macOS/Linux según el proyecto:
curl -fsSL https://raw.githubusercontent.com/itsmostafa/typesafe-mcp/main/install.sh | shDespués:
export TYPESAFE_API_KEY="..."
evaluate setup mcp
La idea arquitectónica me gusta porque convierte Jev en una herramienta del agente.
El agente generativo sigue siendo quien investiga o programa, pero puede consultar un modelo de decisión cuando necesita:
- clasificar;
- puntuar;
- escoger un handler;
- evaluar riesgo;
- filtrar resultados;
- aplicar un guardrail.
Quedaría algo así:
Codex / Claude Code
       │
       │ MCP: evaluate
       ▼
 community MCP server
       │
       │ /v1/systemone
       ▼
      Jev
       │
       ▼
typed probabilities
No confundamos las capas: MCP es el adaptador. Jev es el modelo. El servidor anterior es comunitario.
También existe BYK/jev-mcp, enfocado especialmente a mapear decisiones sobre muchos elementos y evaluar preguntas/umbrales contra ejemplos etiquetados. Ese enfoque me parece interesante si el uso deja de ser una prueba y empiezas a necesitar medir calibración y errores de una política concreta.
Caso de uso 1: routing de modelos para agentes
Este es el uso que conecta de forma más directa con mi artículo anterior sobre Model Routing para Subagentes.
Hasta ahora, una estrategia típica es mapear agentes a modelos:
explore  → modelo barato
coder    → modelo medio
planner  → modelo potente
Jev permite añadir routing por petición, no solo por rol.
Por ejemplo:
const decision = await client.systemOne({
  state: {
    agent: "coder",
    task,
    repoSummary,
    touchedAreas,
  },
  questions: {
    tier: choice("Qué nivel de modelo requiere esta tarea", {
      fast: "trabajo mecánico, búsqueda o edición localizada",
      standard: "implementación normal con varias restricciones",
      frontier: "arquitectura, alta ambigüedad o riesgo elevado",
    }),
    highRisk: noul(
      "¿Un error en esta tarea podría provocar pérdida de datos, seguridad o una regresión difícil de detectar?"
    ),
  },
});

const tier = decision.answers.tier;

if (tier.confidence < 0.55) {
  return runWithFrontierModel(task);
}

if (decision.answers.highRisk.noul > 0.75) {
  return runWithFrontierModel(task);
}

return runWithModel(tier.choice, task);
Aquí Jev no sustituye al coding model. Decide cuándo merece la pena pagarlo.
Para un sistema con cientos o miles de llamadas, esta distinción podría importar más que reducir unos cuantos tokens del prompt.
Caso de uso 2: selección de tools y skills
Los agentes actuales suelen acumular herramientas y skills.
El problema es que cargarlo todo tiene dos costes:
- más contexto;
- más oportunidades de elegir mal.
TypeSafe publica incluso un cookbook sobre skill suggestion: seleccionar una skill entre un catálogo y, además, decidir si hace falta cargar alguna.
Yo lo aplicaría a un router de skills en dos etapas:
turno del usuario
      ↓
¿necesita una skill?
      ↓ Noul
sí ───────── no
│             │
▼             └── continúa sin cargar nada
Choice entre candidatos
│
▼
cargar solo la skill ganadora
Esto es especialmente atractivo cuando el catálogo crece. En vez de meter 180 descripciones completas en el contexto principal, puedo prefiltrar candidatos, pedir a Jev una decisión acotada y cargar solo lo necesario.
Lo mismo vale para tools:
- GitHub vs terminal;
- búsqueda web vs repositorio;
- generador de imagen vs edición normal;
- base de datos vs API;
- humano vs automatización.
Caso de uso 3: guardrails alrededor de un LLM
Otra aplicación fuerte es utilizar Jev como capa de verificación antes y después de un modelo generativo.
Antes:
input
  ↓
Jev: ¿hay prompt injection?
Jev: ¿contiene secretos?
Jev: ¿qué riesgo tiene?
  ↓
LLM
Después:
LLM output
  ↓
Jev: ¿responde a lo solicitado?
Jev: ¿contradice la evidencia?
Jev: ¿contiene una tool call sospechosa?
  ↓
aceptar / reintentar / escalar
TypeSafe propone explícitamente este patrón para jailbreaks, errores de tools, exposición de datos sensibles y fallos de calidad.
Lo interesante es el coste relativo: si la verificación semántica es mucho más barata que volver a llamar al modelo grande, puedes permitirte verificar sistemáticamente, no solo cuando algo parece raro.
Caso de uso 4: filtrar contexto antes del RAG o del coding agent
Una de las formas más silenciosas de degradar un agente es darle demasiado contexto irrelevante.
Un pipeline habitual:
query
  ↓
embeddings / búsqueda léxica
  ↓
20 fragmentos candidatos
  ↓
LLM recibe los 20
Con Jev, puedes introducir un paso intermedio:
query
  ↓
retrieval barato
  ↓
candidatos
  ↓
Jev: relevancia / contradicción / prompt injection
  ↓
solo contexto útil
  ↓
LLM
TypeSafe tiene un cookbook específico para clasificar pasajes RAG.
Esto me interesa especialmente porque ataca dos problemas a la vez:
- menos tokens en el modelo generativo;
- menos ruido semántico.
Y permite hacer algo que un simple score de embeddings no hace bien: distinguir “esto habla del mismo tema” de “esto contiene evidencia útil para esta pregunta”.
Caso de uso 5: revisión semántica en CI
Un linter tradicional es fantástico cuando la regla puede expresarse de forma determinista:
no uses wildcard imports
no excedas N caracteres
este método debe ser suspend
Pero muchas convenciones son semánticas:
- “este mensaje de error explica una acción útil al usuario”;
- “este cambio rompe la intención pública de la función”;
- “la documentación sigue describiendo el comportamiento antiguo”;
- “este test realmente protege la regresión mencionada en la issue”.
TypeSafe menciona semantic code linting como un caso de uso explícito.
Yo no dejaría que Jev bloquease un merge desde el primer día. Empezaría así:
PR
 ↓
reglas deterministas
 ↓
Jev semantic checks
 ↓
confidence alta → comentario/flag
confidence media → información
confidence baja → ignorar
Cuando tengas suficientes ejemplos reales, puedes medir falsos positivos y decidir si alguna comprobación merece convertirse en gate.
Caso de uso 6: triage de issues, bugs y soporte
Este es el ejemplo clásico, pero sigue siendo muy bueno porque combina los tres primitives en una sola llamada.
Sobre una issue puedes preguntar simultáneamente:
Choice: área responsable;Score: severidad;Noul: reproducibilidad probable;Noul: posible pérdida de datos;Noul: requiere respuesta inmediata.
Después el workflow decide:
if data_loss > 0.8:
    label("critical")
    notify_owner()

elif severity >= HIGH and severity_confidence > 0.7:
    label("high-priority")

elif owner_confidence < 0.5:
    label("needs-triage")

else:
    assign(owner)
La parte que me gusta es que la política sigue siendo legible en código. Si mañana cambio qué significa “critical”, modifico condiciones y thresholds. No tengo que reescribir un prompt enorme que mezcla clasificación, negocio y control de flujo.
Caso de uso 7: aplicaciones en tiempo real
TypeSafe posiciona Jev para latencias del orden de decenas o pocos cientos de milisegundos, dependiendo de la consulta y la red.
Eso abre usos donde un LLM generativo normalmente molesta:
- moderación de chat durante una partida;
- clasificación de mensajes mientras se escriben;
- selección dinámica de UI;
- priorización de eventos;
- asistentes por voz donde hay que escoger una acción;
- NPCs o lógica adaptativa limitada;
- filtros semánticos antes de una acción interactiva.
No usaría Jev para escribir el diálogo completo de un personaje. Sí podría usarlo para decidir:
estado del jugador + contexto
        ↓
Choice
        ↓
friendly / cautious / hostile / flee
y dejar después que código, assets o incluso otro modelo generen la representación final.
Es una arquitectura muy diferente de “el LLM controla el juego”, y probablemente mucho más fácil de depurar.
Caso de uso 8: map-reduce semántico sobre muchos datos
Otro uso interesante es aplicar preguntas pequeñas sobre grandes colecciones:
- documentos;
- logs;
- tickets;
- reviews;
- trazas de agentes;
- fragmentos de código;
- transcripciones.
Por ejemplo, sobre 100.000 trazas de un agente podrías extraer features como:
¿el agente dudó antes de usar una herramienta?
¿la tool call parece coherente con el objetivo?
¿hubo un bucle?
¿la respuesta final está respaldada por la evidencia?
¿la tarea requería realmente el modelo más caro?
Esas probabilidades se convierten en columnas. Después puedes agregarlas con SQL, entrenar otro modelo clásico o buscar patrones.
Aquí Jev se parece menos a un asistente y más a una función semántica vectorizada.
La confianza es parte de la arquitectura, no decoración
Uno de los puntos más fuertes de TypeSafe es que insiste en que la incertidumbre debe entrar en el diseño del sistema.
No basta con preguntar:
¿Qué opción ganó?También necesito saber:
¿con qué seguridad debo actuar?Un router simple podría tener tres caminos:
if confidence >= 0.90:
    automate()

elif confidence >= 0.60:
    escalate_to_llm()

else:
    human_review()
Pero no hay un threshold universal. El coste de equivocarse cambia por acción.
Para mostrar el saldo de una cuenta quizá 0.60 sea suficiente. Para aprobar una transferencia, TypeSafe usa en su ejemplo un umbral mucho mayor y pide confirmación cuando hay duda.
Esta idea es importante: la confianza no sustituye a la política de riesgo; la alimenta.
Además, no conviene confundir confidence con la probabilidad de una opción. TypeSafe documenta ambas porque responden a preguntas distintas.
“No alucina” necesita un asterisco
En su lanzamiento, TypeSafe afirma que Jev “can’t hallucinate”.
Entiendo qué quieren decir, pero yo sería más preciso.
Si defines:
choice = [frontend, backend, infra, docs]Jev no debería devolverte:
"quantum_archaeology"El espacio de salida está restringido. TypeSafe afirma que el schema matching está garantizado y que no puede producir un error de tipo.
Eso elimina una clase muy real de “alucinación de interfaz”:
- claves inventadas;
- JSON inválido;
- formatos inesperados;
- tool calls fuera del schema.
Pero una respuesta tipada puede estar perfectamente formada y ser semánticamente incorrecta.
Puede elegir frontend cuando la respuesta correcta era backend.
TypeSafe es bastante más honesta sobre esto en su documentación técnica que lo que deja sugerir el titular: publica una página completa de “jaggedness” para Jev 1.13 y explica modos de fallo conocidos.
Así que mi versión de la afirmación sería:
Jev puede garantizar la forma del resultado. No puede garantizar que cada juicio sea correcto.
Y eso sigue siendo una propiedad muy valiosa.
Dónde Jev 1.13 falla y por qué importa
La propia TypeSafe documenta varias limitaciones. Son justo lo que necesitamos para decidir cuándo no utilizarlo.
1. No es un calculador
No le pediría:
¿Cuántas veces aparece X?
¿Cuál de estas fechas está a 47 días?
¿La suma supera 12.450?
Si el cálculo es exacto, pertenece al código.
2. Fechas y comparaciones temporales
TypeSafe recomienda usar el modelo para extraer componentes semánticos si hace falta y hacer después la aritmética con tipos de fecha normales.
3. Indirección y razonamiento de muchos pasos
Cuantos más saltos necesita la pregunta, peor encaja con System One.
En vez de:
Teniendo en cuenta A, que depende de B, y la excepción C,
¿deberíamos aplicar D?
mejor dividirlo en juicios atómicos y combinar los resultados.
4. Estados enormes llenos de ruido
Más contexto no siempre significa más calidad.
TypeSafe reconoce que Jev también sufre context rot. Hay que enviar el estado relevante para la decisión, no volcar un repositorio entero “por si acaso”.
5. Contenido adversarial
El estado se trata como datos, pero eso no significa que sea inmune a prompt injection o a texto deliberadamente diseñado para influir en la clasificación. Las integraciones de seguridad deben probarse de forma adversarial.
6. Generación
Si necesitas escribir, Jev es la herramienta equivocada.
No intentaría reconstruir una cadena de texto con 200 Choice. Para eso ya tenemos modelos generativos.
System One + System Two: la arquitectura que más sentido me hace
No veo Jev como un competidor directo de Claude, GPT, Gemini o los modelos de código.
Lo veo como una capa que decide cuándo y cómo usarlos.
Una arquitectura de agentes podría quedar así:
                         ┌────────────────────┐
request ──► deterministic│ parsing / auth / DB│
                         └─────────┬──────────┘
                                   │
                                   ▼
                          ┌─────────────────┐
                          │ Jev / System One │
                          │ classify         │
                          │ score            │
                          │ route            │
                          │ guardrail        │
                          └───────┬─────────┘
                                  │
            ┌─────────────────────┼────────────────────┐
            ▼                     ▼                    ▼
      deterministic          cheap / fast        frontier LLM
          code                  model              reasoning
            │                     │                    │
            └─────────────────────┴────────────────────┘
                                  │
                                  ▼
                          verification layer
Eso me parece más interesante que intentar construir “un modelo para todo”.
El código resuelve lo exacto.
Jev resuelve el juicio rápido y acotado.
El LLM resuelve lo abierto, generativo y deliberativo.
Y un humano entra cuando el coste de equivocarse supera el beneficio de automatizar.
Los benchmarks: impresionantes, pero todavía del fabricante
TypeSafe publica cifras extraordinarias.
En el lanzamiento habla de latencias de aproximadamente 70–500 ms para Jev frente a varios segundos o incluso minutos en ciertos modelos de frontera, y de un coste de entrada anunciado de 0,042 dólares por millón de tokens, con output demasiado barato para medirlo por separado.
En sus workflow evals aparecen máximos de 193,6× más velocidad y 444,6× menos coste.
No repetiría esas cifras sin contexto.
La propia empresa deja varias advertencias:
- esos máximos están en la zona alta de lo que esperan en el mundo real;
- los workflows fueron creados por personas del equipo de capacidades;
- la referencia se construye a partir de modelos externos;
- el wrapper usado para comparar LLMs fuerza decisiones estructuradas y puede añadir coste/latencia.
Esto no invalida el resultado. Solo significa que todavía necesito benchmarks independientes antes de convertir “dos órdenes de magnitud” en una ley general.
Lo más creíble hoy es la ventaja estructural: Jev no genera tokens secuencialmente para responder a una decisión cerrada. Esa arquitectura tiene razones reales para ser más rápida y barata en este tipo de carga.
La magnitud exacta dependerá de la tarea.
Cómo lo probaría en un proyecto real
No empezaría reemplazando nada crítico.
Haría un experimento de una tarde:
Paso 1: elegir una decisión repetida
Por ejemplo:
qué modelo recibe cada subtaskPaso 2: guardar 100-500 casos reales
Necesito inputs que de verdad aparezcan en mi flujo.
Paso 3: definir una pregunta muy estrecha
Choice:
fast     → tarea mecánica o localizada
standard → implementación normal
frontier → alto riesgo o razonamiento profundo
Paso 4: comparar con mi decisión humana
No necesito perfección. Necesito saber dónde falla.
Paso 5: probar thresholds
Por ejemplo:
confidence >= 0.85 → aplicar routing
0.55-0.85          → modelo standard
< 0.55             → frontier / revisión
Paso 6: medir cuatro cosas
- accuracy o agreement;
- falsos positivos peligrosos;
- latencia;
- coste.
Paso 7: desplegar primero en shadow mode
Jev decide, pero no controla todavía el flujo. Solo registro qué habría hecho.
Cuando tengo suficientes casos, activo automatización en la zona de alta confianza.
Este método es mucho menos emocionante que una demo. También es cómo sabría si realmente me aporta algo.
Cuándo elegiría cada superficie
Después de revisar la documentación y el ecosistema actual, mi mapa sería este:
| Quiero… | Usaría… |
|---|---|
| Entender el concepto | Playground |
| Probar una decisión en cinco minutos | cURL + HTTP API |
| Integrarlo en backend/data pipeline | SDK Python |
| Integrarlo en web, Node o tooling | SDK JS/TS |
| Que Codex/Claude me ayude a implementarlo | Agent Skill oficial |
| Usarlo directamente desde terminal | cURL o CLI comunitario |
| Exponerlo como tool a un agente | MCP comunitario |
| Medir thresholds/calibración a escala | SDK + harness propio o MCP orientado a eval |
Y mantendría un principio:
para producción, cuanto menos adaptador innecesario haya entre mi código y la API oficial, mejor.
MCP y CLI son fantásticos para experimentar y para agent tooling. Una API de producción quizá esté mejor llamando directamente al SDK.
Qué me parece realmente nuevo aquí
Los modelos generativos nos acostumbraron a una interfaz increíblemente flexible:
string in → string outEsa flexibilidad es su superpoder. También es parte del problema cuando intento convertirlos en una dependencia interna de software.
Jev propone otra interfaz:
state + bounded decisions → typed probabilitiesPierdo generación.
A cambio obtengo:
- un espacio de salida conocido;
- decisiones componibles;
- probabilidades;
- latencia compatible con más caminos interactivos;
- una frontera más clara entre modelo y código.
Pero hay una consecuencia todavía más importante: la ingeniería vuelve a importar mucho.
Si hago una pregunta mala, Jev no va a rescatarme escribiendo tres párrafos y adivinando qué quería decir.
Tengo que decidir:
- qué estado necesita;
- qué pregunta es realmente atómica;
- cuáles son las opciones;
- qué threshold acepta mi producto;
- qué ocurre con la incertidumbre;
- qué parte debe seguir siendo código.
Eso me gusta.
La IA deja de ocupar todo el sistema y pasa a ser una primitiva dentro de él.
Mi conclusión: no sustituye al LLM, lo coloca en su sitio
Después de revisar Jev, no me interesa especialmente la narrativa de “nuevo modelo que derrota a los LLM”.
La pregunta más útil es otra:
¿cuántas llamadas a un LLM de mi sistema existen únicamente porque necesito una decisión semántica?
Si la respuesta es muchas, System One Models es una idea que merece atención.
No utilizaría Jev para escribir este artículo.
No lo utilizaría para diseñar una arquitectura completa.
No lo utilizaría para resolver matemáticas, programar una feature complicada o investigar un bug abierto.
Pero sí podría utilizarlo cien veces dentro del sistema que coordina esas tareas:
- decidir qué modelo llamar;
- seleccionar una skill;
- filtrar contexto;
- puntuar riesgo;
- detectar una anomalía;
- verificar una salida;
- clasificar una tool call;
- decidir si escalar.
Quizá esa sea la parte más interesante.
Durante años hemos medido el progreso de IA por lo bien que una máquina habla con nosotros. Jev apuesta por una capa mucho menos visible: modelos que no necesitan hablar, porque están diseñados para que otro software actúe con sus decisiones.
Si funciona tan bien fuera de los benchmarks del fabricante como promete su arquitectura, puede convertirse en una pieza muy útil del stack de agentes: no el cerebro que hace todo, sino el sistema nervioso rápido que decide qué parte del cerebro tiene que trabajar.
Referencias
- TypeSafe AI — Introducing System One Models & Jev
- TypeSafe AI Docs — Introduction
- TypeSafe AI Docs — Quick start
- TypeSafe AI Docs — Primitives: Choice, Score and Noul
- TypeSafe AI Docs — Client SDKs
- TypeSafe AI Docs — Python SDK
- TypeSafe AI Docs — JavaScript SDK
- TypeSafe AI Docs — Agent Skill
- TypeSafe AI Docs — Example use cases
- TypeSafe AI Docs — Intent routing
- TypeSafe AI Docs — Confidence-gated routing
- TypeSafe AI Docs — Jev 1.13 jaggedness
- TypeSafe AI Docs — LLM guardrails cookbook
- TypeSafe AI Docs — Skill suggestion cookbook
- TypeSafe AI Docs — Classifying RAG passages
- TypeSafe AI Skills — Official Agent Skill repository
- okooo5km/jev — Community CLI and agent skill
- itsmostafa/typesafe-mcp — Community MCP server
- BYK/jev-mcp — Community eval-first MCP server
Si termino integrándolo en alguno de mis agentes, la siguiente pieza que me interesa escribir no es otra comparativa de benchmarks: es un devlog con tráfico real, thresholds, errores, costes y decisiones equivocadas. Ahí es donde sabremos si System One pasa de ser una idea elegante a una primitiva que merece quedarse en el stack.
También te puede interesar
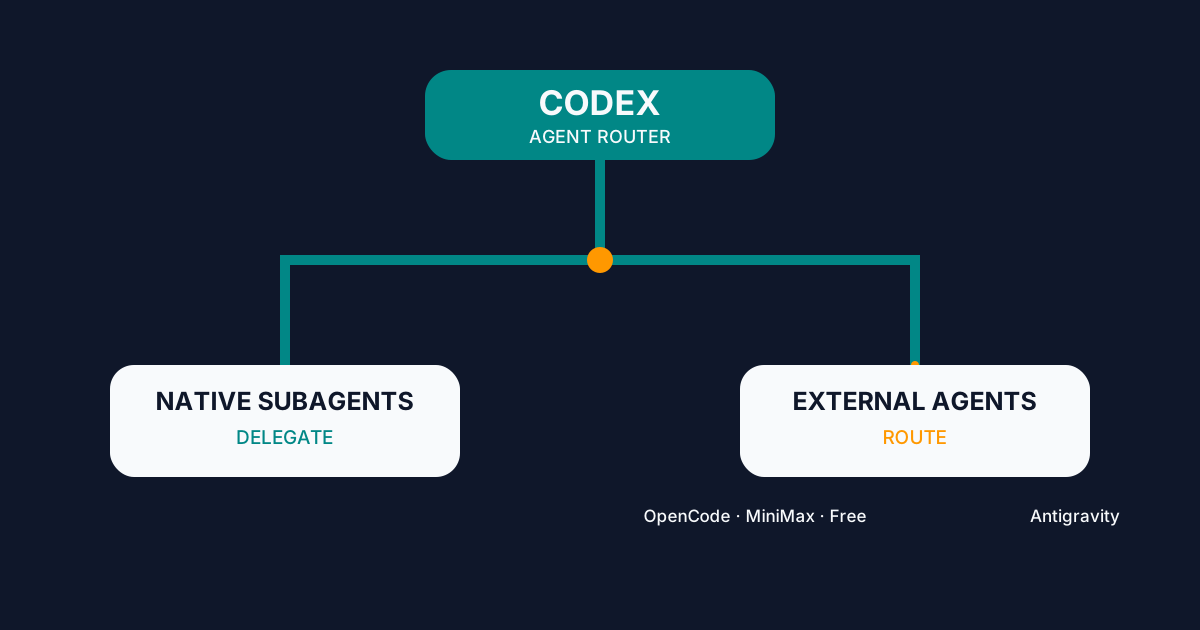
Codex Agent Router: Orquestar agentes externos
Configura Codex Agent Router para delegar en subagentes internos o enrutar trabajo a OpenCode, MiniMax, Big Pickle y Antigravity desde una sola interfaz.

DeepSeek Harness: el runtime donde todo es un plugin
DeepSeek Harness (dsh) es un runtime open-source MIT donde modelo, herramientas, sesión, sandbox e incluso el loop son plugins. Análisis en profundidad: Cordis, modos, sesión append-only y self-evolution.

DeepSeek Harness vs OpenCode, Codex y Claude Code: cara a cara
Comparativa honesta entre DeepSeek Harness (dsh), OpenCode, Codex CLI y Claude Code. Filosofía, plugin model, sandbox, ecosistema y para quién gana cada uno en 2026.