
Codex Agent Router: Orquestar agentes externos
Índice de contenidos
De elegir modelos a construir una centralita de agentes
Hace unas semanas escribí sobre model routing para subagentes: cómo dejar de enviar cada tarea al mismo modelo y empezar a escoger el motor adecuado según coste, velocidad y dificultad. Aquello resolvía una parte del problema, pero dejaba otra bastante más incómoda sobre la mesa. Una cosa es decidir qué modelo debería responder. Otra muy distinta es conseguir que varias herramientas de programación con IA trabajen juntas sin convertir mi escritorio en una colección de terminales, interfaces web, pestañas y procesos imposibles de seguir.
Mi problema real era muy concreto. Ya uso Codex como centro principal de trabajo. También quería aprovechar Antigravity y su CLI agy, OpenCode, distintos modelos accesibles mediante OpenCode y la posibilidad de utilizar un plan de MiniMax. No quería sustituir Codex. Tampoco quería abrir manualmente otra herramienta, copiar una tarea, pegar contexto, esperar, volver a Codex, explicar qué había pasado y reconciliar cambios. Quería poder escribir algo parecido a «enruta esta tarea» y que Codex decidiera a qué agente externo mandarla, siguiera siendo el punto de control y revisara el resultado al terminar.
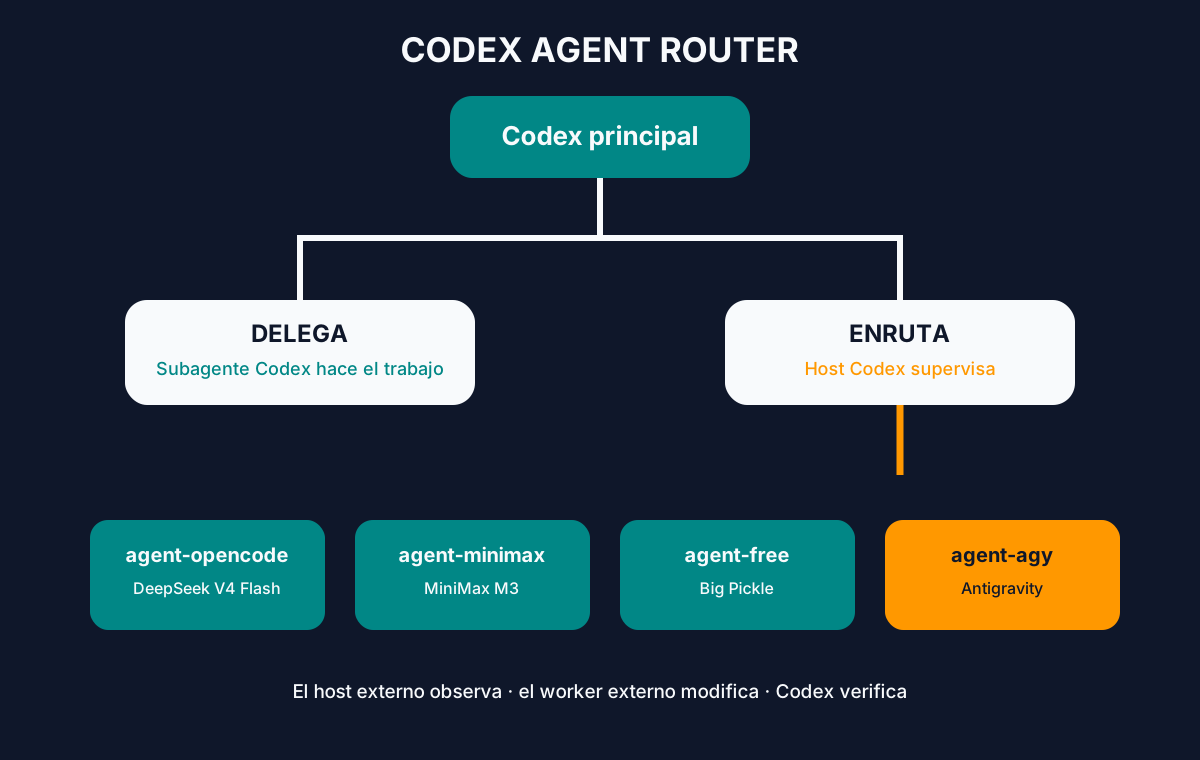
Eso nos llevó a diseñar una pequeña arquitectura de orquestación alrededor de las Skills de Codex. El sistema tiene cinco piezas: agent-opencode, agent-minimax, agent-free, agent-agy y una quinta skill, agent-router, que decide cómo repartir el trabajo. La parte interesante no son los nombres. Lo interesante es la separación conceptual que terminamos haciendo entre delegar y enrutar.
En mi flujo, «delega» significa: usa un subagente nativo de Codex. «Enruta» significa: manda el trabajo a un agente externo, pero hazlo desde un subagente host de Codex para que siga existiendo un hilo visible, un lugar donde observar la ejecución y un punto claro al que vuelve el resultado. Esa diferencia parece semántica, pero terminó resolviendo casi todos los problemas de diseño que fueron apareciendo.
La arquitectura siguió evolucionando después de la primera versión. Las primeras pruebas reales dejaron claro que no bastaba con poder lanzar un agente externo. Había que controlar también el ciclo de vida de cada proceso, evitar sesiones persistentes accidentales, distinguir errores del launcher de errores del modelo, conservar el exit code correcto, hacer visibles los reintentos y diseñar el logging pensando desde el principio en ejecuciones paralelas.
El resultado actual es bastante más sólido que el primer prototipo: cada routing externo es una ejecución efímera e independiente, los workers producen un log único, Codex sigue siendo el orquestador del paralelismo y el host tiene la obligación explícita de enseñar las acciones relevantes del worker en vez de limitarse a resumirlas.
El objetivo: un solo lugar desde el que mandar trabajo
La idea inicial nació de algo que ya funcionaba con Antigravity. agy permite ejecutar Antigravity de forma no interactiva desde la terminal. Si una herramienta puede recibir un prompt, trabajar sobre un repositorio y devolver una salida por CLI, entonces Codex puede tratarla como un proceso externo. El salto conceptual fue sencillo: si Codex puede ejecutar comandos, ¿por qué no convertir Antigravity en un worker al que Codex pueda enviar una tarea completa?
Después vino la segunda pregunta: si podemos hacerlo con agy, ¿por qué no con OpenCode?
OpenCode tiene precisamente un modo pensado para automatización:
opencode run \
  --model "provider/model" \
  --dir "/path/to/repository" \
  --auto \
  "Implementa la tarea descrita aquí"
No hay datos privados en este ejemplo ni los habrá en los snippets del artículo. Las rutas son genéricas y cualquier credencial, token, nombre de equipo, IP, hostname privado o endpoint interno queda deliberadamente fuera.
opencode run convertía OpenCode en una pieza ideal para la misma arquitectura. Además, el CLI deja seleccionar proveedor y modelo con --model. En mi configuración aparecían varias familias, así que en lugar de construir una única skill con una docena de alias decidí separar responsabilidades.
El primer worker sería OpenCode con DeepSeek V4 Flash. El segundo sería un worker gratuito con Big Pickle. El tercero utilizaría MiniMax M3, pero a través de OpenCode como harness. El cuarto seguiría siendo Antigravity mediante agy.
En ese momento la arquitectura era todavía muy básica:
Codex
├── agent-opencode -> OpenCode -> DeepSeek V4 Flash
├── agent-free     -> OpenCode -> Big Pickle
├── agent-minimax  -> OpenCode -> MiniMax M3
└── agent-agy      -> agy      -> Antigravity
Funcionaba como idea, pero faltaban dos cosas. Primero, una forma inteligente de decidir cuál utilizar sin tener que memorizar qué worker es mejor para cada clase de trabajo. Segundo, visibilidad. Lanzar un proceso externo y recibir únicamente el resultado final está bien para CI; para trabajar durante horas con agentes resulta demasiado opaco.
Por qué no hice una sola skill con todos los modelos
La primera tentación era obvia: crear $opencode y pasarle un alias de modelo.
Algo así:
$opencode deepseek corrige el bug
$opencode free revisa los tests
$opencode minimax migra este módulo
Técnicamente es sencillo. Operativamente no me convenció.
Una Skill de Codex no es solo un alias de shell. Su description ayuda a decidir cuándo debería usarse y su SKILL.md puede contener reglas específicas de comportamiento. Separar los workers me permite dar a cada uno un contrato distinto.
agent-free, por ejemplo, debe evitar que el prompt incluya secretos o información especialmente sensible. agent-agy necesita una política explícita sobre permisos porque lo ejecutamos en modo de aprobación total de herramientas. agent-minimax debe usar el proveedor del plan de MiniMax y no sustituirlo silenciosamente por el modelo homónimo de otro proveedor. agent-opencode es mi worker externo generalista.
Si todo eso viviera en una única skill, cada ejecución cargaría reglas de cuatro backends distintos y Codex tendría que decidir simultáneamente proveedor, permisos, coste, modelo y modo de ejecución. Separarlos reduce contexto y, sobre todo, reduce ambigüedad.
Las cuatro skills son las primitivas. agent-router es la política.
Esta distinción permite cambiar una pieza sin tocar las demás. Si mañana Big Pickle deja de ser gratuito, puedo modificar agent-free. Si MiniMax cambia el identificador del modelo, cambio agent-minimax. Si agy añade un nuevo modo de streaming, ajusto agent-agy. El router solo necesita saber qué tipo de trabajo encaja con cada worker.
En otras palabras, preferí composición frente a una mega-skill.
Worker 1: agent-opencode como opción generalista
El modelo elegido para el worker general fue:
opencode-go/deepseek-v4-flashNo porque sea «el mejor modelo» en términos absolutos, sino porque necesitaba una opción rápida y suficientemente capaz para la mayor parte de las tareas que quiero descargar de Codex: implementar una feature acotada, corregir un bug, refactorizar un módulo moderado, escribir pruebas o hacer cambios en varios archivos cuando la tarea está bien especificada.
La skill fija el modelo. No quiero que el worker cambie silenciosamente a otro proveedor porque un identificador falle. Un sistema de agentes es mucho más fácil de entender cuando cada nombre conserva una identidad estable.
El runner actual ya no es solo una llamada mínima a opencode run. Tiene un contrato de ejecución y observabilidad común con los demás workers basados en OpenCode:
stdbuf -oL -eL \
  opencode \
    --print-logs \
    --log-level INFO \
    run \
    --model "opencode-go/deepseek-v4-flash" \
    --dir "$REPOSITORY" \
    --auto \
    --format json \
    --title "Codex agent-opencode $RUN_ID" \
    "$TASK" \
    2>&1 | tee "$LOG"

STATUS=${PIPESTATUS[0]}
Hay varias decisiones importantes ahí.
--auto sigue siendo fundamental. OpenCode tiene permisos que pueden estar en allow, ask o deny. Para un proceso desatendido, quedarse esperando una aprobación interactiva rompe la delegación. --auto autoaprueba los permisos que no estén expresamente denegados. Un deny sigue siendo un deny.
--print-logs y --log-level INFO hacen que el proceso resulte más observable desde el host. stdbuf -oL -eL reduce el buffering de stdout y stderr para que la información aparezca mientras el agente trabaja. tee conserva una copia del stream sin ocultárselo a Codex.
Y PIPESTATUS[0] evita un error clásico de shell: si OpenCode termina con código 1 pero tee termina correctamente con código 0, el wrapper no puede afirmar que todo salió bien. El estado importante es el del primer proceso del pipeline.
Esta pequeña línea:
STATUS=${PIPESTATUS[0]}es una de esas cosas aburridas que hacen que una automatización deje de ser una demo y empiece a ser fiable.
Worker 2: agent-free y el valor de tener un carril barato
El segundo worker usa:
opencode/big-pickleLa motivación no era tener «otro modelo más». Era tener una ruta que pudiera consumir para tareas sencillas sin gastar las cuotas de los workers más valiosos.
Hay mucho trabajo en programación que no merece el modelo más caro: resumir una zona del repositorio, generar documentación inicial, hacer una transformación mecánica, añadir casos de prueba evidentes, revisar un conjunto pequeño de archivos o preparar una primera hipótesis sobre un bug.
Para eso sirve agent-free.
Su existencia también mejora el router porque introduce una dimensión que normalmente se olvida: el coste es una restricción de routing, igual que la complejidad o la necesidad de herramientas.
Pero gratuito no significa «mándale cualquier cosa». Añadí una regla específica para no introducir deliberadamente en el prompt credenciales, claves, tokens, contenidos de .env, claves privadas, cookies de autenticación o secretos. De hecho, esa misma disciplina debería aplicarse a cualquier proveedor externo, aunque en el worker gratuito la dejé especialmente visible.
Una ventaja adicional de tener una skill separada es que puedo pedirla de forma explícita:
$agent-router enruta esta tarea usando el agente gratuitoNo hay heurística que discutir: el router respeta la elección.
El inconveniente también es claro. Si una tarea crece durante la ejecución y deja de ser sencilla, Big Pickle puede no ser el worker adecuado. La skill no cambia silenciosamente de modelo. Termina lo independiente, devuelve el bloqueo y deja al orquestador decidir el siguiente paso.
Eso es importante: los workers no se escalan solos a otro proveedor. La decisión de routing vuelve siempre a Codex.
Worker 3: MiniMax M3 sin renunciar a OpenCode
Con MiniMax apareció una decisión más interesante. Podía intentar usar una herramienta propia de MiniMax, o aprovechar que OpenCode ya estaba funcionando como harness y utilizar dentro de él el proveedor del plan de MiniMax.
Elegí lo segundo.
El identificador que usamos es:
minimax-coding-plan/MiniMax-M3La ventaja es arquitectónica: Codex no necesita aprender otro protocolo. agent-minimax se comporta igual que los otros workers OpenCode. El runner cambia de modelo, pero mantiene el mismo mecanismo de directorio, ejecución autónoma, logging, salida estructurada y estado final.
Además separa claramente dos cosas que a veces se mezclan: harness y modelo/proveedor. OpenCode es la infraestructura que ejecuta herramientas y mantiene el contexto de la ejecución; MiniMax M3 es el modelo que toma decisiones y genera el trabajo.
MiniMax queda definido como worker para trabajo largo y amplio: migraciones, refactors de repositorio, implementaciones extensas, cambios repetitivos y tareas con bastantes archivos o iteraciones.
No lo elegimos como «modelo difícil». Esa etiqueta es demasiado vaga. Una tarea puede ser conceptualmente compleja pero pequeña; otra puede ser trivial pero requerir modificar cien archivos. La duración y el volumen de ejecución forman parte del routing.
Las últimas pruebas también sirvieron para comprobar algo que buscaba desde el principio: el agente externo puede encontrarse con un problema de entorno, diagnosticarlo y recuperarse. En una ejecución real MiniMax llegó a un fallo relacionado con JAVA_HOME, localizó un JDK utilizable, reintentó la validación y terminó con los tests pasando.
El problema no fue que se recuperara. El problema fue que el host inicialmente resumió aquello como «MiniMax reintentó con el JDK disponible» sin enseñar con suficiente claridad los comandos utilizados. Esa experiencia terminó provocando uno de los últimos cambios de la arquitectura: la observabilidad debe ser una obligación del host y del worker, no una casualidad de la UI.
Worker 4: agent-agy y la autonomía de Antigravity
Antigravity era el caso que inició todo, y sigue siendo el worker más diferente.
agy dispone de un modo headless que permite enviar un prompt y recibir la respuesta sin abrir la interfaz interactiva:
agy \
  -p "$TASK" \
  --effort high \
  --output-format stream-json \
  --dangerously-skip-permissions \
  --print-timeout 30m
Aquí hay dos decisiones deliberadas.
La primera es --dangerously-skip-permissions. El nombre es honesto: autoaprueba las llamadas de herramientas, incluidas escrituras y ejecución de comandos. Eso es exactamente lo que quería para este worker concreto porque su función es encargarse de tareas muy agentic: investigar, compilar, modificar, volver a probar, corregir y repetir sin detenerse cada pocos minutos para pedir autorización.
No significa que «todo esté permitido» a nivel de intención. La skill sigue prohibiendo publicar cambios o ejecutar operaciones Git destructivas si la tarea original no las autoriza. El flag elimina fricción operativa; no elimina el contrato.
La segunda decisión es stream-json. Antigravity emite eventos durante la ejecución y eso permite que el host observe actividad real en vez de esperar una única respuesta final.
El wrapper de AGY se ha homogeneizado con los otros tres en todo lo que sí debe ser común: ejecución efímera, RUN_ID único, log por ejecución, tee, conservación del exit code y marcadores estándar de inicio y final. Lo que no hacemos es fingir que AGY y OpenCode son el mismo CLI. Cada skill conserva sus flags específicos.
La decisión que cambió el ciclo de vida: una tarea, un proceso
Una de las correcciones más importantes apareció al revisar qué ocurría con las sesiones de OpenCode que permanecían abiertas.
OpenCode permite sesiones persistidas, --continue, --session, --fork y conexión a procesos existentes con --attach. Son capacidades útiles, pero no deberían formar parte del camino normal de routing.
El contrato actual es mucho más sencillo:
1 routing = 1 host = 1 worker externo = 1 proceso efímeroPara los workers basados en OpenCode, una tarea normal crea un opencode run nuevo. Cuando termina la tarea, termina ese proceso. El historial de la sesión puede seguir persistido internamente por OpenCode, pero eso no significa que exista un proceso vivo.
Esta distinción entre sesión almacenada y proceso en ejecución es importante.
Una TUI de OpenCode que yo haya abierto manualmente no pertenece al router. El host no debe adjuntarse a ella, reutilizarla, cerrarla ni matarla. Del mismo modo, un routing nuevo no utiliza --continue, --session o --attach salvo que la tarea diga explícitamente que quiere continuar una ejecución anterior.
Eso evita que el estado invisible de una sesión vieja influya sobre un trabajo nuevo y hace mucho más sencillo razonar sobre paralelismo, logs y limpieza.
Con AGY aplicamos el mismo principio. Una ejecución normal crea un proceso nuevo. --continue o --conversation quedan disponibles, pero solo para continuaciones explícitas.
El bug más útil: ln: Read-only file system
Las primeras pruebas de esta nueva infraestructura produjeron un error que parecía apuntar directamente al sandbox del agente externo:
ln: Read-only file systemLa primera lectura era razonable: MiniMax no puede escribir, OpenCode no tiene permisos o el subagente host está atrapado en un filesystem de solo lectura.
Pero al seguir la cadena descubrimos algo bastante más instructivo.
MiniMax todavía no había arrancado.
OpenCode tampoco era quien estaba ejecutando el ln.
El comando problemático estaba en nuestro propio wrapper:
CURRENT="$LOG_DIR/current-${AGENT_NAME}.log"
ln -sfn "$LOG" "$CURRENT"
La primera versión guardaba logs bajo un directorio asociado a Codex y actualizaba un symlink current-agent-*.log para poder hacer tail -f fácilmente. El mecanismo era cómodo, pero introducía una escritura extra en una ruta que podía comportarse de forma distinta dentro del host.
Más importante todavía: el symlink era innecesario para la arquitectura final y no encajaba especialmente bien con ejecuciones paralelas. Si dos workers del mismo tipo arrancan a la vez, ambos compiten por el mismo current-agent-minimax.log.
La solución no fue «dar todavía más permisos». Fue quitar complejidad que ya no aportaba valor.
Eliminamos el enlace current-* y trasladamos los logs de routing a una ubicación efímera configurable:
LOG_DIR="${AGENT_ROUTER_LOG_DIR:-${TMPDIR:-/tmp}/codex-agent-router}"Cada ejecución genera después su propio identificador:
STAMP="$(date '+%Y%m%d-%H%M%S')"
RUN_ID="${STAMP}-$$-${RANDOM}"
LOG="$LOG_DIR/${AGENT_NAME}-${RUN_ID}.log"
Eso produce algo parecido a:
/tmp/codex-agent-router/
├── agent-opencode-20260910-132501-41021-17542.log
├── agent-minimax-20260910-132503-41034-23811.log
├── agent-free-20260910-132504-41045-9812.log
└── agent-agy-20260910-132506-41058-30115.log
No hay symlink compartido. No hay colisión por nombre. No dependemos de que ~/.codex sea el lugar adecuado para datos de ejecución. Y el propio log puede devolverse al host al terminar.
Este bug cambió mi forma de pensar sobre los fallos del sistema: antes de culpar al modelo externo, hay que saber en qué capa ocurrió realmente el error.
Fallo de infraestructura no es fallo del worker
A partir de ahí añadimos una distinción explícita a las cuatro skills.
Un fallo como estos:
read-only filesystem
missing executable
no se puede crear el directorio de logs
el launcher no encuentra una dependencia
el proceso externo ni siquiera llega a arrancar
es un fallo de infraestructura o launcher.
En cambio:
la implementación no compila
un test falla
el agente interpreta mal la tarea
una herramienta falla durante el trabajo
el modelo no consigue completar el objetivo
es un fallo del worker o de la tarea.
La diferencia no es académica. Determina qué debe hacer el host.
Si la infraestructura puede corregirse de forma segura sin cambiar de agente ni alterar la semántica de la tarea, el host puede arreglarla y reintentar. Pero debe conservar el primer error y explicar la recuperación. No quiero informes que digan simplemente «MiniMax terminó correctamente» cuando antes hubo dos intentos y un cambio de entorno.
Por el contrario, si MiniMax empieza a trabajar y falla en la implementación, el host no debe convertirse de pronto en programador y terminar el trabajo por su cuenta. Devuelve el bloqueo al padre. agent-router puede decidir después qué hacer.
Esa separación mejora tanto el debugging como la atribución.
De los cuatro workers al quinto componente: agent-router
Con cuatro skills independientes ya podía escribir:
$agent-opencode corrige este bug
$agent-minimax ejecuta esta migración
$agent-free documenta este módulo
$agent-agy investiga, compila y corrige hasta que pase
Pero seguía teniendo que elegir manualmente.
La quinta skill nació para resolver eso. Su nombre final fue agent-router.
Durante el diseño tuvimos una versión mucho más larga del SKILL.md: reglas sobre todos los flags de OpenCode, permisos de agy, comportamiento de Git, fallbacks, concurrencia, sesiones, verificación y multitud de ejemplos. Técnicamente era completa. También era una mala skill.
Una skill-router no debe duplicar el manual de cada worker. Cuanto más texto común metemos en ella, más contexto cargamos en cada decisión y más posibilidades existen de que una regla del router contradiga una regla específica del worker.
El router actual se concentra en unas pocas responsabilidades: interpretar «delega» y «enruta», escoger worker, preparar un handoff autocontenido, crear un host visible, controlar el paralelismo y devolver la verificación final al padre.
Las particularidades de opencode run, --dangerously-skip-permissions, los logs o el modelo fijo siguen viviendo en cada skill específica.
La decisión que lo simplificó todo: «delega» no es «enruta»
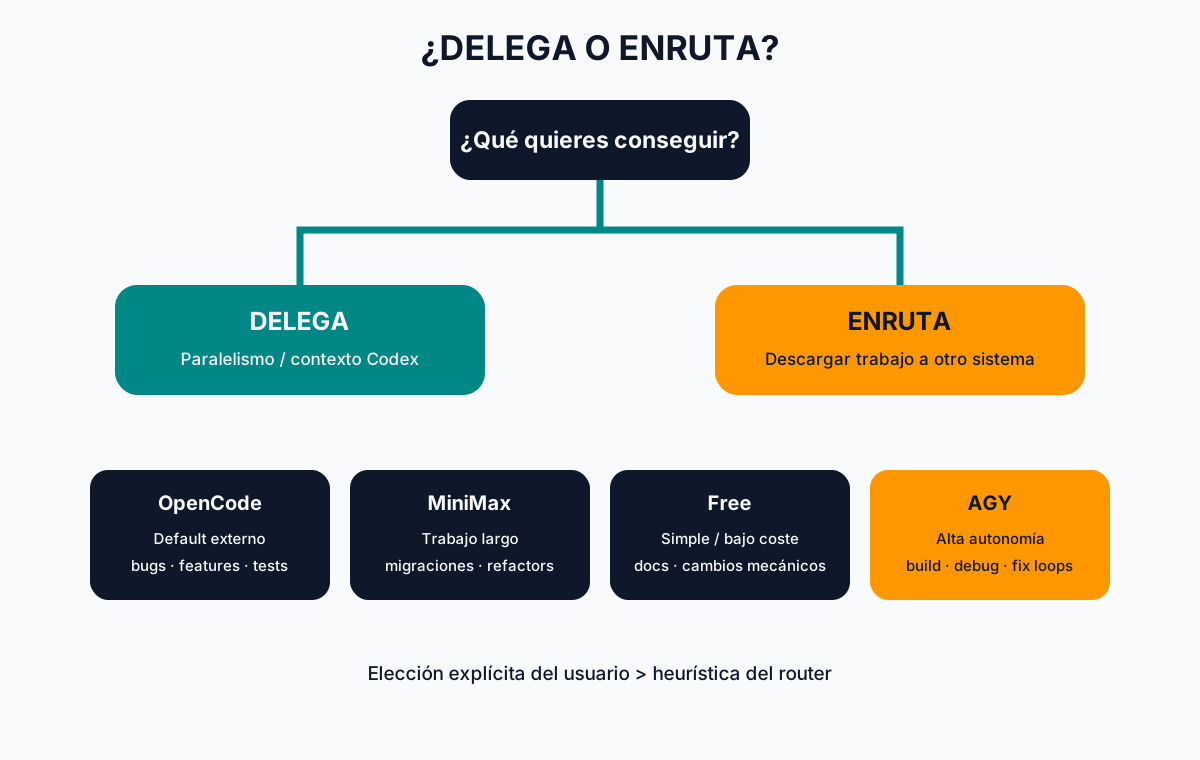
La ambigüedad más molesta era lingüística. Si digo «delega esto», ¿quiero un subagente de Codex o quiero sacar el trabajo a OpenCode? Ambos son formas de delegación en sentido humano.
En lugar de pedirle al modelo que adivinara cada vez, decidimos crear una pequeña convención de vocabulario.
Delegar significa usar agentes internos de Codex.
Enrutar significa usar un agente externo.
Eso permite escribir:
$agent-router delega la revisión del algoritmo y de los testsy esperar subagentes nativos de Codex.
Mientras que:
$agent-router enruta la implementación de esta tareasignifica que el trabajo real debe ir a uno de los cuatro workers externos.
Si además nombro el destino, mi elección gana:
$agent-router enruta esto a MiniMaxO:
$agent-router enruta esto con AntigravityEl router no intenta ser más listo que una instrucción explícita.
El host visible no es otro programador
En un routing externo, Codex crea un subagente host. Ese subagente es deliberadamente diferente de uno creado mediante «delega».
El flujo es:
Codex principal
    |
    +-- host "MiniMax · tarea"
            |
            +-- agent-minimax
                    |
                    +-- opencode run
                            |
                            +-- MiniMax M3
El host no implementa la tarea. No «aprovecha el tiempo» corrigiendo otra parte del fichero. No sustituye al worker si este tarda. Su trabajo consiste en lanzar, observar, mostrar progreso, esperar y devolver resultado y estado.
La prohibición de tocar el código por iniciativa propia no es decorativa. Evita que dos agentes escriban al mismo tiempo sobre el mismo working tree sin coordinación.
El padre, además, conserva la responsabilidad de integración y verificación final. Que el worker devuelva exit_code=0 es una señal importante, pero no convierte automáticamente el diff en correcto.
Observabilidad: no quiero un resumen, quiero saber qué pasó
Esta fue otra de las correcciones nacidas de las pruebas reales.
En una ejecución MiniMax consiguió completar una tarea, ejecutar el test enfocado, lanzar la suite completa y terminar con éxito. También se recuperó de un problema inicial de JAVA_HOME.
El informe del host decía básicamente que MiniMax había usado el JDK disponible y que todo pasó.
Era correcto, pero insuficiente.
Si el agente externo arregla el entorno, quiero poder saber:
1. qué comando falló;
2. qué error produjo;
3. qué cambio de entorno realizó;
4. qué comando reintentó;
5. cuál fue el resultado.
Lo mismo se aplica a builds, tests, Git y herramientas auxiliares.
No necesito la cadena de pensamiento privada del modelo. Necesito telemetría operacional.
Por eso el contrato de agent-router y de las skills externas exige ahora que el host exponga, cuando esté disponible, los comandos relevantes, errores, reintentos, cambios en variables como JAVA_HOME, PATH, SDK, Node, Gradle o XDG, y los comandos de validación.
El host puede resumir ruido. No puede convertir una recuperación importante en una frase vaga si tiene la información concreta delante.
También añadimos una regla explícita: el host nunca inventa un comando que el worker no haya mostrado. Si OpenCode solo devuelve un resultado semántico y no conserva el comando concreto, el informe debe decirlo en vez de reconstruir uno plausible.
Dos niveles de observabilidad: stream y log por ejecución
La UI del host es la primera capa. Los wrappers mantienen stdout y stderr visibles y, cuando el CLI lo soporta, utilizan formatos estructurados.
OpenCode trabaja con:
--format json
--print-logs
--log-level INFO
AGY mantiene:
--output-format stream-jsonLa segunda capa es el log de la ejecución:
/tmp/codex-agent-router/agent-minimax-<run-id>.logEl tee sirve para ambas cosas al mismo tiempo: lo que llega al host se conserva también en el fichero.
A diferencia del diseño inicial, ya no existe un current-agent-minimax.log global. El path del log forma parte del resultado del worker, así que el host puede consultarlo directamente si necesita reconstruir una acción que la UI resumió demasiado.
También normalizamos dos marcadores muy sencillos:
AGENT_ROUTER_START
worker=agent-minimax
run_id=...
repository=...
log=...
Y al final:
AGENT_ROUTER_RESULT
worker=agent-minimax
exit_code=0
log=/tmp/codex-agent-router/agent-minimax-<run-id>.log
status=success
No intento convertir Bash en un sistema de eventos empresarial. Solo quiero que el host pueda localizar de forma fiable dónde empieza y termina una ejecución y cuál fue su estado real.
El padre tiene que poder dar al host la autoridad necesaria
Otra lección de las primeras pruebas fue que un subagente no es una puerta trasera para elevar permisos.
Si el padre de Codex está restringido, crear un host y pedirle que tenga acceso completo no convierte mágicamente un filesystem de solo lectura en escribible. El host debe disponer de la autoridad necesaria desde la sesión que lo crea.
Esto importa porque el host es quien lanza el CLI externo. Antes de que OpenCode o AGY puedan decidir qué herramientas usar, su proceso necesita poder arrancar, leer el repositorio, escribir donde corresponda y crear sus ficheros temporales.
Por eso separo dos capas:
Codex / host
    -> autoridad del proceso exterior

OpenCode o AGY
    -> política propia de herramientas del worker
--auto actúa dentro de OpenCode. --dangerously-skip-permissions actúa dentro de AGY. Ninguno de los dos flags arregla una restricción del proceso padre anterior al arranque del CLI.
Esa distinción evitó seguir aumentando permisos del modelo equivocado cuando el fallo real estaba en nuestro launcher.
Paralelismo: Codex coordina, los workers ejecutan
Una vez que cada routing es efímero y cada run tiene su propio log, ejecutar varios agentes externos a la vez resulta mucho más razonable.
Pero hay que separar dos casos.
Para lectura:
Codex
├── Host A -> MiniMax analiza arquitectura
├── Host B -> DeepSeek revisa tests
└── Host C -> Big Pickle revisa documentación
No hay un problema especial mientras cada proceso tenga recursos suficientes.
Para escritura, en cambio, el peligro no está en OpenCode. Está en el working tree.
Dos modelos editando simultáneamente el mismo archivo pueden producir una carrera perfectamente clásica. El router actual establece por tanto una regla sencilla: escrituras paralelas solo cuando los scopes son claramente independientes o cuando cada worker trabaja en un Git worktree separado.
El diseño que quiero para tareas grandes es:
Codex
├── Host A -> MiniMax  -> worktree A
├── Host B -> DeepSeek -> worktree B
└── Host C -> AGY      -> worktree C
Codex mantiene la visión global, recibe resultados y decide cómo integrar.
No necesito esconder el paralelismo dentro de OpenCode. Prefiero que el orquestador principal sea quien sepa cuántos workers existen y dónde están trabajando.
El handoff: la parte menos vistosa y más importante
Un router puede elegir el modelo perfecto y aun así fracasar si manda un prompt mediocre.
Por eso agent-router tiene una responsabilidad previa: convertir mi petición en una tarea autocontenida para el worker.
Debe preservar el objetivo, módulo o repositorio relevante, restricciones, comportamiento esperado, criterios de verificación, ámbito de escritura, archivos prohibidos, si hay cambios previos que no pertenecen al worker y cualquier autorización Git explícita.
No debe copiar toda la conversación. Eso sería caro, ruidoso y potencialmente peligroso.
El worker solo necesita lo que afecta a su tarea. La skill funciona como frontera de contexto.
También añadimos una regla de privacidad: ningún handoff debería introducir deliberadamente secretos, tokens, claves, ficheros .env o información privada que no sea necesaria. En un sistema real, además, conviene revisar las políticas del proveedor al que se está enviando el código.
Routing también significa routing de datos.
Git: autonomía no significa publicación automática
Los cuatro workers pueden inspeccionar Git normalmente:
git status
git diff
git log
git show
Y pueden modificar los archivos necesarios para la tarea.
Lo que no deben hacer sin autorización explícita es commit, push, merge, force-push, reset destructivo, borrado de ramas o publicación.
Esta regla se mantiene aunque AGY utilice --dangerously-skip-permissions. Tener capacidad técnica no equivale a recibir autorización de producto.
También añadimos otra regla nacida del trabajo real: antes de atribuir un cambio al worker, el host y el padre deben distinguir los cambios que ya existían en el repositorio. Si el working tree estaba sucio antes de enrutar, el informe final no puede afirmar alegremente que todo el diff es obra de MiniMax.
Qué opciones seguimos exponiendo
OpenCode sigue ofreciendo:
--continue
--session <id>
--fork
--file <path>
--variant <variant>
--attach <url>
--thinking
No las hemos eliminado. Lo que ha cambiado es el default.
Una ejecución normal no reutiliza ninguna sesión. --continue, --session, --fork o --attach solo se utilizan cuando el handoff pide expresamente continuación o conexión a un contexto existente.
AGY conserva un criterio equivalente para --continue y --conversation.
La regla general es sencilla: las capacidades avanzadas existen, pero el camino normal debe ser fácil de razonar y reproducir.
Cómo decide agent-router qué worker externo utilizar
Cuando digo «enruta» sin nombrar destino, el router usa una clasificación deliberadamente sencilla.
agent-opencode es el default. Si no existe una razón clara para elegir otro worker, DeepSeek V4 Flash a través de OpenCode recibe la tarea.
agent-minimax se reserva para trabajos largos: migraciones, cambios amplios, refactors de repositorio, implementaciones repetitivas o tareas donde la duración y el número de iteraciones importan más que la respuesta rápida.
agent-free se usa cuando la tarea es sencilla, de bajo riesgo o cuando indico que quiero preservar cuota pagada.
agent-agy entra cuando la tarea necesita mucha autonomía y herramientas: ejecutar, diagnosticar, modificar, compilar, repetir y resolver un ciclo completo.
No es un clasificador científico. Es una política práctica y, sobre todo, predecible.
El usuario conserva siempre la última palabra. «Enruta a MiniMax» no se discute. «Usa el gratuito» tampoco.
La arquitectura actual
Después de las últimas iteraciones, el esquema real ya no es simplemente «Codex llama a cuatro CLIs». Es este:
                         Codex principal
                               |
                         $agent-router
                               |
             +-----------------+------------------+
             |                                    |
          "delega"                            "enruta"
             |                                    |
      Codex subagent                      Codex host subagent
      hace el trabajo                     supervisa solamente
                                                  |
                      +---------------------------+------------------------+
                      |             |             |                       |
              agent-opencode   agent-minimax   agent-free             agent-agy
                      |             |             |                       |
              proceso nuevo    proceso nuevo   proceso nuevo          proceso nuevo
                      |             |             |                       |
                   OpenCode      OpenCode      OpenCode                    agy
                      |             |             |                       |
               DeepSeek V4      MiniMax M3    Big Pickle            Antigravity
                   Flash
                      |             |             |                       |
                    log único por ejecución + exit code real + resultado
Cuando el proceso termina, el host devuelve el resultado y también termina.
No reutiliza la TUI que pueda tener abierta manualmente. No deja un OpenCode de routing ejecutándose por accidente. No comparte un symlink current-* con otros workers. Y no oculta un fallo del proceso detrás del éxito de tee.
Eso hace que cada routing sea una unidad de trabajo mucho más limpia.
Ventajas reales del sistema
La primera ventaja es evidente: una sola interfaz mental. Codex sigue siendo el lugar donde describo el trabajo, reviso el resultado y tomo decisiones.
La segunda es la separación de cuotas. Cada worker puede consumir un proveedor distinto. Una implementación larga puede ir a MiniMax, una tarea sencilla al worker gratuito y un ciclo agentic a Antigravity.
La tercera es la especialización sin lock-in del orquestador. agent-router conoce Skills, no APIs privadas de cada proveedor.
La cuarta es la observabilidad. Ahora no depende solo de «el proceso sigue vivo»: existe stream, log por ejecución, marcadores de inicio/fin y un contrato para conservar errores y reintentos.
La quinta es la reproducibilidad. Un trabajo nuevo empieza desde un proceso nuevo salvo que se pida continuidad expresamente.
La sexta es el paralelismo controlable. Los RUN_ID únicos y logs separados eliminan colisiones de infraestructura, mientras que la política de worktrees protege las escrituras.
La séptima es una atribución de errores mucho mejor. Podemos diferenciar si falló el wrapper, el entorno, OpenCode, AGY, el modelo, el build o los tests.
Y la octava quizá sea la más interesante para un indie: puedo reservar el modelo y la cuota que más valoro para aquello donde realmente aporta valor.
Inconvenientes y riesgos que no desaparecen
No hay orquestación gratis.
Crear un host consume recursos de Codex además de la cuota del proveedor externo. Lo hacemos porque la visibilidad y el control compensan el coste, no porque sea la ruta más barata imaginable.
El paralelismo sigue requiriendo disciplina. Tres logs independientes no impiden que tres agentes destrocen el mismo archivo si trabajan sobre el mismo working tree.
--dangerously-skip-permissions sigue siendo una opción potente y peligrosa si la tarea está mal acotada.
Las CLIs cambian. Los flags, identificadores de modelo, formatos de salida y rutas de datos necesitan mantenimiento.
La privacidad sigue formando parte de la decisión. Enrutar código es enviarlo a otro proveedor.
Y la UI de Codex todavía puede resumir más de lo que me gustaría. Precisamente por eso hemos reforzado los logs y las reglas de observabilidad.
Lo que haría después
La siguiente evolución natural es automatizar mejor los worktrees para tareas paralelas de escritura.
Quiero poder decir:
enruta estas tres tareas en paraleloy que el router pueda decidir si son solo lectura, si tienen ámbitos independientes o si necesita crear worktrees aislados antes de lanzar los hosts.
Otra mejora interesante sería recoger métricas de las ejecuciones: duración, exit code, número de reintentos, tamaño del diff, tests ejecutados y porcentaje de éxito por worker. Con suficientes datos, el routing podría pasar de una heurística manual a una política informada por experiencia real.
También queda abierta la posibilidad de un bridge interactivo para tareas donde el worker necesite una decisión humana. No quiero construirlo hasta que aparezca una necesidad repetida. El objetivo de este sistema sigue siendo reducir fricción, no construir una plataforma de agentes por el placer de construirla.
Qué hemos solucionado realmente
El problema no era «cómo ejecutar OpenCode desde Codex». Eso se resuelve con una línea de shell.
Lo que queríamos solucionar era esto:
¿Cómo puedo trabajar desde Codex como interfaz principal y, sin abandonar ese flujo, aprovechar otros agentes, modelos y cuotas de una forma entendible, observable y controlable?
Las Skills resolvieron el encapsulado.
Los runners resolvieron la ejecución autónoma.
Los procesos efímeros resolvieron el ciclo de vida.
Los RUN_ID y logs únicos resolvieron colisiones y mejoraron la trazabilidad.
PIPESTATUS[0] aseguró que el estado final pertenece al worker y no a tee.
La eliminación del ln -sfn quitó una dependencia innecesaria y un fallo de infraestructura real.
agent-router resolvió la elección.
La convención «delega/enruta» resolvió la ambigüedad humana.
Los host-subagents resolvieron buena parte de la observabilidad.
El streaming y los logs dieron un segundo canal cuando la UI no es suficiente.
Las reglas de recuperación obligan a mostrar lo que ocurrió cuando el agente arregla su propio entorno.
Y Codex sigue siendo quien integra, verifica y decide si el trabajo está realmente terminado.
A veces la mejor automatización no es la que elimina todas las decisiones. Es la que convierte veinte decisiones pequeñas en dos o tres decisiones que tienen sentido y deja suficientes señales para saber qué ocurrió cuando algo sale mal.
Referencias
- OpenAI — Codex
- OpenAI — Introducing the Codex app
- OpenAI Codex source — multi-agent
spawn_agent - OpenCode — CLI documentation
- Google Antigravity — AGY headless mode
- Google Antigravity — Using AGY CLI
- MiniMax — Token Plan
Cierre
No creo que haya encontrado «el orquestador definitivo». Lo que sí he conseguido es algo que me resulta más útil: un sistema pequeño que puedo explicar de memoria y, ahora, también depurar por capas.
Puedo decir «delega» y sé que Codex crea capacidad interna.
Puedo decir «enruta» y sé que el trabajo sale a un worker externo dentro de un host visible.
Puedo nombrar MiniMax, Antigravity, OpenCode o el agente gratuito cuando quiero controlar el destino.
Sé que cada routing normal crea un proceso nuevo y que ese proceso debe desaparecer al terminar.
Sé dónde encontrar su log concreto sin depender de un symlink global.
Sé que un exit_code=0 corresponde al worker real.
Y si el agente se recupera de un fallo de JAVA_HOME, build o entorno, el contrato exige conservar suficiente información para entender cómo lo hizo.
Cuando termina, Codex vuelve a ser el responsable de mirar el diff y decidir si aquello está realmente bien.
Para un flujo indie, donde las herramientas cambian cada pocos meses y las cuotas importan tanto como la calidad, esa combinación de flexibilidad, observabilidad y simplicidad vale más que una arquitectura enorme.
El objetivo no es tener muchos agentes.
El objetivo es conseguir que los agentes que ya tengo trabajen como un sistema.
También te puede interesar
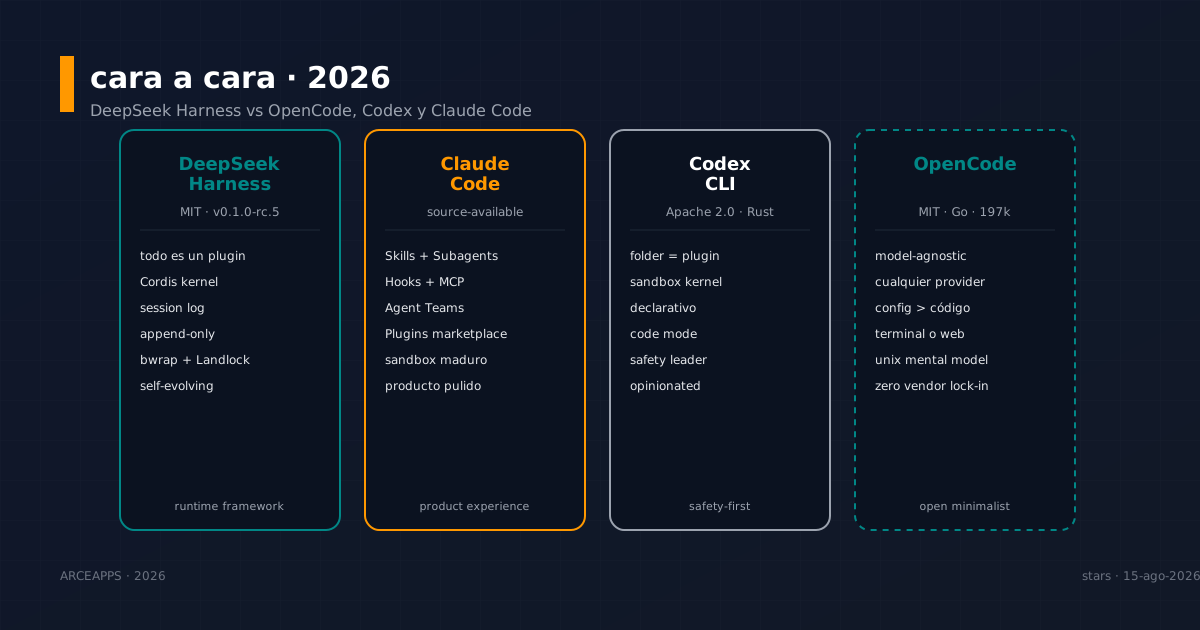
DeepSeek Harness vs OpenCode, Codex y Claude Code: cara a cara
Comparativa honesta entre DeepSeek Harness (dsh), OpenCode, Codex CLI y Claude Code. Filosofía, plugin model, sandbox, ecosistema y para quién gana cada uno en 2026.

DeepSeek Harness Desktop: análisis de su app
Descubre DeepSeek Harness Desktop: instalación, plugins, automatización, seguridad y límites reales de su nueva aplicación para agentes de IA.
SDD + TDD: del requisito a la prueba verificable
Aprende a combinar SDD y TDD con agentes de IA: especificaciones ligeras, criterios de aceptación, pruebas Red-Green-Refactor y revisión con CI.