
OpenViking: memoria y contexto compartido entre agentes
Índice de contenidos
La memoria no falla solo porque el agente olvide
La frustración más habitual al trabajar con asistentes de programación aparece al empezar otra sesión. Un agente que ayer conocía las decisiones de arquitectura del proyecto vuelve a preguntar por qué existe una dependencia, qué librería se descartó o qué requisitos de publicación son obligatorios. Sin embargo, la solución tampoco consiste en volcar todo el historial cada mañana. Cuanto más contexto irrelevante recibe, más difícil resulta encontrar la evidencia necesaria y más caro puede salir cada paso.
En artículos anteriores he explorado Mem0 y MemGPT/Letta, memoria persistente, servidores MCP para compartir recuerdos y Graphicle. Cada propuesta resuelve una parte: extracción, persistencia, recuperación, integración o relación con el código. OpenViking es interesante porque intenta situar documentos, memorias y skills bajo un modelo de contexto navegable, usando una interfaz inspirada en el sistema de archivos.
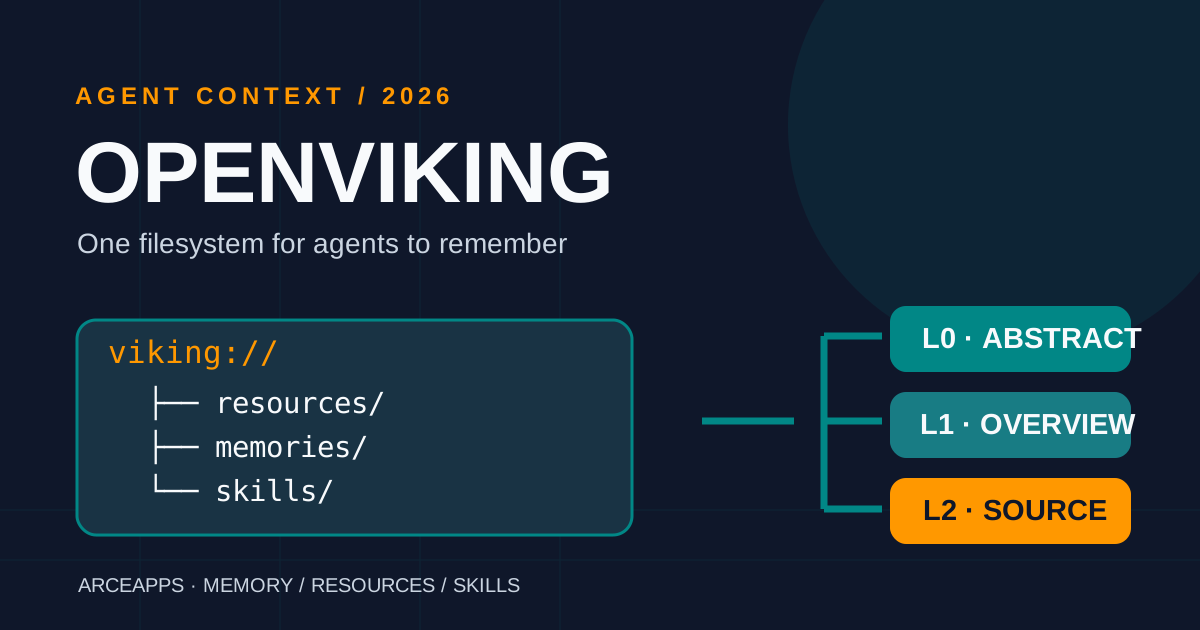
No es un simple directorio de notas Markdown ni una base de datos vectorial que responde a similitudes. La documentación habla de direcciones viking://, operaciones como listar, buscar y leer, niveles de representación L0/L1/L2, importación de recursos y extracción de recuerdos desde sesiones. La pregunta es si esta forma de organizar información ayuda al agente a recuperar mejores evidencias con un presupuesto de contexto más razonable.
Mi interés práctico es concreto: un sistema utilizado por varios agentes de programación debería permitir localizar decisiones duraderas, revisar de dónde proceden, controlar qué información es privada y detectar cuándo ha quedado obsoleta. Es un listón más exigente que «el servidor responde a una búsqueda».
Un sistema de archivos como interfaz, no necesariamente como implementación
Una de las decisiones más atractivas de OpenViking es exponer una interfaz conceptual parecida al filesystem. Puedes pensar en carpetas y documentos, navegar por rutas estables y recuperar el material original cuando sea necesario. Eso facilita razonar sobre el contexto desde una terminal o desde un agente equipado con herramientas.
La analogía tiene límites. Una ruta viking:// no debe confundirse con una ruta absoluta del disco local ni con una promesa de que todos los datos se guardan como archivos ordinarios. OpenViking integra procesamiento semántico, indexación y almacenamiento mediante servicios y componentes internos. La representación de directorio es una forma de acceder a la información; la persistencia real depende de la configuración y del backend.
La documentación distingue recursos, memorias y skills. Los recursos representan conocimientos importados, como documentación o código. Las memorias conservan información extraída o registrada a lo largo de sesiones. Las skills contienen instrucciones y materiales reutilizables para tareas. Colocar estas categorías bajo una interfaz común permite combinar navegación determinista y recuperación semántica sin obligar al agente a consumir todo el contenido.
Esta idea resulta familiar a cualquiera que use Git, Markdown u Obsidian. La diferencia es que OpenViking intenta automatizar procesamiento, indexación y recuperación, no solo ofrecer una estructura manual de carpetas. Esa automatización es útil mientras sea inspeccionable: cuando una herramienta transforma contenido, quiero saber qué versión resumió, qué perdió y cómo llegar al original.
Recursos, usuario y agente no significan el mismo ámbito
El producto documenta direcciones del tipo viking:// con distintos ámbitos de contenido. En una arquitectura compartida conviene separar información común, datos asociados a un usuario y elementos que un agente puede reutilizar. La forma de las rutas es útil precisamente porque obliga a pensar quién debería poder ver cada cosa.
Imagina un repositorio público de documentación, una decisión privada sobre un proyecto y una skill de validación reutilizable. Los tres pueden describirse como contexto, pero no tienen los mismos requisitos de acceso. Una búsqueda capaz de recuperar todo sin restricciones puede ser cómoda en un prototipo, pero peligrosa en un servidor con múltiples proyectos o identidades.
OpenViking incluye mecanismos de identidad, ACL y aislamiento multitenant en su documentación. Eso no autoriza a declarar que una instalación determinada esté protegida automáticamente. La política depende de cómo se configuran el servidor, los tokens, los ámbitos de usuario, las rutas y las herramientas que consultan la información. Conviene comprobar esos límites antes de conectar agentes que ejecuten acciones reales.
Una regla que aplicaría es simple: primero decidir la propiedad de cada pieza de contexto; después importar; finalmente habilitar herramientas de búsqueda con el menor alcance necesario. Cambiar ese orden suele convertir una base de memoria en un repositorio de secretos que demasiados procesos pueden consultar.
El modelo L0/L1/L2: una escalera de lectura
El corazón del enfoque es la recuperación por capas. En lugar de entregar el documento completo a cualquier consulta, OpenViking utiliza representaciones breves para orientar la búsqueda y una lectura del original cuando el agente necesita precisión. Los niveles son conceptualmente sencillos, pero sus detalles importan.
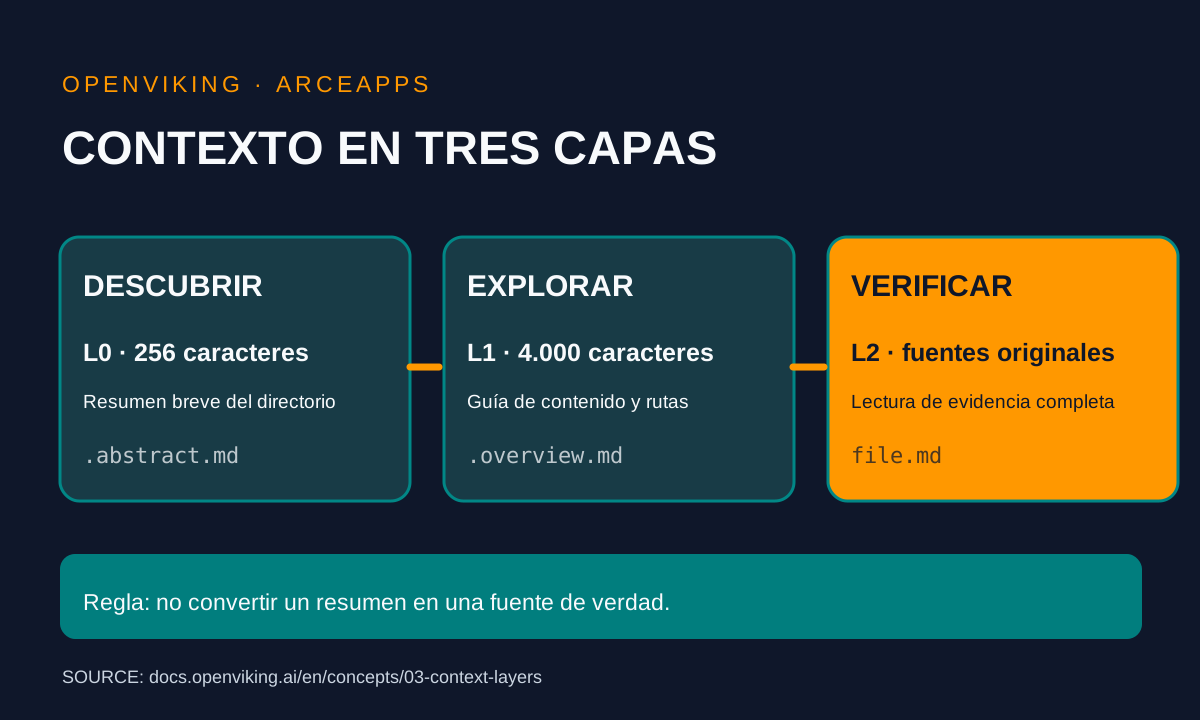
L0, almacenado como .abstract.md en un directorio, es una descripción muy corta que puede utilizarse para búsqueda vectorial y filtrado rápido. La documentación técnica indica un presupuesto de cuerpo generado por defecto de 256 caracteres. Es una pista de relevancia, no un resumen completo ni una fuente de verdad suficiente para modificar código.
L1, .overview.md, amplía la explicación de un directorio. Su presupuesto de cuerpo generado por defecto es de 4.000 caracteres y sirve para orientar navegación y reranking. Puede explicar qué contienen las subcarpetas, qué documentos interesan a determinadas preguntas y qué rutas merece la pena abrir. Sigue siendo una representación derivada, susceptible de omisiones.
L2 es el contenido fuente: archivos y subdirectorios originales, disponibles bajo demanda. Es la capa que hay que leer para confirmar detalles, copiar un fragmento de configuración o comprobar si una afirmación de L1 refleja la versión actual. Los presupuestos de L0 y L1 no fijan un límite uniforme para L2.
Una precisión de la documentación evita muchas comparaciones incorrectas: L0 y L1 son sidecars de directorio, no dos resúmenes automáticos para cada archivo individual. Los resúmenes de archivos pueden alimentar la visión del directorio, pero no conviene presentar la estructura como una tripleta idéntica por documento.
Por qué la navegación jerárquica puede ahorrar contexto
Cuando un agente intenta resolver una tarea, no siempre necesita la misma cantidad de información. Para decidir dónde buscar basta a veces un mapa. Para comprender una arquitectura necesita algo más. Para editar una función precisa leer código original y dependencias concretas. El modelo L0/L1/L2 refleja esas tres necesidades.
Un enfoque ingenuo cargaría diez documentos completos antes de responder. Uno jerárquico puede recuperar primero cinco descripciones breves, seleccionar dos vistas generales y abrir finalmente un par de fuentes. El ahorro potencial es intuitivo, pero no basta para prometer un porcentaje. La selección por capas añade procesamiento e índices; una mala descripción puede descartar precisamente el documento correcto.
La eficiencia debe medirse en toda la tarea, no solo en los tokens que devuelve una consulta. Si ahorrar una lectura provoca dos recuperaciones adicionales o una decisión errónea, la reducción de contexto deja de ser una victoria. Tampoco hay que olvidar el coste de generar resúmenes, embeddings, fusionar recuerdos y mantener índices actualizados.
Una evaluación honesta compara la misma tarea usando archivos planos bien organizados, búsqueda de texto, recuperación semántica y enfoque jerárquico. Mide evidencia correcta recuperada, tokens enviados al modelo, latencia completa y resultado final. Si solo comparas el tamaño de L0 con el documento original, estás midiendo una obviedad, no la calidad del sistema.
Importación y procesamiento: el trabajo que ocurre antes de buscar
Las herramientas de memoria suelen resultar convincentes durante una demostración en la que ya existe un índice perfecto. En el mundo real hay que construirlo. OpenViking describe un flujo de ingestión donde los recursos se analizan, organizan en una estructura navegable, procesan semánticamente y se incorporan a índices de búsqueda.
La documentación actual menciona importación de documentos, código, páginas web y algunos medios; determinadas modalidades requieren componentes compatibles de comprensión multimodal. No significa que cualquier URL o repositorio produzca automáticamente conocimiento fiable. Hay formatos difíciles, ficheros demasiado grandes, contenido duplicado y fuentes que cambian después de importarse.
Para un repositorio de software, el punto crítico es la frescura. Si una guía de arquitectura dice que usamos una biblioteca que fue eliminada ayer, recuperar esa guía con mucha precisión no resuelve nada. El sistema puede actualizar representaciones y ofrece mecanismos de refresco, pero hay que comprobar cuándo se disparan y qué hace el agente si encuentra una referencia antigua.
Tampoco debe confundirse una importación completada con una indexación semántica terminada. Algunos pasos ocurren en colas o procesos separados. Si la herramienta permite inspeccionar estado, usaría ese dato antes de confiar en que un documento recién incorporado ya es recuperable por todas las rutas.
Memoria de sesiones: almacenar no es consolidar
El segundo flujo relevante parte de las conversaciones. OpenViking puede registrar sesiones y, al comprometerlas o archivarlas, desencadenar extracción y consolidación de memoria conforme a una política. La documentación describe procesamiento posterior, clasificación por tipos y operaciones de fusión o deduplicación con ayuda de modelos.
Aquí aparece un problema diferente de la búsqueda documental. Una conversación contiene hechos útiles, hipótesis descartadas, errores transitorios y afirmaciones que el usuario puede corregir posteriormente. Convertir todo eso en memoria permanente de manera automática es arriesgado. La extracción debe distinguir una decisión confirmada de una posibilidad explorada.
Imagina que un agente propone migrar una base de datos y el desarrollador responde que lo evaluará más adelante. Un sistema ingenuo podría almacenar «se decidió migrar». El recuerdo es conciso, recuperable y falso. Ninguna búsqueda vectorial puede compensar la pérdida de modalidad o estado de decisión durante la consolidación.
Para decisiones importantes, diseñaría un circuito de revisión: recuerdos propuestos, procedencia de sesión, estado provisional o confirmado y opción de corregir o eliminar. Después comprobaría cómo se propagan las correcciones a resúmenes e índices. No hay que dar por supuesto que borrar un archivo elimina instantáneamente todas sus copias derivadas.
CLI, API, SDK y MCP: compatibilidad no es portabilidad completa
OpenViking ofrece formas diferentes de acceso: CLI, API, SDK y MCP. La documentación oficial muestra instalación de la CLI mediante npm y una interfaz de operaciones conocida: listar, buscar, leer, escribir o inspeccionar estructura. Esto abre la posibilidad de conectar varios clientes a un mismo servicio de contexto.
npm install -g @openviking/cliEl comando procede de la documentación oficial; aquí no afirmo haber instalado ni probado la herramienta en el equipo del lector. Antes de utilizarla conviene revisar requisitos de versión, configuración de servidor y autenticación de la release concreta.
MCP facilita que algunos agentes usen herramientas homogéneas sin integrar una API propietaria a mano. Pero decir «compatible con MCP» no garantiza que todas las funcionalidades sean accesibles en todos los clientes, ni que se respeten automáticamente permisos o políticas de memoria. Una integración puede ofrecer solo búsqueda y lectura, mientras otra añade gestión de sesiones o escritura.
Además, compartir contexto no implica compartir la memoria interna de un proveedor como ChatGPT o Claude. Lo que se comparte es el contenido del servicio que ambos clientes puedan consultar. Si una decisión solo vive en una memoria propietaria no exportada, OpenViking no puede recuperarla por arte de magia. Este matiz evita una promesa de interoperabilidad excesiva.
Comparación con Mem0, Letta, Graphicle y archivos Markdown
No hay un «mejor sistema de memoria» independiente del problema. Mem0 se centra en extracción y recuperación de hechos y cuenta con enfoques de almacenamiento configurables. Letta desarrolla una arquitectura de agentes con memoria y gestión de contexto. Graphicle combina grafo de código, documentos, sesiones y relaciones con símbolos. Los archivos Markdown, por su parte, ofrecen legibilidad, bajo coste y control directo.
OpenViking reúne recursos, memoria y skills bajo una estructura navegable con recuperación por niveles. Esa amplitud resulta atractiva para asistentes que necesitan mezclar documentación, decisiones y herramientas reutilizables. El precio es una superficie operativa mayor: índices, colas, extracción, almacenamiento y políticas de acceso.
Compararía OpenViking con Graphicle cuando el problema sea mantener contexto verificable sobre repositorios. Lo compararía con Mem0 cuando necesite extraer preferencias o hechos de conversaciones. Lo compararía con un directorio Markdown y grep cuando la escala todavía sea pequeña y la simplicidad tenga más valor que la búsqueda semántica.
Estas son categorías analíticas, no resultados de un benchmark que haya ejecutado. Las herramientas evolucionan, y algunas se solapan. La comparación correcta debe partir de tareas representativas y versiones fijadas, no de una lista de casillas marcada por documentación comercial.
Un protocolo pequeño para poner a prueba la memoria compartida
Antes de trasladar una colección entera de decisiones a OpenViking, prepararía un experimento con tres agentes o clientes y un conjunto pequeño de documentos. Un cliente incorpora una decisión confirmada con fuente; otro intenta recuperarla desde un contexto diferente; el tercero comprueba qué ocurre cuando la decisión se modifica o se elimina.
El conjunto de prueba incluiría preguntas sencillas, otras que requieran combinar dos documentos y algunas sin respuesta. Estas últimas son especialmente importantes: un sistema que devuelve siempre algo puede parecer útil hasta que induce al agente a inventar. Para las preguntas multi-hop interesa comprobar si los fragmentos recuperados contienen toda la evidencia necesaria, no solo una coincidencia superficial.
Registraríamos precisión de recuperación, procedencia, latencia, volumen de contexto, coste de importación y mantenimiento, y acceso entre usuarios. Una prueba de privacidad intentaría recuperar intencionadamente una memoria fuera de ámbito. El resultado correcto es rechazar o no devolver datos, aunque el índice sepa dónde están.
Repetiría el experimento tras cambiar documentos, interrumpir un proceso a mitad de escritura y reiniciar el servicio. La persistencia fiable se demuestra con recuperación y consistencia, no simplemente con la existencia de archivos en disco.
Versionado, concurrencia y recuperación tras fallos
Un sistema de contexto compartido es también un sistema de almacenamiento. Dos agentes pueden intentar actualizar la misma memoria; una importación puede interrumpirse; un índice puede quedarse por detrás del archivo original. Estos casos son menos vistosos que una búsqueda semántica, pero determinan si confiaría en la herramienta.
OpenViking documenta bloqueos por ruta, gestión de estados de cola, escritura en distintos almacenamientos y recuperación de fallos. Tener documentación sobre esos mecanismos es positivo, aunque no equivale a una garantía absoluta. Para evaluar fiabilidad conviene ensayar los casos de carrera pertinentes a la versión y configuración elegidas.
La documentación también habla de snapshots respaldados por Git para ciertos contenidos. Debe entenderse su alcance: restaurar archivos no significa reconstruir automáticamente el histórico de ACL o de todos los índices vectoriales. Confundir backup de contenido con restauración completa de servicio crea falsas expectativas.
En proyectos indie prefiero una estrategia clara: exportación legible, copia comprobada, restauración ensayada y posibilidad de volver a una solución simple si el servidor deja de funcionar. Una memoria que solo vive en un sistema opaco es un riesgo de dependencia, aunque ese sistema sea open source.
Seguridad, licencias y costes reales
El repositorio oficial de OpenViking utiliza licencia AGPL-3.0, un dato relevante para evaluar integraciones o distribución de servicios. La licencia no se reduce a «es gratis»: conviene revisar obligaciones aplicables al uso y modificación concreta. Para un laboratorio personal es distinto de ofrecer un servicio modificado a terceros.
También hay costes de operación. Las capas L0/L1, embeddings, indexación, extracción de memoria y deduplicación pueden implicar modelos o recursos de cálculo. La documentación admite distintos proveedores y configuraciones. El presupuesto depende de cuántos documentos importas, con qué frecuencia cambian y cuántas sesiones consolidan recuerdos.
No asumo que un despliegue local sea automáticamente privado. Hay que revisar si embeddings y extracción salen hacia APIs externas, dónde se guardan los datos, qué servicios están expuestos, si MCP tiene autenticación y qué usuarios pueden consultar cada ámbito.
Mi lista de comprobación empieza por credenciales de mínimo privilegio, almacenamiento no público, configuración de red, límites de tamaño, actualización de dependencias y controles de acceso. Solo después conectaría a la herramienta un agente que pueda leer o modificar repositorios sensibles.
¿Lo incorporaría a mi flujo de desarrollo?
Mi respuesta es condicional. Para un proyecto pequeño, con una docena de decisiones y un único agente, Markdown bajo control de versiones y búsqueda local sigue siendo una solución excelente. Introducir una base de contexto con procesos de indexación, políticas y mantenimiento podría añadir más complejidad que valor.
Empezaría a considerar OpenViking cuando aparezcan varias fuentes que cambian, varios clientes que necesitan el mismo contexto verificable, y una carga de búsqueda manual suficientemente alta. Ahí la interfaz común, la recuperación jerárquica y la trazabilidad pueden justificar el coste. Incluso entonces probaría primero con una colección acotada, sin mover toda la documentación de golpe.
Me parece especialmente atractivo su modelo de lectura progresiva, porque obliga a distinguir descubrimiento de evidencia. El agente puede navegar con un resumen, pero debe abrir la fuente cuando la tarea requiere precisión. Esa disciplina es transferible a cualquier stack, aunque no instales OpenViking.
No compraría, en cambio, la promesa de que la memoria compartida elimina por sí misma las contradicciones, la caducidad o las decisiones inventadas. Esos problemas requieren procedencia, versionado, revisión y buenos criterios de recuperación.
Lecciones y decisión práctica
De esta revisión me quedo con cinco lecciones. Primero: unificar interfaces simplifica el acceso, no necesariamente la semántica. Segundo: los resúmenes L0/L1 facilitan navegación, pero no sustituyen el contenido L2. Tercero: extraer recuerdos exige conservar el estado de las decisiones. Cuarto: compartir memoria obliga a diseñar permisos antes de conectar clientes. Quinto: la persistencia debe poder probarse mediante restauraciones y cambios concurrentes.
La pregunta correcta no es «¿OpenViking es mejor que Mem0?». Es «¿qué necesito recuperar, quién debe poder verlo, cuánta evidencia hace falta y cuánto mantenimiento puedo asumir?». A veces la respuesta será OpenViking. A veces un archivo bien organizado y una búsqueda sencilla seguirán ganando.
Para quienes construimos aplicaciones y herramientas en nuestro tiempo libre, el contexto más valioso no es el que acumula más información. Es el que permite volver a trabajar con criterio, sin reexplicarlo todo y sin convertir cada sesión en un nuevo riesgo de privacidad.
Bibliografía y fuentes
- Repositorio oficial OpenViking, código, licencia y releases.
- Documentación: introducción, tipos de contexto y sesiones.
- Documentación: capas L0/L1/L2, presupuestos por defecto y estructura de directorios.
- Roadmap de OpenViking, implementado y previsto.
- Web y mecanismos de importación, CLI, MCP y procesamiento.
- ArceApps: Graphicle, Mem0/Letta y memoria cross-agent.
Cierre. La memoria de un agente debe ser útil cuando la necesita, inspeccionable cuando se equivoca y silenciosa cuando no aporta nada. OpenViking propone una arquitectura interesante para lograrlo, pero la prueba de verdad está en nuestras propias tareas, permisos y datos.
También te puede interesar
AgentMemRec: memoria IA como sistema de recomendaciones
Analiza AgentMemRec, la propuesta para seleccionar recuerdos con BM25, ranking y presupuestos de contexto sin llamadas LLM durante la recuperación.
Graphicle: grafo de código y memoria para agentes IA
Descubre cómo Graphicle conecta código, documentación y memoria para agentes IA; analizamos su arquitectura, privacidad, benchmarks y alternativas.
Memoria IA: qué dicen los benchmarks de Mem0 y Letta
Compara con rigor benchmarks reproducibles de Mem0, Letta, Graphiti y LangMem: muestras, recuperación, latencia, costes y límites antes de elegir.