
AgentMemRec: memoria IA como sistema de recomendaciones
Índice de contenidos
Un buen recuerdo que nunca llega al contexto no sirve
Durante años hemos hablado de memoria de agentes como si la dificultad principal fuera guardar información. Almacenar notas, extraer hechos, escribir archivos, crear grafos y resumir sesiones parecía acercarnos a un asistente que no olvidase nada. Sin embargo, cada nueva petición obliga a realizar una operación más importante y mucho más repetida: elegir cuáles de todos esos recuerdos llegan realmente al modelo.
Un agente puede tener registrada una decisión arquitectónica correcta y aun así actuar como si no existiera. Puede recuperar una nota que menciona la misma biblioteca pero describe una decisión antigua. O puede recuperar uno de los dos hechos necesarios para entender que una reunión cambió de fecha. En ninguno de esos casos falla necesariamente la persistencia; falla la selección de evidencia.
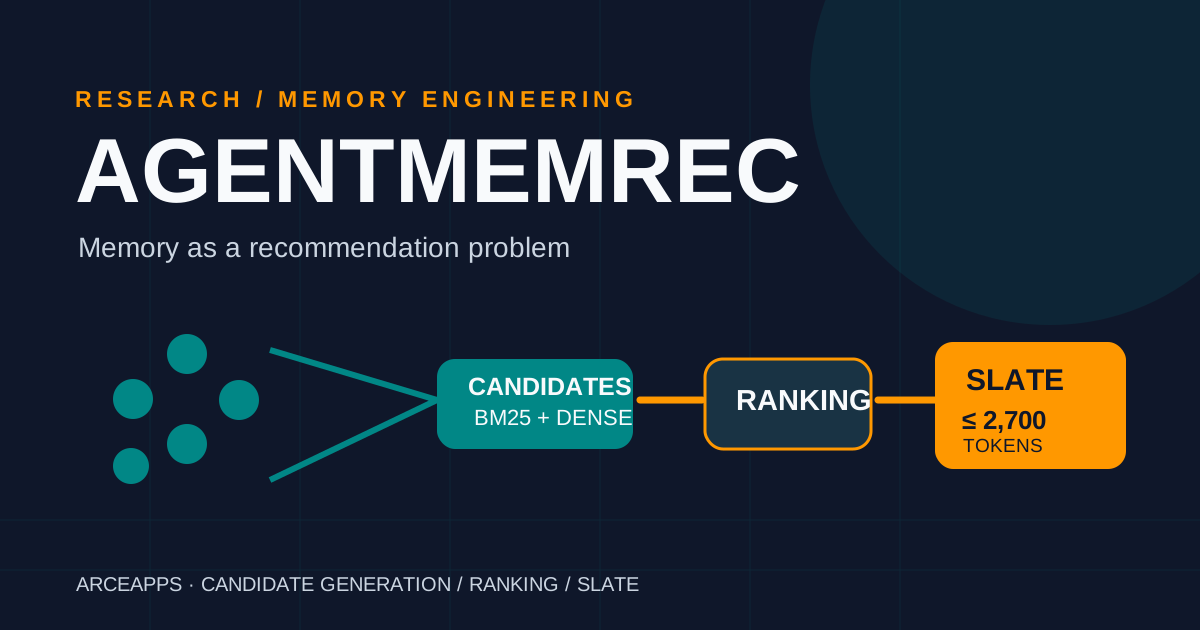
El preprint Agent Memory as Recommendation, presentado por Xinyu Zhang y Weiwei Sun el 26 de octubre de 2026, propone mirar este problema desde un lugar diferente: los sistemas de recomendación. En lugar de tratar la memoria como una biblioteca donde se buscan párrafos sueltos, considera que cada consulta necesita una selección de elementos relacionados que compiten por un presupuesto fijo, como los productos o vídeos que un recomendador decide mostrar.
No es un artículo introductorio sobre Mem0 ni una repetición de mi guía de memoria persistente. Es una investigación sobre el cuello de botella de la recuperación. Conviene leerla junto a Mem0 y Letta y los métodos jerárquicos, pero su aportación central es otra: formalizar qué significa construir un contexto suficiente y cómo medir cada etapa que lo construye.
El cambio de perspectiva: memoria como una recomendación de conjunto
En un recomendador clásico hay un catálogo grande, un usuario o petición concreta, una función que recupera candidatos, un ranking y una selección final que cabe en una pantalla. En memoria agéntica el catálogo es el historial, la petición es la pregunta, los elementos son fragmentos de conversaciones y la lista final es el contexto que recibe el modelo.
Los autores llaman slate a esa selección completa. El valor no se juzga de forma independiente para cada recuerdo, sino por lo que el modelo puede responder al leer el conjunto. Una pregunta sobre cuándo cambió una actividad puede requerir una nota antigua que dice «martes» y otra posterior que dice «ahora jueves». Ninguna basta por sí sola. La respuesta correcta depende de reunir las dos y entender su orden temporal.
Este enfoque explica por qué optimizar solo similitud semántica puede ser insuficiente. Un fragmento muy parecido al enunciado puede ser irrelevante si repite información ya recuperada. Otro menos parecido puede contener la condición que cambia totalmente la respuesta. El problema es la cobertura de evidencia, no la belleza del primer resultado.
El modelo también impone un límite: hay un número máximo de tokens disponible para recuerdos. En LongMemEval-M los autores describen historiales de unas quinientas sesiones y aproximadamente 1,5 millones de tokens, frente a un contexto recuperado de alrededor de 2.700 tokens. Elegir qué entra es inevitable. No existe «meterlo todo» como solución universal.
Las cuatro piezas de cualquier sistema de memoria
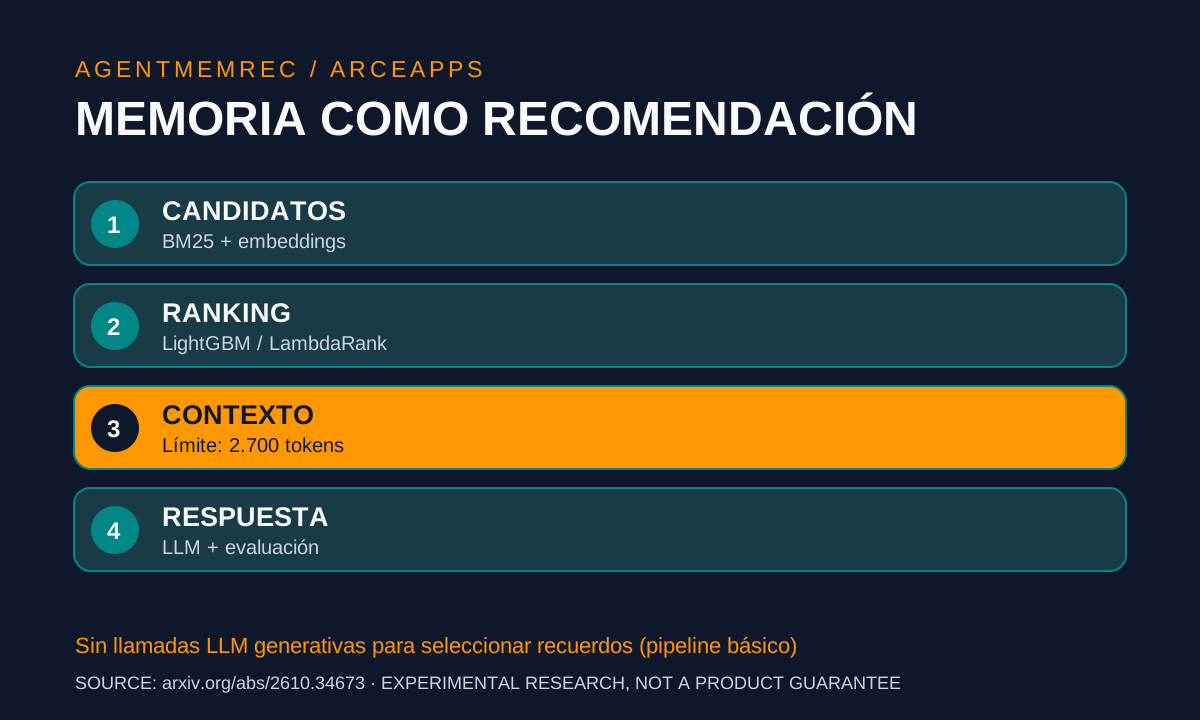
El paper formaliza un diseño como una cascada de cuatro etapas. Primero, una transformación de escritura que decide qué unidades representan el historial. Segundo, la generación de candidatos, que reduce millones de posibilidades a un conjunto manejable. Tercero, un ranking que ordena los candidatos. Cuarto, un ensamblador que llena el presupuesto de contexto.
Esta descomposición permite comparar arquitecturas muy distintas bajo preguntas comunes. Memorias construidas con LLM pueden gastar mucho trabajo preparando resúmenes; otros sistemas leen fragmentos originales; algunos consultan grafos y otros aplican un reranker. La función cambia, pero cada etapa afecta a cuánto material útil sobrevivirá hasta la respuesta.
Lo interesante no es decir que todas las herramientas son iguales. Es preguntar dónde se invierte el coste y qué mejora produce. Un modelo que genera cientos de notas puede obtener una gran representación, pero si la fase de búsqueda pierde una de las dos sesiones esenciales, la elaboración previa no sirve para esa pregunta.
AgentMemRec elige unidades cercanas a turnos originales y evita llamadas a modelos generativos en el proceso de selección por defecto. No significa «cero cómputo»: necesita índices, embeddings y un ranker aprendido. Tampoco elimina el LLM que contesta al final. La afirmación precisa es sin llamadas a un LLM generativo para construir y seleccionar recuerdos en el pipeline básico, no «sin inteligencia artificial».
Completitud del pool y del ranking
Los autores proponen distinguir dos probabilidades. La primera es la de que el conjunto candidato contenga toda la evidencia necesaria. La segunda es la probabilidad de que, una vez disponible esa evidencia en los candidatos, el ranking y el presupuesto permitan conservarla en el contexto final.
La completitud final de la selección se puede descomponer, bajo su construcción, como el producto de ambas. Una vez que un recuerdo esencial quedó fuera del pool, ningún ranker puede rescatarlo. Si el pool conserva los elementos correctos pero los relega al final, el presupuesto puede excluirlos igualmente.
El valor de esta descomposición es diagnóstico. Una herramienta puede fallar porque recupera demasiado pocos candidatos o porque los ordena mal. Son problemas diferentes: ampliar el pool no siempre ayuda si el ranking pierde calidad al enfrentarse a muchos distractores.
La formulación del artículo relaciona exactitud final con completitud del contexto y con la precisión del modelo cuando dispone o no de evidencia. Esa conexión no convierte cualquier porcentaje de recall en accuracy; es una estructura analítica que permite localizar cuellos de botella.
Los resultados reportados indican que una proporción sustancial de las mejoras de AgentMemRec procede de completar la evidencia, no de una capacidad misteriosa para razonar mejor. Es un hallazgo coherente con la intuición de que un modelo competente necesita recibir las piezas adecuadas antes de responder.
Etapa 1: candidatos mediante BM25 y embeddings
AgentMemRec combina dos canales baratos de recuperación. Uno usa BM25, que favorece coincidencias léxicas relevantes. El otro utiliza embeddings bge-m3 y similitud del coseno para buscar cercanía semántica. Los resultados se fusionan con Reciprocal Rank Fusion, usando k=60 en la configuración descrita por los autores.
La combinación tiene una justificación práctica. La búsqueda por palabras exactas puede recuperar una versión de biblioteca o un identificador que las representaciones vectoriales difuminan. La semántica puede recuperar una descripción conceptual aunque la pregunta emplee otros términos. Ninguno de los dos canales elimina los fallos del otro; mezclarlos reduce algunos puntos ciegos.
En la implementación central, los autores conservan un pool de hasta 128 turnos. Eligieron este tamaño con preguntas de desarrollo, considerando no solo si los candidatos contienen evidencia sino si el ranker puede convertirla en una selección completa. En sus condiciones, una agrupación de 128 mejoraba esa completitud frente a una de 64, pero no es una constante universal.
Aumentar candidatos también aporta más distractores, memoria consumida y tiempo de evaluación. La cifra óptima dependerá de las historias, del presupuesto y del ranker. No copiaría 128 a otro proyecto sin reproducir antes una prueba que demuestre su ventaja.
El propio artículo presenta la elección del pool como un equilibrio entre recuperar evidencia y hacer manejable la etapa siguiente. Es una perspectiva más útil que la consigna simplista «si falla el RAG, recupera más documentos».
Etapa 2: aprender a ordenar sin llamar a un LLM generativo
El ranking utiliza LightGBM con objetivo LambdaRank, una técnica conocida en sistemas de búsqueda y recomendación. En lugar de pedir a un LLM que puntúe cada turno, el método aprende a ordenar candidatos a partir de etiquetas de evidencia y un conjunto pequeño de características.
Los autores describen diez características por pareja pregunta-turno. Entre las señales de relevancia están similitud densa, rangos de BM25 y embeddings, posición en la lista fusionada y puntuación de un cross-encoder bge-reranker-v2-m3. Entre las señales contextuales aparecen papel de usuario o asistente, posición del turno en su sesión, antigüedad, longitud y coincidencias de entidades o claves extraídas.
El ranker se entrena con etiquetas de las preguntas de desarrollo: 152 preguntas y 19.456 parejas en la configuración principal, según el paper. Esa supervisión es fundamental. No se puede inferir que cualquier equipo instalará el sistema y obtendrá el mismo resultado sin disponer de etiquetas o de un modelo entrenado transferible.
Además, un cross-encoder sigue siendo cómputo de red neuronal. Que no exista una llamada a un LLM generativo no significa que el reranking no tenga coste o latencia. La comparación relevante es el coste medido de las etapas frente al de los métodos alternativos, en el mismo entorno.
Las pruebas de ablación atribuyen parte de la mejora a combinar relevancia y características de contexto. Esta es una pista valiosa: el orden temporal, el papel del hablante y la longitud del fragmento pueden importar tanto como la semejanza textual.
Etapa 3: completar el presupuesto con una slate
Después de ordenar, AgentMemRec recorre la lista y añade turnos cuyo coste renderizado cabe en el presupuesto. Si uno no cabe, lo salta y continúa. El coste considera también las cabeceras de sesión cuando corresponden, para mantener el contexto temporal.
El experimento principal utiliza un presupuesto de 2.700 tokens y examina pequeñas variaciones de 2.400 a 2.700. El ensamblador no corta la lista por un umbral dinámico de similitud; intenta utilizar el presupuesto de forma que contenga tanta evidencia útil como permita el orden del ranker.
Esta decisión está apoyada por una proposición del paper: si añadir elementos no reduce el valor del conjunto en las condiciones indicadas, una selección que llena el presupuesto no puede ser peor que un prefijo más corto que cabe en él. Pero la condición es importante. Si los fragmentos adicionales distraen al modelo, introducen contradicciones o contienen ataques, la monotonía deja de ser una garantía.
En producción yo no aplicaría la regla «rellenar siempre» de forma ciega. Probaría preguntas con documentos engañosos y hechos antiguos, y registraría si la información añadida disminuye precisión. El propio artículo investiga casos donde las hipótesis de independencia y utilidad de ranking individual empiezan a fallar.
La conclusión práctica es que ranking y ensamblado deben diseñarse juntos. Una lista excelente puede terminar siendo un contexto malo si se corta en el punto equivocado.
Qué dicen realmente los resultados de LongMemEval
La evaluación utiliza LongMemEval-S, con historias de alrededor de 50 sesiones, y LongMemEval-M, con unas 500 sesiones. Las preguntas relevantes para el resultado principal requieren evidencia de dos o más sesiones: 209 preguntas de test bajo el protocolo que describe el artículo.
Para LongMemEval-S, la tabla principal informa un 80,7 % con Qwen y un 89,4 % con DeepSeek para AgentMemRec, frente a 69,1/76,6 de Adaptive-k y 70,3/73,2 de T-Mem en las configuraciones estudiadas. En LongMemEval-M, AgentMemRec registra 70,0/81,3, frente a 59,3/62,1 de DynamicRAG-8B. Estas cifras proceden del paper, no de una reproducción propia.
El artículo resume ventajas de unos 10 a 31 puntos sobre las memorias y selectores comparados en LongMemEval-S, y ganancias que dependen del modelo y la variante de la prueba. En comparación con un reranker de LLM que puntúa 64 candidatos por consulta, AgentMemRec queda generalmente en paridad dentro del criterio estadístico definido por los autores, y supera alguna configuración de LongMemEval-M.
No debe olvidarse cómo se estableció esa paridad: distintos presupuestos de contexto, decodificaciones repetidas, bootstrap emparejado y un margen de no inferioridad definido por el estudio. Es un resultado más elaborado que comparar dos porcentajes, pero sigue siendo una evaluación de un preprint reciente que requiere replicación.
La variedad de baselines también importa. Algunos modelos de memoria incluyen numerosas llamadas generativas en escritura; AgentMemRec usa otro reparto de recursos. Sería injusto comparar sus cifras sin explicar ese coste trasladado.
Por qué la evidencia completa pesa tanto
En la investigación, la completitud de la selección de AgentMemRec alcanza alrededor de 0,94 en un análisis principal, frente a valores cercanos a 0,50 para algunos competidores que también renderizan turnos. Cuando dos sistemas reciben ambos una selección que contiene toda la evidencia, los autores no detectan diferencias significativas en varias comparaciones.
Eso sugiere que buena parte de la ventaja procede de recuperar y conservar los fragmentos adecuados. Es una tesis valiosa porque reduce el misterio: antes de invertir en una memoria cada vez más elaborada, quizá debamos medir si los hechos necesarios están realmente disponibles para el modelo.
El paper reporta también que ampliar el pool de candidatos mejora la cobertura de evidencia, y que LambdaRank consigue aumentar la completitud condicional del ranking sobre el orden inicial de recuperación. Esas observaciones permiten investigar cada etapa por separado.
Sin embargo, hay preguntas cuya respuesta no depende solo de poseer todas las citas. Hay que resolver tiempos relativos, distinguir hipótesis de decisiones, combinar relaciones y evitar deducciones incorrectas. La completitud es una condición útil, no una garantía de razonamiento correcto.
Un agente de programación puede tener los dos documentos que explican una migración y aun así modificar el archivo equivocado. Para evaluar agentes completos seguirán haciendo falta pruebas de comportamiento, no solo métricas de recuperación.
LoCoMo, memoria temporal y registros opcionales
En LoCoMo, el sistema base obtiene resultados que los autores sitúan por encima de Mem0 y Zep en sus configuraciones, sin llamadas generativas en escritura. También exploran una extensión opcional donde un LLM produce registros estructurados con fecha, entidades y referencias a turnos de la sesión.
Esa extensión ya no es «cero LLM en escritura». Es importante expresarlo claramente. El pipeline básico y la variante enriquecida tienen perfiles de coste distintos; fusionarlos en una sola afirmación promocional sería incorrecto.
Los registros pueden ayudar a interpretar referencias temporales como «el martes que viene», pero también introducen errores si se asigna mal la fecha. El estudio informa mejoras en algunos subconjuntos temporales y retrocesos en otros. Esto refuerza una lección fundamental: una característica útil en un benchmark puede perjudicar otro dominio.
En nuestros propios proyectos, las decisiones tienen fecha, estado y contexto. Me interesa más conservar esa procedencia explícita que confiar en una inferencia silenciosa sobre qué significa «ahora». Los modelos pueden ayudar a extraer, pero las decisiones relevantes deberían poder revisarse y corregirse.
Una memoria sin mecanismo para rectificar hechos antiguos acabará siendo una fuente de errores persistentes, aunque su recall sea alto.
Costes: qué significa «3,2 veces más barato»
El abstract habla de un coste de servicio aproximadamente 3,2 veces menor frente a un reranker que necesita 64 llamadas a LLM por consulta. En el cuerpo del artículo se especifica una comparación bajo una GPU A100 y un precio supuesto por hora, con mediciones de tiempo de GPU. En determinadas configuraciones se informa de unos 280 frente a 891 milisegundos-GPU por petición.
Eso es una comparación concreta de coste computacional del experimento, no una promesa universal de ahorro de factura. El precio cambia según proveedor, utilización, región, modelo y despliegue. Tampoco es correcto decir que el método no consume GPU porque no llame a un LLM generativo: embeddings, cross-encoder y ranking realizan trabajo.
El coste de escritura también puede diferir mucho. Los autores describen memorias con cientos o miles de llamadas generativas por historial, mientras su variante básica conserva turnos y realiza selección posterior. Pero un sistema que no condensa el historial puede almacenar más material o necesitar otros índices. El total de mantenimiento depende del patrón de uso.
Para medirlo en un proyecto real calcularía ingestión inicial, actualizaciones, tamaño de índice, coste por consulta, latencia y resultado final. No extrapolaría la cifra 3,2 de un laboratorio a una aplicación Android o un Mini PC sin medirlo allí.
La pregunta económica importante es si conseguimos respuestas correctas por unidad de recurso en nuestras tareas, no si una arquitectura presume de tener cero llamadas en una de sus etapas.
Las hipótesis del modelo y sus límites
La reducción teórica a ranking individual depende de hipótesis explícitas sobre independencia de evidencia y recompensa según la completitud del conjunto. En la realidad, dos recuerdos pueden ser redundantes, complementarios o contradictorios. Un detalle temporal puede cambiar el significado de todos los demás.
Los autores dedican parte del estudio a examinar cuándo la selección por items deja de bastar, especialmente cuando la evidencia se dispersa por tres o más sesiones y cuando aparecen fragmentos «casi correctos» que pueden distraer. El análisis es relevante para arquitecturas de memoria que aspiran a razonar, no solo a recuperar.
Otro límite es la transferencia. El ranker aprende con etiquetas de un benchmark específico. Puede funcionar bien sobre conversaciones similares, pero no sabemos cuánto conserva al pasar a repositorios de código, documentación jurídica, idiomas mezclados o instrucciones incompletas. La validación fuera de distribución es una tarea pendiente para cualquier adopción seria.
Además, lo publicado es un preprint de octubre de 2026, no una certificación independiente de producción. Aprecio que incluya tablas, desviaciones, protocolos y ablaciones; eso facilita examinarlo. No justifica convertir cada cifra en una promesa comercial.
La postura razonable es tomar el diseño como una hipótesis técnica interesante y reproducir las partes que importan antes de cambiar un stack existente.
Cómo lo probaría con memoria de decisiones de código
Diseñaría un conjunto de historias donde el desarrollador toma una decisión, la revisa, la descarta y finalmente adopta otra. Mezclaría nombres de librerías, fechas, versiones, rutas de archivos y criterios de arquitectura. Las preguntas exigirían recuperar hechos de varias sesiones sin incluir información ajena.
Usaría una base sencilla de turnos fechados, una búsqueda BM25, una recuperación vectorial y un baseline de texto plano. Luego implementaría una fase de ranking y ensamblado bajo el mismo presupuesto. Separaría las métricas de cobertura del pool, completitud de la slate, respuesta correcta y coste total.
El conjunto incluiría preguntas imposibles. Si un usuario nunca aprobó una migración, el agente debe contestar que no existe una decisión confirmada. Otra categoría comprobaría permisos: una memoria privada de otro proyecto no debería aparecer en la selección aunque su similitud sea alta.
No intentaría reproducir sin más el 80,7 % del paper sobre tareas distintas. Mi objetivo sería averiguar si el enfoque reduce decisiones incorrectas en el trabajo que realmente realizamos, y si el coste operativo se justifica frente a archivos versionados y grep.
Este es un protocolo propuesto, no una implementación que esté afirmando haber construido ahora.
Relación con Mem0, Letta y otras arquitecturas
No considero AgentMemRec una sustitución universal de Mem0, Letta o una memoria estructurada. Un sistema puede necesitar extraer preferencias y mantener hechos actualizados; otro necesita un agente que gestione su propio estado; un tercero requiere indexación de código con dependencias. AgentMemRec se concentra en qué información seleccionar al leer.
Precisamente por eso podría inspirar mejoras en sistemas existentes. Una memoria construida mediante extracción de hechos podría aportar unidades adicionales al catálogo; un índice de código podría suministrar candidatos; un ranker podría decidir cuáles merecen entrar en el contexto. Pero eso es una posibilidad arquitectónica, no una integración demostrada por el paper para cada producto.
La idea más potente es que escribir más recuerdos no arregla una recuperación mediocre. Antes de sumar otro grafo o una capa de resúmenes, inspeccionaría qué fragmentos llegan a cada respuesta y si contienen toda la evidencia.
En un flujo indie, donde el coste de mantenimiento cuenta tanto como los tokens, esa lección puede ahorrar más tiempo que instalar la siguiente herramienta de moda.
Conclusión: la memoria útil es la memoria que llega a tiempo
AgentMemRec cambia el foco de acumular memoria a seleccionar evidencia suficiente. Su combinación de candidatos léxicos y semánticos, ranking supervisado y construcción de contexto bajo presupuesto demuestra, en los resultados que publican sus autores, que el trabajo de selección puede competir con enfoques que invierten muchas más llamadas generativas.
Las cifras son prometedoras, con condiciones concretas: benchmarks LongMemEval y LoCoMo, modelos y splits definidos, una GPU de referencia y un ranker entrenado. No son garantía de producción ni sustituyen una evaluación sobre nuestro propio dominio.
Me quedo con una pregunta para cualquier memoria que conecte mañana a mis agentes: cuando responde mal, ¿faltaba el recuerdo, quedó fuera del pool, cayó en el ranking o estaba presente y el modelo lo interpretó mal? Poder distinguir esas causas es el primer paso para dejar de tratar la memoria como magia.
Bibliografía
- Zhang y Sun, Agent Memory as Recommendation (2026), preprint original.
- Versión HTML del paper, métodos y tablas.
- LongMemEval, evaluación de memoria a largo plazo.
- LoCoMo, benchmark de memoria conversacional.
- LightGBM, implementación de ranking utilizada.
- Mem0, Graphiti y Letta, comparadores de arquitectura.
- ArceApps: Mem0/Letta, memoria persistente y memoria jerárquica.
Cierre. Un agente no necesita recordar absolutamente todo. Necesita recuperar, cuando corresponda, todas las piezas que hacen falta para no equivocarse.
También te puede interesar
Agents of Chaos: Lo que 38 Investigadores Descubrieron sobre Seguridad Agentica
Análisis del paper 'Agents of Chaos' (arXiv:2602.20021): 7 vulnerabilidades críticas encontradas en dos semanas de red-team sobre agentes IA autónomos con memoria persistente, email y shell.
La Arquitectura de la Memoria Persistente para Agentes de IA
Un análisis técnico profundo de cómo los agentes de IA persisten, consolidan y recuperan información de forma autónoma. Desde OpenClaw y QMD hasta Mem0, Cognee y modelos de memoria neurobiológicos.
Graphicle: grafo de código y memoria para agentes IA
Descubre cómo Graphicle conecta código, documentación y memoria para agentes IA; analizamos su arquitectura, privacidad, benchmarks y alternativas.