
OpenTelemetry GenAI: observar agentes sin adivinar
Índice de contenidos
Un agente que responde «hecho» puede haber fallado cuatro veces
Hay una diferencia entre obtener la respuesta final de un agente y saber cómo ha llegado hasta ella. Una respuesta puede parecer convincente cuando, por debajo, el sistema ha llamado cinco veces a la misma herramienta, ha recuperado recuerdos incompatibles, ha agotado una cuota, ha reintentado una petición a un proveedor y ha terminado usando una ruta de emergencia. Sin instrumentación, todo eso es invisible. Solo queda una impresión: «a veces tarda» o «a veces se equivoca».
Cuando trabajo con herramientas de desarrollo basadas en agentes, me interesa menos un panel bonito que una pregunta concreta: ¿qué operación provocó el comportamiento que estoy viendo? Si el agente no completó una tarea, quiero localizar el paso exacto. Si el coste subió, quiero diferenciar una ventana de contexto más larga de tres reintentos ocultos. Si una memoria antigua desvió una decisión, necesito identificar la consulta que la recuperó. Un log de texto con «thinking…» y «done» no ofrece esas respuestas.
La observabilidad de sistemas tradicionales nació con problemas parecidos: servicios distribuidos, saltos por red, colas, dependencias opacas y fallos que rara vez se reproducían en la misma máquina. OpenTelemetry proporciona un lenguaje común para relacionar trazas, métricas y registros. Las convenciones semánticas para IA generativa intentan aplicar ese lenguaje a las operaciones de inferencia, las herramientas, los agentes, los flujos y la memoria. Importa la intención de interoperabilidad, pero también la advertencia: en octubre de 2026 muchas de esas convenciones se etiquetan como Development. No son una API congelada para siempre.
Este texto complementa lo que ya traté en Codex Agent Router y en los artículos sobre orquestación y harness engineering. Allí la cuestión era qué hace un agente y cómo encadenar tareas; aquí es cómo demostrar qué hizo, con evidencia suficiente para corregir su entorno.
Qué estamos midiendo realmente
Un agente no es simplemente una llamada al modelo. Puede incluir planificación, recuperación documental, búsquedas de memoria, selección de herramientas, ejecución de comandos, decisiones de continuación y verificaciones. Llamamos «ejecución» a un conjunto de operaciones con relaciones causales, no a una única respuesta.
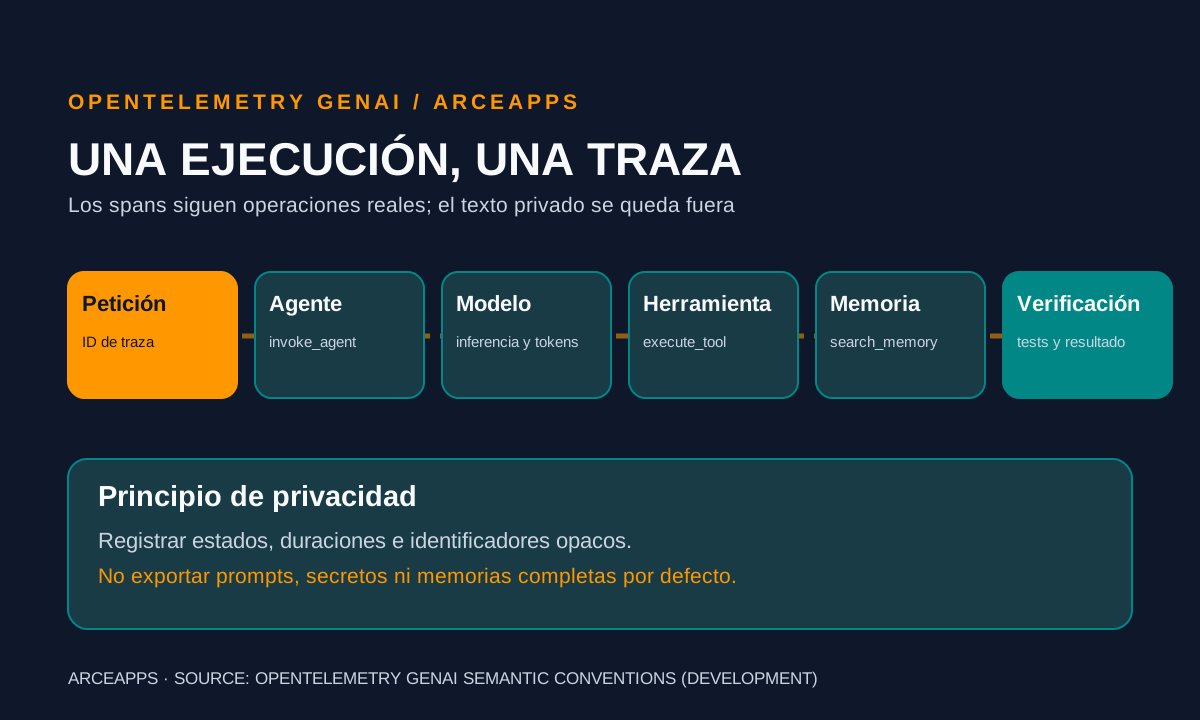
Una traza representa ese recorrido completo. Un span representa una operación delimitada en el tiempo dentro de la traza: por ejemplo, invocar el agente, preguntar al modelo, ejecutar una herramienta o consultar el almacén de memoria. Los spans tienen un identificador, contexto de propagación, inicio, fin, estado y atributos. Cuando se conectan con relaciones padre-hijo ofrecen una estructura navegable del proceso, no una lista desordenada de mensajes.
Las métricas condensan tendencias: duración, consumo de tokens comunicado por el proveedor, frecuencia de errores o distribución de latencia. Los logs conservan acontecimientos y diagnósticos puntuales. No son sustitutos de las trazas. La métrica «latencia p95 = siete segundos» avisa del problema; la traza de una petición concreta ayuda a explicar por qué. Un log puede registrar una excepción, pero sin su contexto de traza resulta más difícil saber qué operación la causó.
En IA generativa aparece una dificultad adicional: el coste de dos operaciones aparentemente iguales puede diferir por el tamaño del prompt, las respuestas reutilizadas, el proveedor, la política de caché o los tokens de razonamiento que el sistema reporte. Por eso conviene separar estrictamente atributos observados, cálculos derivados y estimaciones. Un precio calculado a partir de una tabla comercial es una estimación temporal, no una propiedad eterna de la petición.
La jerarquía: aplicación, workflow, agente, modelo y herramienta
Para instrumentar bien conviene elegir primero las fronteras. Una petición HTTP del usuario puede iniciar una ejecución de un workflow; este invoca un agente; el agente consulta memoria, llama al modelo, ejecuta una herramienta y vuelve a llamar al modelo para interpretar el resultado. Ese árbol ayuda a preguntar qué componente consume tiempo.
Las convenciones de OpenTelemetry describen operaciones de agente como invoke_agent e invoke_workflow, junto a valores como execute_tool y search_memory. No significa que cada biblioteca ya los emita de modo idéntico, ni que todas las versiones de instrumentación incluyan automáticamente todos los pasos. Hay que revisar qué genera realmente el SDK que utilices y qué partes requieren instrumentación manual.
Una llamada a herramientas debe representar la ejecución de la herramienta, no únicamente que el modelo la recomendó. Si el modelo escribe «ejecuta tests», pero el proceso nunca llega a lanzarlos, registrar una ejecución exitosa sería una mentira operativa. A la inversa, si el modelo genera una llamada que es rechazada por una política de seguridad, ese rechazo también es una observación relevante. El agente intentó una acción; el entorno la bloqueó; el resultado fue distinto al de una herramienta defectuosa.
Una segunda distinción evita un error habitual: un workflow estable no equivale a un agente deliberativo. Un encadenamiento fijo de «leer, resumir, guardar» puede merecer un span de workflow, sin fingir que hubo planificación autónoma. Elegir nombres semánticos sobrios facilita comparar ejecuciones y hace menos probable que un panel termine siendo un catálogo de etiquetas de marketing.
Un ejemplo mínimo en Python, sin depender de un proveedor de IA
Antes de activar un conjunto completo de instrumentadores automáticos prefiero comprobar que entiendo el árbol de spans. El siguiente ejemplo es ilustrativo y no se presenta como benchmark ejecutado en ArceApps. Utiliza la API estándar de OpenTelemetry para instrumentar tres operaciones. Los nombres de span son locales; los atributos normalizados y su estabilidad se verifican siempre en las convenciones oficiales de la versión instalada.
from opentelemetry import trace
from opentelemetry.trace import Status, StatusCode

tracer = trace.get_tracer("arceapps.agent.example")

def retrieve_context(query: str):
    with tracer.start_as_current_span("search_memory") as span:
        span.set_attribute("gen_ai.operation.name", "search_memory")
        span.set_attribute("app.memory.results", 3)
        # Sustituir por la consulta real. No guardar aquí texto sensible.
        return ["decisión técnica A", "referencia B"]

def run_agent(question: str):
    with tracer.start_as_current_span("invoke_agent") as span:
        span.set_attribute("gen_ai.operation.name", "invoke_agent")
        try:
            context = retrieve_context(question)
            with tracer.start_as_current_span("execute_tool") as tool_span:
                tool_span.set_attribute("gen_ai.operation.name", "execute_tool")
                tool_span.set_attribute("app.tool.name", "local_validator")
                # Sustituir por un validador real, con resultado comprobado.
                validated = bool(context)
            return {"validated": validated}
        except Exception as exc:
            span.record_exception(exc)
            span.set_status(Status(StatusCode.ERROR))
            raise
El fragmento no instala un exportador, no crea una política de privacidad y tampoco mide tokens: ese trabajo es deliberadamente independiente. Para obtener trazas persistentes hace falta configurar el SDK, un procesador y un destino, habitualmente a través de un Collector que pueda filtrar o transformar datos. La enseñanza principal es estructural: la instrumentación debe envolver operaciones reales, no inventar un relato sobre lo que suponemos que sucedió.
Hay también un detalle práctico: el ejemplo utiliza un atributo propio, app.tool.name, para señalar un validador. Es útil para un laboratorio, pero una instrumentación estable debería consultar el nombre y los campos específicos previstos por las convenciones GenAI y documentar los atributos propios. El objetivo del estándar no es impedir la experimentación; es facilitar que distintas herramientas entiendan el mismo dato.
Instrumentación automática: útil, pero nunca suficiente
Los SDK especializados pueden capturar llamadas a proveedores de modelos con muy poco código. El proyecto de instrumentaciones GenAI para Python de OpenTelemetry y bibliotecas complementarias trabajan sobre el SDK habitual e integraciones de clientes. Es tentador activar todo y declarar «observabilidad completada». Ese atajo produce gráficos rápido, pero deja zonas oscuras.
Un instrumentador de un cliente HTTP de modelos ve la llamada al proveedor; no conoce necesariamente qué paso de tu lógica la motivó. Tampoco sabe si el resultado de una herramienta fue semánticamente correcto. Un exportador puede contar un HTTP 200 como éxito aunque el agente haya devuelto un programa que no compila. La observabilidad técnica y la validación de calidad resuelven preguntas diferentes.
Además, la compatibilidad no debe deducirse del nombre del framework. Hay integraciones que registran inferencia, otras que incluyen agentes y otras que proporcionan decoradores para spans manuales. Hay que comprobar versiones, cambios de convenciones, campos emitidos y destinos de exportación. Si un integrador escribe atributos que otro ha dejado de reconocer, el problema no es que «OpenTelemetry falle»: probablemente estamos mezclando convenciones de diferentes etapas.
Mi enfoque es combinar instrumentación automática para lo que conoce bien —transporte e inferencia— con pocos spans explícitos para decisiones de negocio técnico: validación local, selección de memoria, ejecución de tests y persistencia. No más etiquetas de las necesarias. Cada campo adicional tiene un coste de cardinalidad, almacenamiento y posible exposición de datos.
Tokens, latencia y coste: tres preguntas distintas
La latencia visible al usuario puede dividirse en espera de cola, tiempo de inferencia, red, ejecución de herramientas y postprocesado. Un dashboard que muestre solo duración total no indica cuál de ellas domina. Conviene conservar la relación temporal de spans y agrupar por proveedor, modelo y operación. Para rendimiento percibido, el tiempo hasta la primera respuesta o al primer token útil puede ser más informativo que la duración completa; solo hay que registrarlo si el cliente realmente ofrece un evento verificable.
Con tokens ocurre algo parecido. Algunos proveedores distinguen entrada, salida, caché y otras categorías; otros no publican el mismo detalle. Debemos registrar lo efectivamente reportado y dejar ausentes los campos no disponibles. Tratar una estimación como si fuera consumo medido contaminará cualquier cálculo futuro.
Para calcular coste monetario hace falta una versión de las tarifas, el contexto de caché y reglas de facturación correctas. Un tablero que multiplica todos los tokens por una tarifa fija puede dar una aproximación útil, pero debe presentarla como tal. En particular, el coste por tarea resuelta requiere definir qué significa «resuelta»: respuesta enviada, tests superados, aceptación humana o comprobación funcional. No son equivalentes.
En agentes de programación me gusta separar dos métricas: coste por intento y coste por tarea aceptada. Un harness que gasta poco pero falla repetidamente puede ser más caro que otro que consume más por intento y termina la tarea correctamente. La observabilidad sirve precisamente para conectar consumo y resultado, no para premiar automáticamente el número más pequeño.
Memoria: registrar la búsqueda no es registrar el recuerdo
La memoria persistente introduce un problema más sutil que los tokens. Un agente puede recuperar cinco registros y basar su decisión en uno antiguo. Conocer solo que «search_memory duró 120 ms» no revela esa dependencia. Conviene registrar identificadores estables de los objetos recuperados, versiones, fuentes y estado de validez, siempre que no expongan información sensible.
Lo que no recomiendo es almacenar por defecto el texto completo de cada recuerdo, el prompt íntegro o las transcripciones del usuario en una plataforma de observabilidad. Esos datos pueden contener información personal, secretos, credenciales o fragmentos de código privado. Si el fin es depurar la relevancia, un identificador, una puntuación y una ruta de origen pueden ser suficientes. Para investigaciones más profundas, usa un entorno de prueba con datos sintéticos o autorizados.
Un segundo problema es la reutilización accidental. Si dos agentes comparten un índice, las trazas deben preservar el ámbito de acceso que determinó la respuesta. Un resultado recuperado desde otro usuario no se vuelve legítimo porque exista una traza impecable. El control de acceso debe ejecutarse antes de devolver datos; la observabilidad solo puede demostrar o ayudar a diagnosticar qué pasó.
Esta distinción conecta con memoria persistente para agentes y memoria compartida entre agentes. Una memoria no es confiable por haber sido recordada; una traza no es segura por ser estructurada.
Privacidad por diseño: el riesgo de observar demasiado
Los rastros de IA son especialmente sensibles porque las entradas pueden mezclar instrucciones, conversaciones, documentos privados, rutas locales, identificadores de cuenta y respuestas de herramientas. En desarrollo solemos querer «verlo todo», pero esa decisión se vuelve peligrosa cuando el exportador transmite trazas a un tercero o las conserva durante meses.
Antes de activar exportación defino una política: qué campos se permiten, qué se anonimiza, quién puede consultar los datos, durante cuánto tiempo se guardan y cómo se eliminan. La opción más segura para la mayoría de escenarios es no capturar cuerpos completos salvo en un laboratorio controlado. Puedes registrar resultados agregados, tamaños, categorías y referencias opacas sin copiar todo el contexto del agente.
La protección no acaba con una expresión regular que busque claves API. Los secretos pueden presentarse con formatos inesperados, y los datos privados no siempre tienen un patrón reconocible. Prefiero una lista explícita de atributos permitidos antes de la exportación, limitación de longitud y revisión de campos de alta cardinalidad. El Collector es un lugar razonable para aplicar controles, pero ninguna transformación debe asumirse eficaz sin pruebas con datos de ejemplo.
También importa el acceso. Un sistema que no comparte código con el proveedor de modelos puede filtrar ese mismo código enviándolo en los atributos de una traza. Cambiar de canal no elimina el riesgo. Si la infraestructura de observabilidad es externa, hay que revisar su contrato y ubicación igual que los de cualquier otro procesador de datos.
Muestreo, cardinalidad y retención
Guardar cada operación puede ser sostenible en un proyecto personal de bajo tráfico, pero esa comodidad no escala indefinidamente. Un agente con bucles puede generar cientos de spans por ejecución. Si cada uno contiene IDs de documentos, rutas de archivos, contenidos variables y etiquetas dinámicas, la cardinalidad del sistema crece con rapidez.
El muestreo reduce volumen, pero introduce sesgos. Muestrear una fracción pequeña de trazas normales puede ser razonable; perder precisamente las ejecuciones fallidas sería desastroso para depuración. Algunas políticas permiten conservar errores y muestras representativas, siempre con las limitaciones del backend y la semántica del muestreo que se utilice. No presupongo que todos los colectores soporten las mismas funciones.
Diferenciar datos efímeros de investigación y tendencias agregadas permite conservar lo útil durante más tiempo. El histórico de latencia por modelo, por ejemplo, puede interesar sin guardar cada prompt. Una muestra breve de fallos recientes puede exigir acceso restringido y caducidad automática. Hay que poner estas reglas antes de que el almacenamiento esté lleno.
La regla práctica es sencilla: si un atributo no sirve para buscar, agrupar, correlacionar o explicar un incidente, probablemente no merece estar en cada span. La observabilidad útil es selectiva. Coleccionar todos los datos porque la biblioteca lo permite no es ingeniería.
Cómo reproducir una investigación de latencia
Imaginemos un agente local que recibe la orden de modificar una función y ejecutar las pruebas. La respuesta final tarda veinte segundos. Un log plano solo muestra el total. La traza permite distinguir seis segundos de búsqueda contextual, ocho de inferencia, cuatro ejecutando tests y dos de serialización o espera.
Ahora imaginemos que el agente repite los tests tres veces. Con spans hijos podemos identificar las tres ejecuciones, sus códigos de salida y si la última era realmente necesaria. El árbol muestra también si la segunda llamada de modelo empezó antes de que finalizara una herramienta; eso puede revelar un problema de coordinación, no de velocidad del proveedor.
Para analizarlo seriamente registraría una muestra de tareas con identificadores anónimos, versiones de modelo y harness, resultado de pruebas y presupuesto de tokens. Compararía ejecuciones equivalentes, evitando mezclar tareas triviales con cambios arquitectónicos. Repetiría muestras y calcularía distribuciones, no solo una media. Después inspeccionaría algunas trayectorias fallidas antes de proponer una optimización.
Este escenario es hipotético y describe un protocolo, no un experimento realizado. Es importante decirlo porque un diagrama muy convincente puede disfrazar datos inventados. Prefiero una metodología que cualquiera pueda adaptar a su stack antes que una gráfica decorativa con cifras imposibles de auditar.
Qué errores de interpretación evita una buena traza
Primer error: equiparar un HTTP 200 a tarea resuelta. El proveedor respondió, pero quizá la salida no cumplió el contrato. Segundo: afirmar que el modelo «alucinó» cuando recibió una herramienta con documentación incorrecta. Tercero: atribuir un incremento de latencia al modelo cuando el almacenamiento de memoria estuvo bloqueado. Cuarto: confundir una repetición deliberada con un bucle accidental.
La traza permite plantear hipótesis mejores, pero no determina causalidad por sí sola. Que dos operaciones aparezcan próximas no significa que una haya causado la otra. Los spans representan la visión del componente instrumentado. Si hay operaciones fuera de esa frontera, el mapa queda incompleto.
También hay fallos de instrumentación: spans sin cerrar tras una excepción, contexto perdido entre tareas asíncronas, relojes de máquinas mal sincronizados, nombres inconsistentes y duplicados emitidos por dos bibliotecas. Antes de concluir que el agente está roto, hay que comprobar que el instrumento de medida funciona.
La mejor prueba es inyectar un fallo conocido en un ejemplo controlado: un timeout, una respuesta inválida y una herramienta rechazada. Después verificar que la traza distingue esos tres resultados. Si no lo hace, el panel todavía no es una herramienta fiable para depuración.
Instrumentación en entornos locales e indie
En proyectos pequeños, empezar con un servidor de telemetría enorme y cinco dependencias operativas puede tener más coste que el problema original. Para una primera evaluación bastan el SDK, un exportador de desarrollo y alguna herramienta local para inspeccionar spans. Cuando exista una necesidad real de persistencia o correlación entre procesos, se puede incorporar un Collector y un backend.
Conviene revisar opciones como Jaeger, Grafana Tempo, OpenSearch o una plataforma de observabilidad especializada, atendiendo a los formatos reales, restricciones de almacenamiento y facilidad de despliegue. No todas ofrecen las mismas consultas ni la misma representación de atributos GenAI. Elegirlas por una captura de pantalla es mala idea.
Otra alternativa es usar herramientas de aplicación como Logfire, que integran instrumentación más cerca del código Python. Esa decisión no impide utilizar estándares, pero conviene comprobar qué datos recopila automáticamente. La pregunta de selección es: «¿puedo seguir una ejecución desde la petición hasta las herramientas, explicar su coste y garantizar que no he enviado datos privados?».
Para un desarrollador independiente la mejor arquitectura suele empezar pequeña. No necesito replicar la infraestructura de una plataforma mundial para descubrir que mi agente está haciendo la misma consulta cinco veces. Necesito datos suficientes, verificables y baratos de mantener.
CI, evaluación y detección de regresiones
La observabilidad no sustituye pruebas ni una especificación. Sin una noción de éxito, una traza solo documenta la ejecución de una conducta equivocada. Por eso conectaría la instrumentación con resultados comprobables: compilación, pruebas de regresión, validaciones de seguridad y verificación del comportamiento esperado.
Un test de instrumentación útil comprueba que una ejecución simulada emite el span padre, los hijos previstos y un estado de error cuando falla una herramienta. No debería depender de enviar telemetría real a un tercero ni de gastar tokens de un proveedor. Otra prueba verifica que el exportador no recibe valores sensibles. Una tercera congela nombres de atributos importantes o documenta una migración cuando cambian convenciones experimentales.
Las métricas operativas permiten detectar tendencias que un test no ve: aumento de reintentos, recuperación más lenta, consultas excesivas a memoria, tokens por tarea aceptada o caídas del porcentaje de éxito. Sin embargo, hay que protegerse contra alarmas inútiles. Una tarea más compleja consumirá más; cambiar la distribución de tareas puede alterar las métricas sin que exista una regresión.
Lo que quiero de un pipeline es una combinación equilibrada: CI para propiedades verificables y trazas para lo que ocurre en ejecuciones reales. Son dos fuentes de evidencia complementarias.
Las convenciones todavía evolucionan
Los documentos oficiales de OpenTelemetry GenAI indican estado Development para partes del catálogo. Esto obliga a diseñar con márgenes: revisar versiones, no depender de un atributo experimental como única fuente de verdad y anotar cambios de instrumentación junto a los cambios de aplicación.
En particular, hay que diferenciar la semántica del agente, de las llamadas al modelo y de las herramientas. Un paquete puede instrumentar el cliente del modelo sin abarcar toda la estructura del agente. No conviene enseñar códigos copiados de una versión antigua como si fueran universales; el ejemplo mínimo anterior es deliberadamente sencillo y las fuentes enlazadas al final apuntan a la documentación vigente.
La normalización será valiosa si reduce el trabajo de conectar herramientas diferentes. Pero ningún estándar resolverá, por sí solo, qué constituye una tarea bien hecha, qué recuerdos son confiables o quién puede acceder a datos privados. Esas decisiones permanecen en la arquitectura del producto.
Mi criterio editorial es el mismo que al evaluar harnesses o sistemas de memoria: primero entender qué contrato ofrece la herramienta; después probarlo sobre una tarea representativa; por último invertir en infraestructura adicional si aporta evidencia que antes no tenías.
Qué instrumentaría mañana y qué dejaría fuera
Para empezar registraría cinco operaciones: entrada a la ejecución, llamadas al modelo, herramientas, búsqueda de memoria y verificación final. A cada una le añadiría duración, estado y unos pocos identificadores opacos. Mediría tokens de la forma que el proveedor los reporte, sin interpolar los que no existan. Guardaría versión del harness y un identificador de la tarea, nunca el texto completo del usuario de forma predeterminada.
Dejaría fuera el razonamiento interno del modelo, volcados indiscriminados de prompts, secretos de entorno y contenido de documentos privados. También evitaría construir un score de «inteligencia del agente» sumando métricas heterogéneas. Un número compuesto sería seductor y probablemente engañoso.
Si las trazas detectan un problema concreto, ampliaría temporalmente la instrumentación bajo una política de datos controlada. Después corregiría la causa y reduciría otra vez el volumen. La observabilidad tiene que poder crecer y volver a encogerse; de lo contrario se convierte en una nueva dependencia que solo genera trabajo.
Esa disciplina permite pasar del «parece que funciona» a un diagnóstico verificable sin sacrificar la privacidad ni hipotecar el mantenimiento.
Lecciones para quien construye agentes
Hay cuatro ideas que me llevo de esta revisión. La primera es que observar un agente significa seguir operaciones reales, no reproducir su conversación. La segunda es que el resultado final y el éxito técnico no son la misma medida. La tercera es que los datos de inferencia y memoria pueden ser más sensibles que los logs clásicos. La cuarta es que un estándar en desarrollo requiere pruebas de compatibilidad y una estrategia de actualización.
La alternativa a OpenTelemetry no es necesariamente una mala solución. Un sistema pequeño puede empezar con trazas locales y métricas sencillas. Pero cuando aparecen varios proveedores, herramientas o procesos, la interoperabilidad y la correlación pasan a ser ventajas concretas. Elegir el momento oportuno es parte del oficio.
La promesa de los agentes no es que produzcan más actividad; es que terminen trabajo útil. Y para saber si lo hacen necesitamos poder observar sus decisiones operativas con el mismo rigor con el que inspeccionamos el código y las pruebas.
Referencias y lecturas relacionadas
- OpenTelemetry: convenciones para spans GenAI, documentación oficial, estado Development.
- OpenTelemetry: agentes y workflows GenAI, catálogo semántico y valores de operaciones.
- Instrumentaciones GenAI para Python, repositorio oficial.
- OpenTelemetry: documentación general de tracing, conceptos y terminología.
- OpenSearch: instrumentación de agentes, ejemplo complementario.
- En ArceApps: Codex Agent Router, harness engineering y memoria persistente.
Cierre. Si alguna vez has mirado la respuesta de un agente y te has preguntado dónde se perdió el tiempo o por qué tomó aquella decisión, necesitas una traza mejor, no un prompt más largo. La herramienta correcta será la que permita contestar esas preguntas sin recoger más información de la imprescindible.
También te puede interesar
Hipocampus: Memoria Jerárquica Sin Infraestructura para Agentes IA
Un análisis técnico de Hipocampus, un arnés de memoria drop-in para agentes IA que usa arquitectura 3-Tier Hot/Warm/Cold y un árbol de compactación de 5 niveles. Cómo ROOT.md permite la consciencia de memoria a coste constante y cómo se compara con hmem, Mem0 y Letta.
hmem: Memoria Jerárquica SQLite para Agentes de IA
Un análisis técnico de hmem (Humanlike Memory), un servidor MCP que modela la memoria humana en cinco niveles con lazy loading respaldados por SQLite + FTS5. Cómo el decaimiento Fibonacci, el envejecimiento logarítmico y un agente curador resuelven el problema de contexto entre sesiones y máquinas.
PlugMem: El Módulo de Memoria Agnóstico de Microsoft Research
Análisis técnico de PlugMem, el sistema de memoria plugin de Microsoft Research que transforma interacciones brutas de agentes LLM en conocimiento reutilizable. Cómo su arquitectura de tres componentes (Estructura, Recuperación y Razonamiento) supera los diseños de memoria específicos por tarea.