
Spec Kit 1.0: del SDD a los workflows componibles
Índice de contenidos
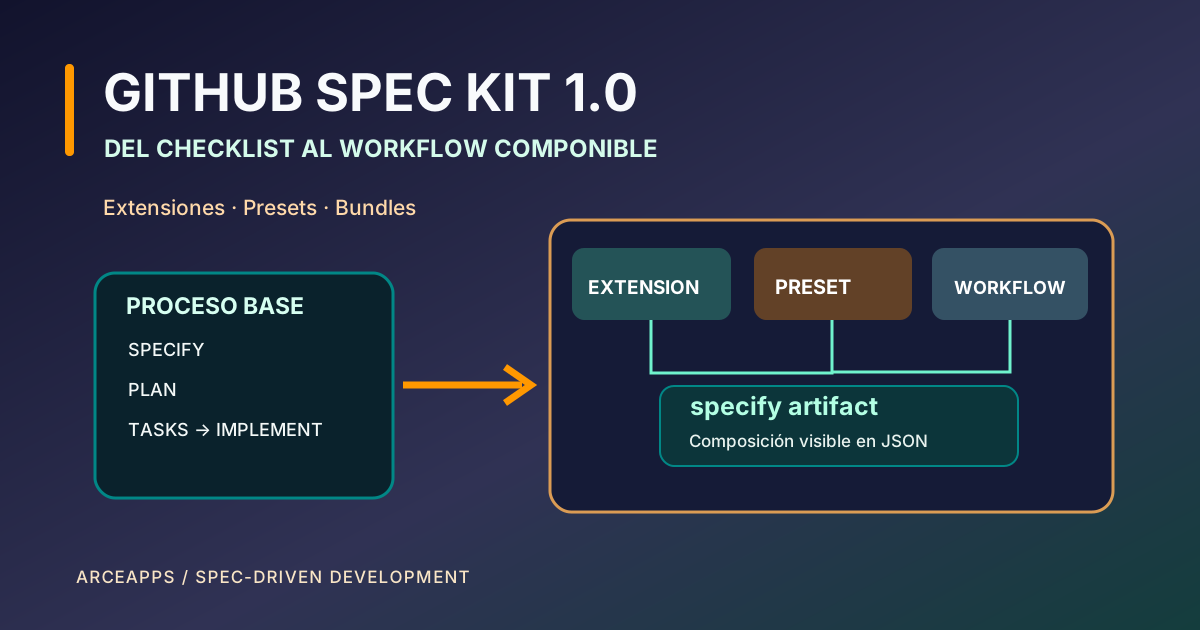
Antes de entrar en materia: el blog ya tiene una comparativa entre GitHub Spec Kit, OpenSpec y BMAD y la guía fundamental de Spec-Driven Development. Esta es una actualización de producto: qué cambió realmente con Spec Kit 1.0 y las releases de septiembre, por qué su arquitectura de composición interesa y cuándo resulta excesiva para un proyecto indie.
Cuando tu metodología empieza a parecer un framework
Al principio, el desarrollo guiado por especificaciones parece una idea casi obvia: antes de pedirle código a un agente, escribe qué necesitas, qué no debe cambiar y cómo sabrás que ha terminado. El problema aparece meses después, cuando cada nuevo proyecto exige copiar plantillas, adaptar prompts, instalar extensiones, sincronizar convenciones y explicar otra vez al siguiente agente cómo funciona la casa.
GitHub Spec Kit nació para estructurar esa relación entre intención y ejecución. Pero al llegar a v1.0.0 en agosto de 2026 dejó de ser interesante únicamente por sus comandos clásicos de constitución, especificación, planificación, tareas e implementación. Su apuesta empezó a parecer otra cosa: una plataforma para componer flujos que distintos agentes puedan interpretar sin acoplar cada decisión al prompt del día.
Las newsletters oficiales de agosto y septiembre documentan ese giro. En septiembre llegaron once releases, de v1.0.3 a v1.0.13, junto con cambios en dependencias de presets, pasos reutilizables, integración por etapa, introspección y endurecimiento de instalación. No se trata simplemente de que haya más plantillas disponibles: las piezas tienen reglas nuevas para convivir.
La pregunta para un desarrollador independiente no es «¿estoy usando todas las funciones de 1.0?». Es cuál de esas piezas reduce errores reales en mis repositorios y cuál introduce una segunda infraestructura que tendré que mantener. En este artículo vamos a inspeccionar ambas caras sin confundir cantidad de funcionalidades con calidad del software entregado.
1.0: un hito, no una promesa de inmovilidad
Las versiones mayores suelen asociarse a estabilidad. En una herramienta que cambia los flujos de los agentes, esa expectativa puede ser peligrosa. El propio equipo de Spec Kit explica en la newsletter de septiembre que su primer mes de la serie 1.0.x mantuvo un ritmo rápido: once parches entre el 1 y el 29 de septiembre. Además de corregir fallos, se reorganizó la CLI y evolucionaron mecanismos de composición.
Eso significa que adoptar Spec Kit 1.0 no es una garantía de que cada manifiesto, integración o extensión comunitaria mantenga exactamente el mismo contrato para siempre. Hay que observar versión concreta, cambios publicados y estado de cada componente. Una herramienta de desarrollo que se extiende a sí misma puede compensar ciertos cambios mediante agentes, pero la automatización de migraciones tampoco es infalible.
La cifra de versiones no demuestra por sí sola falta de calidad. Puede reflejar una comunidad activa y una apuesta por mejorar los contratos del runtime. Pero en proyectos que solo se revisan una vez al mes, un tren de releases frecuente aumenta la necesidad de fijar versiones verificadas y evitar instalaciones automáticas del último catálogo antes de realizar cambios importantes.
En un entorno SDD ligero, quizá baste con Markdown y GitHub Actions, tecnologías cuyos contratos ya conocemos. En un flujo reutilizado por muchos repositorios y herramientas distintas, disponer de una CLI más expresiva puede compensar esa superficie adicional. La decisión depende de la variación y del riesgo que realmente administramos, no del número de estrellas del repositorio.
Del proceso lineal a un conjunto de primitivas
Una forma útil de entender el cambio es separar dos preguntas. La primera es el orden del trabajo: especificar, planificar, descomponer, implementar y verificar. La segunda es quién puede intervenir en ese orden, qué instrucciones se añaden, qué componentes son reutilizables y cómo se descubre la composición final.
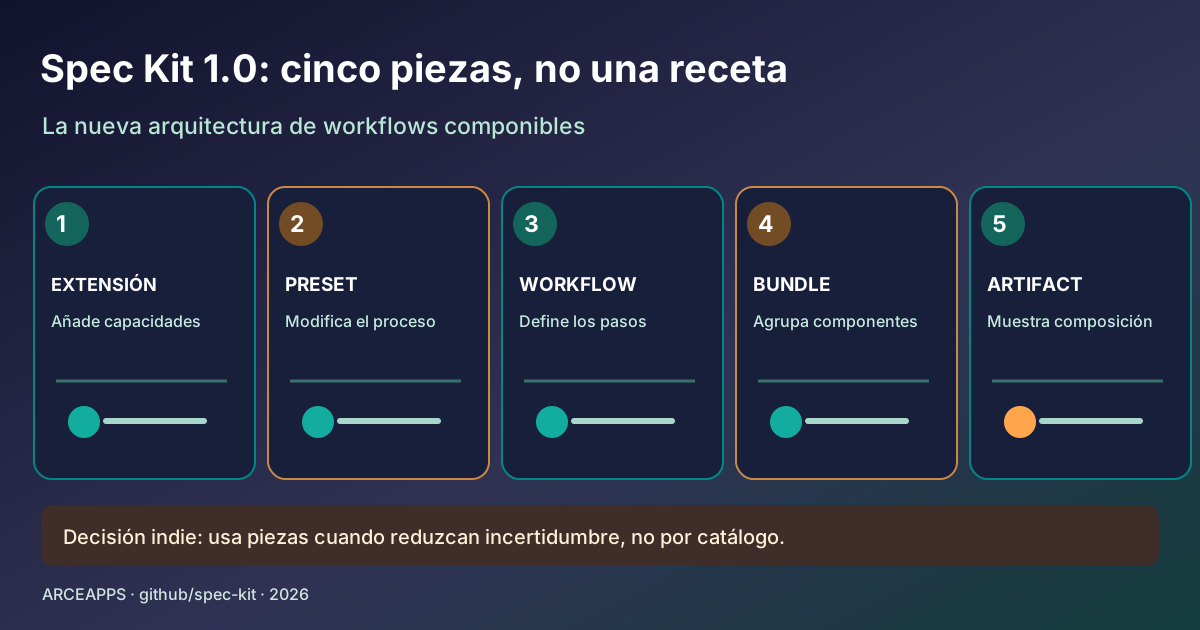
Spec Kit conserva un flujo base, pero el ecosistema 1.0 presenta cinco piezas relevantes: integraciones, extensiones, presets, workflows y pasos de workflow. Las integraciones conectan el sistema con el agente elegido; las extensiones agregan capacidades; los presets adaptan comportamiento y recursos; los workflows modelan secuencias ejecutables; y los pasos permiten granularidad dentro de esas secuencias.
Este vocabulario puede parecer exceso de arquitectura si solo queremos arreglar un botón. Su ventaja aparece cuando las mismas comprobaciones se repiten, cuando se utiliza más de un agente o cuando una familia de proyectos necesita un contrato estable. Por ejemplo, una extensión de revisión de accesibilidad puede aportar verificaciones; un preset del repositorio puede exigir esa extensión; un workflow de publicación puede colocarla antes del merge.
La alternativa artesanal sigue siendo válida: dos documentos Markdown, tests y Actions. La diferencia no es que el enfoque simple carezca de disciplina. Es que la plataforma intenta representar la disciplina como componentes inspeccionables y combinables. Esa promesa merece evaluarse por reducción de errores, no por elegancia del manifiesto.
Extensiones: cuando la capacidad pertenece al flujo
En el modelo clásico, una instrucción global le dice al agente «comprueba seguridad» o «revisa SEO» y esperamos que se acuerde. Una extensión puede empaquetar comportamiento, plantillas y comprobaciones especializadas que el proceso invoca en momentos concretos. Así se evita esconder una regla importante entre cientos de líneas de instrucciones genéricas.
La newsletter de septiembre informa de 176 entradas comunitarias de extensiones al cierre del mes, catorce más que al principio. Entre las incorporaciones se mencionan revisión de amenazas, validación con Playwright y ayudas para contratos, producto o gobernanza. Eso representa variedad de propuestas, no 176 garantías verificadas.
Una extensión útil debe tener entradas claras, resultados observables y una condición de fallo que no dependa de la autoestima del modelo. Si declara «comprobación de accesibilidad completada» pero no ejecuta ninguna prueba ni ofrece evidencia para una revisión manual, hemos trasladado el problema del prompt a un paquete con nombre.
Para un proyecto pequeño, instalaría solo extensiones que cubran carencias repetidas. Si GitHub Actions ya valida frontmatter y build, no me interesa otra extensión que reconstruya esos mismos checks sin aportar cobertura. Sí podría interesarme una que automatice un riesgo que estamos olvidando, siempre que su código y sus dependencias sean auditables.
Hay que recordar además que un catálogo comunitario es un mecanismo de descubrimiento. El propio proyecto documenta límites de su revisión de seguridad. La presencia de una extensión en una lista no elimina la responsabilidad de verificar su origen y permisos.
Presets: modificar reglas sin reinventar el runtime
Un preset puede seleccionar, ajustar y combinar recursos para un contexto específico. En vez de duplicar el núcleo del proceso para proyectos Android, web y herramientas CLI, podemos declarar qué convenciones se aplican en cada uno. Es una forma de tratar el workflow como configuración reutilizable.
Septiembre añadió un cambio significativo: los presets pueden declarar dependencias mediante requires.extensions. Eso responde a un defecto frecuente de los sistemas extensibles: instalar una configuración que silenciosamente presupone capacidades ausentes. Declarar la dependencia permite que las herramientas sepan qué debe estar disponible, aunque seguirá siendo necesario revisar compatibilidad y procedencia.
Desde la perspectiva indie, me interesa un preset cuando varias tareas comparten condiciones de aceptación. Por ejemplo, una familia de aplicaciones Android podría exigir pruebas de comportamiento, revisión de permisos y un formato de descripción de PR. Si la configuración se repite en múltiples proyectos, encapsularla puede evitar errores de copia y simplificar actualizaciones coordinadas.
Pero un preset no necesita controlar todo. Un cambio pequeño puede usar el proceso por defecto y una sola convención local. El peligro es que cada proyecto termine con un preset específico, otro preset por lenguaje y un tercero para el agente, formando una jerarquía que nadie entiende. Si no sabemos enumerar las reglas efectivas de una tarea, la reutilización ha dejado de ayudarnos.
Workflows: introducir variación en puntos explícitos
Otra novedad importante de septiembre son los slots reutilizables en workflows. Su propósito es permitir puntos de inserción con nombre, en lugar de obligar a reemplazar todo el flujo para añadir una comprobación. También se incorporó configuración de integración por paso: una etapa puede utilizar ajustes propios en vez de heredar una única configuración global.
Imaginemos una publicación técnica bilingüe. El flujo base podría investigar, redactar, auditar SEO, compilar y publicar. El proyecto necesita además una revisión de traducción y comprobar que las infografías existen en ambos idiomas. Con un slot apropiado, esas comprobaciones pueden insertarse donde aportan valor sin copiar y mantener otra definición entera del workflow.
Eso suena más abstracto que una lista numerada en un archivo de tareas, y a menudo lo es. Para justificarlo, necesitamos un patrón repetido y un punto donde la composición evite divergencias reales. La primera vez que escribimos un artículo, una checklist puede ser suficiente. Después de cien artículos, un mecanismo para declarar garantías comunes puede ahorrar mantenimiento y evitar olvidos.
El verdadero beneficio no está en ejecutar más pasos, sino en hacer visibles las dependencias y las condiciones de cierre. Un workflow que termina con «todo correcto» sin comprobar links, build ni diff no se vuelve más fiable por tener siete niveles de configuración.
Pasos de workflow: granularidad que también tiene precio
Los pasos hacen posible expresar fases pequeñas dentro de una operación grande. Una etapa puede necesitar un agente con capacidad de búsqueda; otra puede limitarse a ejecutar pruebas; otra puede requerir revisión humana porque afecta a datos sensibles. La configuración por paso permite asignar herramientas y contextos donde corresponden.
Esa granularidad tiene una virtud de seguridad. No necesitamos dar permiso de escritura a la fase que solo recopila documentación, ni acceso a secretos a un agente que genera una infografía. Separar capacidades ayuda a cumplir mínimo privilegio. También puede mejorar reproducibilidad cuando cada paso deja artefactos inspectables.
El coste está en la coordinación. Más pasos implican más estados, posibilidades de fallo y documentación que mantener. Si la herramienta oculta los cambios de contexto o crea una cadena de agentes que ninguno puede explicar, la separación deja de ser seguridad para convertirse en opacidad.
Para decidir el nivel adecuado hago una pregunta sencilla: ¿qué fallo detecta separar esta etapa que no podríamos detectar con una comprobación más barata? Si no hay respuesta, quizá una checklist y un test sean mejores. Si la respuesta es «impedir que una etapa de investigación publique credenciales», la separación puede justificar ampliamente su coste.
Bundles: compartir un conjunto con intención
Los bundles empaquetan varias piezas de una solución. La newsletter de septiembre menciona tres bundles comunitarios, entre ellos una combinación de elementos de arquitectura multi-vendor. No necesitamos un paquete de componentes para cada nueva feature, pero sí puede ser razonable compartir un método probado entre repositorios similares.
Aquí aparece una relación con las dependencias de presets. Un bundle puede describir qué se necesita instalar; un preset puede declarar lo que asume; y el workflow puede ensamblar los pasos apropiados. La intención es evitar que el proyecto dependa de instrucciones implícitas que solo conoce su autor.
El peligro de esta comodidad es incorporar capacidades que nunca habríamos elegido individualmente. Una colección de extensiones puede añadir privilegios, prompts persistentes o tareas que consumen tokens. Antes de instalar un bundle revisaría el inventario exacto y decidiría cuáles de sus componentes se necesitan de verdad.
En un repositorio privado con espejo público, también comprobaría qué archivos generan los bundles y cuáles quedan versionados. No basta con excluir una carpeta llamada docs si una extensión decide guardar tokens o resultados privados dentro de un directorio publicado. La frontera privado-público debe protegerse con listas de inclusión o reglas de exclusión comprobadas.
specify artifact: cuando el sistema explica cómo está compuesto
Entre los cambios de septiembre, specify artifact es posiblemente el más interesante técnicamente. Según el equipo, expone en JSON las capas de composición de un proyecto, las contribuciones de hooks y su procedencia. La pregunta que intenta responder es «¿qué está aportando cada pieza y quién es responsable de ello?».
Esto ataca una debilidad habitual en herramientas configurables. Instalamos tres extensiones y dos presets, alguien modifica un hook y finalmente una tarea empieza a comportarse de otra manera. Sin introspección, el diagnóstico depende de leer archivos dispersos y adivinar órdenes de precedencia. Una representación legible por máquina puede ayudar al agente y al desarrollador a reconstruir esa configuración.
El potencial va más allá de una salida bonita. En teoría podríamos comparar la composición antes y después de actualizar, detectar si falta una dependencia o registrar el estado que produjo una PR. Son posibilidades de uso que deben implementarse y probarse; no afirmo que el comando resuelva automáticamente todas esas verificaciones.
En una evaluación práctica conservaría el JSON de composición junto con la versión exacta de la herramienta y comprobaría si resulta entendible para un humano. Si solo sirve para que otro agente interprete un objeto gigantesco, seguimos teniendo un problema de observabilidad. Una configuración reproducible debe ser auditable sin depender de la memoria de una sesión.
Integraciones: soportar un agente no es garantizar equivalencia
Spec Kit también amplió el catálogo de integraciones, llegando a 42 al cierre de septiembre, según su newsletter. Entre las cuatro incorporaciones figuran Docker Agent, DeepSeek Harness, Muse Code y MiniMax Code. Esta novedad enlaza directamente con los artículos recientes de ArceApps: un mismo conjunto de intenciones puede presentarse a entornos de agentes muy distintos.
Pero conviene distinguir integración de equivalencia funcional. Dos agentes pueden recibir la misma especificación y diferir en herramientas, manejo de permisos, capacidad de ejecutar shell, formato de comandos o límites de contexto. Que exista una entrada en el catálogo no prueba que todas las extensiones produzcan resultados idénticos en cualquier runtime.
La ventaja real de la portabilidad es reducir el coste de cambiar de proveedor. Si la intención vive en archivos versionados, podemos probar la misma feature con agentes diferentes y comparar resultados. Sin embargo, necesitamos estabilizar variables: versiones, instrucciones, herramientas permitidas y criterios de aceptación. De lo contrario estaremos comparando configuraciones diferentes, no agentes.
Me gusta que Spec Kit amplíe integraciones, pero utilizaría la capacidad multimodelo solo cuando haya valor concreto. Para un proyecto pequeño con un único agente conocido, multiplicar proveedores puede traer más configuración y más caminos de error de los que elimina.
Seguridad de catálogos: lecciones del supply chain
Septiembre también fue un mes de endurecimiento técnico. La documentación oficial menciona URLs de catálogo fijadas a tags, comprobación de metadatos de assets, verificación de componentes de bundles, reducción de ventanas TOCTOU y validación de checksums de archivos comunitarios. Son detalles poco vistosos, pero importantes cuando una herramienta descarga instrucciones o código externo que luego influye en el proceso de desarrollo.
Una extensión de agente puede leer archivos, proponer comandos o intervenir en el resultado que recibe otro agente. Por eso las cuestiones de procedencia y fijación de versión deben tratarse con la misma seriedad que dependencias de compilación, aunque el paquete parezca «solo prompts». Los ataques no requieren que una extensión ejecute directamente un binario: unas instrucciones maliciosas o engañosas pueden cambiar decisiones posteriores.
Las mejoras del instalador disminuyen riesgos concretos; no los eliminan por completo. Una suma de verificación confirma correspondencia con un artefacto, pero no demuestra que el artefacto sea benigno. Un tag firmado o fijado reduce drift, pero sigue importando quién publica el release y qué permisos obtendrá.
Para un uso responsable, documentaría fuente, versión, permisos y mantenimiento de cada paquete instalado. También aprovecharía las opciones de fijación exacta de catálogo anunciadas para extensiones y workflows. La auditabilidad de la cadena es una parte central del valor de una plataforma SDD, no un requisito accesorio.
El caso Azure Cosmos DB: una extensión con resultados matizados
La incorporación de la extensión oficial de Azure Cosmos DB, anunciada por Microsoft en septiembre en public preview, es interesante porque lleva la lógica de Spec Kit a un ámbito especializado: consejos sobre particionado, consumo de RUs e índices vinculados a fases de implementación. La newsletter del proyecto identifica hooks antes y después de implementar.
El equipo de Cosmos DB publicó una evaluación según la cual el uso de su extensión incrementó determinadas métricas de cumplimiento de mejores prácticas alrededor de diez puntos porcentuales. El contexto importa: la misma fuente reconoce resultados aproximadamente comparables a utilizar Spec Kit solo en algunas mediciones globales y la necesidad de revisión humana.
Es una observación más útil que la habitual promesa de que una extensión «garantiza código de producción». Sugiere que orientar al agente con conocimiento de dominio puede mejorar algunas decisiones, pero que las ganancias dependen del benchmark, de cómo se mida y del nivel base.
Para un indie dev que nunca utiliza Cosmos DB, esta extensión no aporta valor directo. Sirve como ejemplo arquitectónico: conocimiento especializado se inserta en el flujo en vez de recitarse en todos los prompts. Si mañana existiera una extensión equivalente para una necesidad real de Android, privacidad o SEO, merecería evaluarla con la misma disciplina.
Lo que Reddit está diciendo sobre el coste de la ceremonia
En r/SpecDrivenDevelopment hay una crítica recurrente: Spec Kit puede resultar excesivo para tareas pequeñas y consumir muchos tokens. Algunos usuarios cuentan que prefieren un SDD personalizado con documentos breves y quizá una sesión de grilling para aclarar requisitos. Otros destacan su capacidad para conservar contexto y coordinar cambios más largos.
Estas experiencias no son ensayos aleatorizados ni una medición universal del framework. Las tareas, modelos y configuraciones de cada usuario varían demasiado como para convertir un comentario en una cifra de productividad. Pero sí son una señal consistente de una tensión de diseño: la misma estructura que protege un proyecto complejo puede ralentizar una tarea trivial.
Me parece especialmente útil la pregunta de un comentarista: tomar ideas de los frameworks y crear un flujo ajustado a nuestro trabajo. No es una invitación a ignorar los requisitos. Es una invitación a conservar el contrato verificable sin adoptar ceremonias que no cambian el resultado.
El coste real incluye tokens, tiempo de revisión, archivos que nadie mantiene y regresiones evitadas. Si solo medimos cantidad de documentos o tareas completadas por el agente, la metodología parece más eficaz de lo que quizá sea. Un buen proceso debe superar al sencillo en escenarios concretos, no porque tenga un nombre reconocido.
Una estrategia gradual para un repositorio existente
Para introducir Spec Kit en un proyecto activo no empezaría documentando todo el universo existente. Primero revisaría cómo funcionan sus GitHub Actions, qué reglas arquitectónicas están escritas y qué fallos han ocurrido recientemente. Después elegiría una feature suficientemente representativa para que una especificación pueda prevenir errores reales, pero no tan crítica como para experimentar con infraestructura nueva sobre producción.
La primera iteración puede quedarse en el proceso clásico: intención, planificación, tareas e implementación bajo revisión humana. Sin presets ni extensiones comunitarias. Esto establece una línea de base. La segunda intenta automatizar una sola comprobación repetitiva que el proceso anterior obligaba a recordar. Evaluamos si mejora calidad o reduce tiempo y revertimos la complejidad si no lo hace.
Solo entonces tendría sentido crear un preset reusable o un workflow con slots. Si en tres repositorios acabamos replicando el mismo gate, un componente común puede compensar el mantenimiento. Si la personalización existe en un único proyecto, quizá una regla local versionada sea más transparente.
El objetivo del experimento debe expresarse antes de empezar: menor trabajo manual de revisión, menos regresiones, mejor reproducibilidad o cambios de agente más sencillos. No aceptaría como objetivo «utilizar más partes de Spec Kit», porque eso transforma la herramienta en el producto.
Dónde prefiero SDD ligero con dos archivos
En ArceApps, un SDD ligero suele consistir en un plan con objetivo y decisiones, un archivo de tareas verificables, implementación focalizada, CI y revisión del diff. Para muchos cambios de aplicación o artículo, esta receta resulta suficiente. Es fácil entenderla meses después y apenas exige aprender sintaxis nueva.
Su mayor virtud es la transparencia: los criterios de terminado están donde esperamos y las verificaciones automáticas viven en GitHub Actions. Un agente nuevo no necesita reconstruir un motor de workflows para leer la próxima tarea. Si falla algo, podemos abrir el diff, inspeccionar el test y entender qué queda por hacer.
La debilidad del enfoque aparece con repetición a escala. Si cada repositorio copia reglas parecidas y evoluciona de manera divergente, los archivos simples pueden empezar a generar deuda. Ahí las primitivas componibles de Spec Kit ofrecen una ruta razonable hacia la reutilización, especialmente si la introspección aclara qué versión y componentes se ejecutaron.
No considero uno superior al otro en abstracto. La solución mínima que resuelve el problema de hoy suele ser preferible. La solución componible gana cuando convierte una complejidad recurrente en una configuración mejor controlada y verificable.
Una prueba comparativa que sí podríamos repetir
Para medir si Spec Kit 1.0 mejora un flujo indie prepararía dos ramas desde el mismo commit y una tarea con criterios de aceptación independientes del agente. En la rama A utilizaría SDD ligero, plan y tasks. En la rama B usaría el proceso Spec Kit con una composición documentada. Mantendría constantes modelo, presupuesto, permisos y tiempo máximo, y repetiría escenarios para reducir variabilidad.
No mediría solo si el agente terminó. Registraría tests aceptados, cambios fuera de alcance, minutos de revisión humana, tokens procesados, intentos fallidos y si el resultado siguió siendo comprensible tras una nueva sesión. También compararía el coste de actualizar la metodología, porque una herramienta que ahorra diez minutos por feature y consume una tarde cada mes puede no compensar.
Los resultados se interpretarían con cautela: tareas pequeñas y grandes pueden beneficiarse de estructuras distintas. Es plausible que el proceso completo proteja features complejas y ralentice ajustes triviales. Precisamente por eso las pruebas deberían cubrir ambos extremos.
No estoy afirmando que haya ejecutado aquí ese benchmark. Propongo un protocolo reproducible que permitiría abandonar el debate de las preferencias personales y elegir con evidencia, incluso si nuestra herramienta favorita resultara menos práctica en determinadas tareas.
Preguntas frecuentes
¿Spec Kit 1.0 sustituye OpenSpec o BMAD?
Son herramientas que compiten parcialmente por resolver problemas semejantes, pero difieren en su nivel de composición, filosofía y costes. Spec Kit 1.0 añade primitivas y un ecosistema creciente; OpenSpec mantiene una propuesta de cambios bastante ligera; BMAD organiza otros roles y etapas. Antes de migrar, conviene comparar los flujos reales, no las tablas de funcionalidades.
¿Qué aporta specify artifact?
Una superficie para inspeccionar en JSON la composición del proyecto y las contribuciones de distintas piezas. Es útil como punto de observabilidad y puede apoyar herramientas de validación. No convierte automáticamente en seguras o correctas todas las extensiones instaladas.
¿Puedo usarlo con DeepSeek Harness?
La newsletter de septiembre informa de su incorporación al catálogo de integraciones. Es importante comprobar la versión de Spec Kit, los requisitos de la integración y las capacidades reales del agente, especialmente permisos y formato de llamadas.
¿Necesito escribir especificaciones enormes?
No. La documentación del framework ofrece estructura, pero el tamaño del contrato debe responder al riesgo y a la incertidumbre. Una tarea pequeña puede necesitar solo una intención clara, una prueba útil y revisión del diff. El precio de las ceremonias debería justificarse.
Conclusión: la plataforma es útil cuando hace visible el contrato
Spec Kit 1.0 representa una evolución interesante: de un conjunto conocido de comandos SDD hacia una plataforma más configurable donde extensiones, presets, bundles y workflows pueden combinarse y explicar su propia composición. Los cambios de agosto y septiembre muestran tanto ambición técnica como trabajo real de endurecimiento de la cadena de componentes.
Pero esa arquitectura no convierte toda tarea pequeña en candidata a una instalación completa. Los comentarios críticos de Reddit tienen fundamento práctico: crear archivos y consumir tokens no es un resultado de producto. Una metodología útil tiene que mejorar las decisiones, la revisión o la recuperación cuando algo falla.
Para un desarrollador independiente mi consejo es empezar por el contrato más pequeño que evite errores, apoyarse en tests y CI existentes y adoptar primitivas nuevas solo cuando su valor sea observable. No tenemos que elegir entre ingeniería rigurosa y herramientas simples. Podemos exigir ambas.
Bibliografía
- GitHub Spec Kit: repositorio oficial — código, releases e integraciones.
- Newsletter oficial de agosto de 2026 — lanzamiento 1.0 y hoja de ruta.
- Newsletter oficial de septiembre de 2026 — 1.0.3–1.0.13, composición, catálogo, seguridad y CLI.
- Documentación oficial de Spec Kit — flujos básicos y conceptos.
- Azure Cosmos DB y Spec-Driven Development — evaluación de extensión, preview y límites.
- Reddit: percepción de sobrecarga de Spec Kit — experiencias, no benchmark.
- Reddit: dos meses usando Spec Kit — puntos fuertes y costes relatados.
- ArceApps: comparativa previa de frameworks SDD y fundamentos de SDD — antecedentes.
Análisis de fuentes públicas a 10 de octubre de 2026; la fecha editorial del artículo es el 7 de octubre. No se atribuyen pruebas de instalación o benchmarks que no se han ejecutado.
También te puede interesar

DeepSeek Harness Desktop: análisis de su app
Descubre DeepSeek Harness Desktop: instalación, plugins, automatización, seguridad y límites reales de su nueva aplicación para agentes de IA.
SDD + TDD: del requisito a la prueba verificable
Aprende a combinar SDD y TDD con agentes de IA: especificaciones ligeras, criterios de aceptación, pruebas Red-Green-Refactor y revisión con CI.
DeepSeek Harness: el runtime donde todo es un plugin
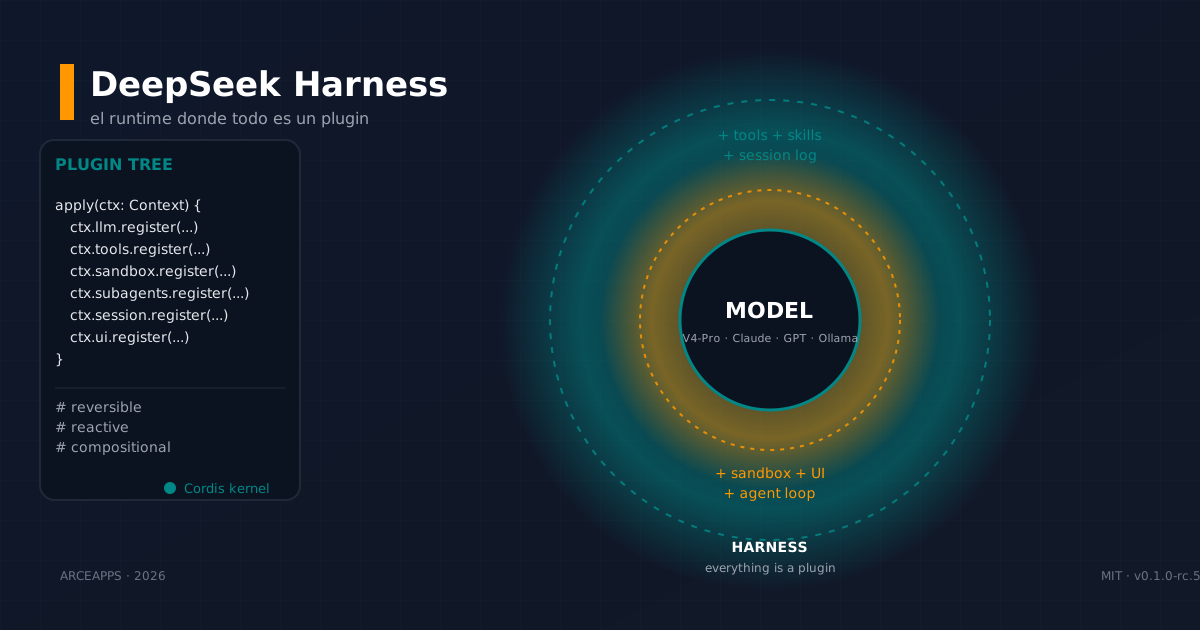
DeepSeek Harness (dsh) es un runtime open-source MIT donde modelo, herramientas, sesión, sandbox e incluso el loop son plugins. Análisis en profundidad: Cordis, modos, sesión append-only y self-evolution.