
Una plataforma de puzzles dirigida por agentes: caso real
Índice de contenidos
Todo artículo sobre plataformas de agentes te enseña una terminal. Escribes un prompt, el agente edita tres archivos y aparece un check verde. Es una buena demo y una pésima descripción del trabajo.
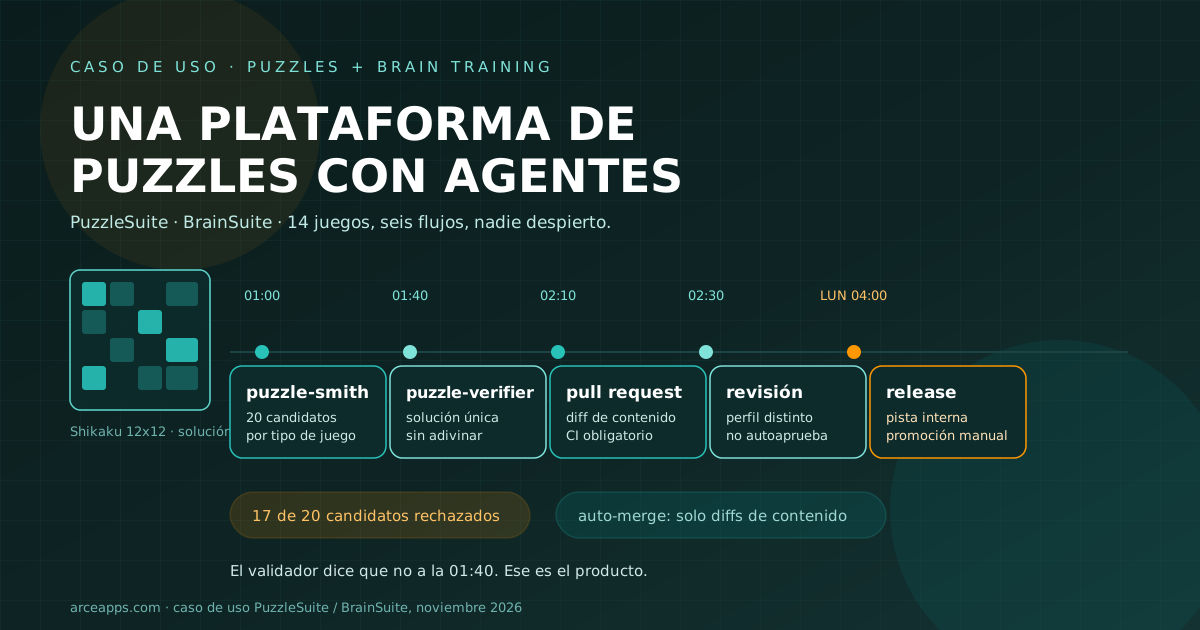
El trabajo es esto: son las 02:00, no hay nadie despierto y hay una cola de cosas que deberían haber pasado hoy y no han pasado. Catorce variantes de puzzle tienen que existir, cada una resoluble por lógica y no por prueba y error. Los tests que las cubren tienen que pasar. Un pull request necesita una segunda opinión que a esa hora no puede ser la mía. Una release tiene que llegar a una pista interna de Google Play sin que yo haga clic en una consola. Y por la mañana quiero un mensaje que diga qué ha pasado, no cuarenta que digan que no ha pasado nada.
Esa es la prueba real de una plataforma de agentes. No “¿sabe escribir código?”, sino “¿puede ser dueña de un proceso recurrente sin convertirse en un segundo trabajo?”.
Esta es la mitad práctica de una comparativa que publiqué aparte. Si quieres el desglose mecanismo a mecanismo —quién tiene webhooks, quién tiene presupuestos, quién despierta por cola— lee OpenBot vs Hermes vs Paperclip: ¿quién despierta al agente?. Aquí voy a construir la cosa.
El producto, y por qué es una prueba justa
PuzzleSuite es una app Android nativa en Kotlin y Jetpack Compose que publica catorce puzzles de lógica: Akari, Dominosa, Fillomino, Galaxias, Hashi, Hitori, Kakuro, Kenken, MathCrossword, Minesweeper, Queens, Shikaku, Slitherlink y Zip. MVVM con StateFlow, Hilt para inyección, Room y DataStore para estado local, Firebase Analytics/Crashlytics/Auth/Firestore, WorkManager para trabajo en segundo plano. minSdk 26, targetSdk 36, compileSdk 37, Gradle 9.4.1, JDK 21. Publicada en Google Play.
BrainSuite es la app hermana: ejercicios diarios de memoria, atención, velocidad de procesamiento y flexibilidad cognitiva, con rachas y estadísticas.
PuzzleHub es el lado web: landings, el blog que estás leyendo, documentación y el backend de contenido donde se generan los puzzles nuevos y sus metadatos.
El repositorio ya funciona con un flujo guiado por especificaciones: carpetas docs/specai/ con cinco documentos por funcionalidad, un AGENTS.md con contratos, archivos de prompt por agente en agents/bots/ para el bot de código, Conventional Commits, ramas main/develop/feature/*. Eso importa para este artículo: las plataformas de agentes fallan más donde falta proceso. Este proyecto ya tiene proceso. Lo que no tiene es turno de noche.
¿Por qué es una prueba justa de la proactividad? Porque casi todos los flujos tienen cuatro propiedades que rompen la automatización ingenua:
- La salida es verificable pero no obvia. Un puzzle o tiene solución única por lógica o es basura, y “parece bien” no es una comprobación.
- El trabajo es periódico y aburrido. Exactamente lo que un humano deja de hacer en la tercera semana.
- Toca dinero y credenciales. Play Console, claves de firma, claves de API, el listing de la tienda.
- Los errores son públicos. Un bug en un puzzle publicado es una reseña de una estrella con captura de pantalla.
Qué tiene que pasar sin mí
Seis flujos, en el orden en que los automatizaría. El orden no es arbitrario: va de lo más barato y seguro a lo más caro y arriesgado, y casi todo el mundo lo hace al revés.
| # | Flujo | Cadencia | Radio de daño si falla |
|---|---|---|---|
| 1 | Suite de tests nocturna + resumen | Diaria | Ninguno. Solo lee |
| 2 | Generación de puzzles + PR de validación | Nocturna | Alto si mergea contenido malo |
| 3 | Revisión de PRs de contenido | Por evento | Medio: merge malo |
| 4 | Tren de release a pista interna de Play | Semanal | Alto: build roto en público |
| 5 | Contenido de sesiones diarias de BrainSuite | Semanal | Medio: repetición, sets aburridos |
| 6 | Listing, ASO y borradores de blog | Semanal | Medio: afirmaciones que no puedes respaldar |
El flujo 1 es el que hay que construir primero, siempre. Es una ejecución de tests, cuesta casi nada y demuestra que el planificador está vivo. Si una plataforma no puede hacer el flujo 1 en silencio y bien durante una semana, no va a hacer el flujo 2.
El reparto
Siete agentes. Menos de lo que parece, y cada uno con un dueño único para un tipo de salida. En las tres plataformas el reparto es más o menos el mismo; lo que cambia es dónde vive cada agente y qué lo despierta.
| Agente | Trabajo | Salida | Nunca debe |
|---|---|---|---|
puzzle-smith | Generar la definición de un puzzle para un juego y tamaño | JSON + informe de solubilidad | Inventar una variante de reglas sin especificación |
puzzle-verifier | Demostrar unicidad y solubilidad lógica | Pasa/falla + métricas | Aprobar su propia generación |
qa-runner | Ejecutar tests unitarios, de Room y de Compose; triar fallos | Resumen + lista de flaky | Tocar app/src/main |
release-captain | Subir versión, changelog, AAB firmado, subida a pista interna | Release + notas | Promocionar a producción |
content-scribe | Sets de sesiones de BrainSuite, copy de tienda, borradores de blog | Texto + metadatos | Hacer afirmaciones de salud o rendimiento |
growth-analyst | Keywords ASO, experimentos de listing, rendimiento del blog | Propuesta, no acción | Publicar nada |
support-triage | Clasificar reseñas de Play y clusters de Crashlytics | Etiquetas + escalado | Responder a un usuario |
La regla que te salva: el agente que genera nunca es el agente que aprueba. Es barato de imponer en Paperclip (fase de revisión) y en Hermes (un perfil distinto para la revisión). En OpenBot es una convención de canal, y las convenciones se degradan, cosa que conviene saber antes de confiar en ellas.
Flujo 1 — 02:00, el resumen que no dice nada
El trabajo: ejecutar ./gradlew testDebugUnitTest, comparar fallos con ayer y reportar. Si todo pasó, decirlo en una línea.
Con Hermes. Un trabajo cron, fijado a un modelo barato, con --workdir apuntando al repo para que el AGENTS.md y el wrapper de Gradle estén en alcance:
hermes cron create "0 2 * * *" \
  "Ejecuta ./gradlew testDebugUnitTest. Lista solo los tests que fallaron
   y ayer pasaban, con la línea de stack que importa. Si no cambió nada,
   responde exactamente: sin cambios. No resumas los éxitos." \
  --workdir /home/me/Projects/PuzzleSuite \
  --name "tests-nocturnos" \
  --deliver telegram
Hay tres cosas aquí que importan más que el comando. El prompt prohíbe resumir los éxitos, porque un resumen que lista 1.214 tests que pasan es un resumen que nadie lee. El trabajo va fijado a un modelo barato, así que el trabajo aburrido no corre en el caro. Y si la clave del proveedor caduca, la validación previa marca el trabajo blocked_config y manda una alerta en vez de fallar cuarenta veces en una noche.
Con Paperclip. Una rutina con disparador de horario (0 2 * * *), asignada a qa-runner, que produce una tarea cada noche. La diferencia no es el horario; es que el resumen de anoche es una tarea que puedes buscar, comentar y atribuir en coste. Cuando el mismo test de Room inestable falla tres noches seguidas, la tercera tarea puede enlazar las dos anteriores y un humano puede decidir ponerlo en cuarentena. Las políticas de entrega por defecto de Paperclip —coalescer si hay una ejecución activa, saltar horarios perdidos— son justo lo que quieres para un trabajo nocturno; una cola de seis resúmenes viejos a las 09:00 es peor que uno.
Con OpenBot. Una rutina en el agente qa-runner: “Ejecuta ./gradlew testDebugUnitTest; lista los tests fallidos y nada más.” Salta a las 02:00 en el hilo propio del agente y la respuesta está en la app. En la app de escritorio esto solo funciona con la máquina encendida; en un servidor alojado, el servidor despierta poco antes de la rutina. Si tu Mac está dormido a las 02:00 todas las noches, has construido un flujo que nunca se ejecuta, y no lo vas a descubrir por un check verde.
Lo que hago de verdad: el flujo 1 con un script y cero LLM. Modo no_agent en Hermes, o una rutina que ejecuta un script de shell en OpenBot, o una rutina de Paperclip asignada a un agente cuyo único trabajo es pegar la salida del script. El modelo aporta valor en el tercer fallo, no en el primero: “este es el mismo IllegalStateException del martes, causado por una migración de Room no registrada en AppDatabase”. Ejecuta el script cada noche y llama al modelo solo cuando el script diga que algo va mal.
Flujo 2 — el puzzle nocturno que no puede ser basura con buena pinta
Este es el flujo que justifica todo el ejercicio, y donde un montaje ingenuo produce contenido que parece correcto y no lo es.
La definición de un puzzle es datos: tamaño de rejilla, reparto de regiones, pistas y solución. El trabajo del generador es producir una. El trabajo del verificador es demostrar dos propiedades:
- Unicidad. Existe exactamente una solución.
- Solubilidad lógica. Un solucionador al estilo humano —propagación de restricciones, sin backtracking, sin adivinar— llega a esa solución.
La propiedad 2 es la que la gente se salta, y es la que decide si un puzzle es divertido o exasperante. Un Shikaku de 12×12 con solución única que exige adivinar no es un puzzle; es lanzar una moneda con pasos extra.
Un contrato de validación que hace el trabajo, en el lenguaje en que lo escribiría:
# tools/puzzlecheck/validate.py  (exit code 0 = publicable)
def check(spec: PuzzleSpec) -> Report:
    solutions = solve_all(spec, limit=2)          # paro en 2, solo necesito saber
    if len(solutions) != 1:
        return Report.fail("soluciones", count=len(solutions))

    trace = logical_solver(spec)                   # solo propagación
    if trace.required_guess:
        return Report.fail("adivinar", at=trace.first_guess_cell)

    if not (spec.band.min_clues <= trace.clue_count <= spec.band.max_clues):
        return Report.fail("densidad", ratio=trace.density, band=spec.band)

    if trace.longest_chain < spec.band.min_chain:
        return Report.fail("trivial", chain=trace.longest_chain)   # demasiado fácil

    return Report.ok(metrics=trace.metrics)
Fíjate en lo que este validador no le pregunta al modelo. El modelo genera candidatos; Python decide. Todo lo que va después del generador es determinista, lo que significa que el flujo nocturno puede correr sin nadie y sin un modelo juez improvisando calidad.
Con Hermes: un trabajo cron a la 01:00 que crea una tarjeta Kanban por tipo de juego y banda de tamaño, y deja que el despachador las trabaje en paralelo. El cuerpo de la tarjeta lleva los criterios de aceptación y el comando a ejecutar. El verificador es un perfil distinto, así que kanban_request_review es un traspaso real y no el mismo agente aprobándose:
hermes kanban create "Shikaku 12x12 — 20 candidatos" \
  --assignee puzzle-smith \
  --body "Genera 20 candidatos. Ejecuta tools/puzzlecheck. Conserva solo
          los de solución única y sin adivinar. Abre un PR con los
          supervivientes y la tabla de métricas. No toques fuentes Kotlin." \
  --completion-contract OWNER/PuzzleSuite
El contrato de finalización es la parte que no cedería: la tarjeta no se cierra hasta que pasen los checks obligatorios del repositorio en el commit exacto del PR. No “el agente dice que los tests pasan”. Lo dice el repo.
Con Paperclip: una rutina crea la tarea, la asigna a puzzle-smith, y la política de ejecución encamina el cierre por puzzle-verifier (fase de revisión) y, si quieres, por una aprobación humana durante el primer mes. El presupuesto importa aquí: generar 20 candidatos × 14 tipos × 30 noches es una factura real de tokens, y una parada dura al 100% con coste por ejecución es cómo te enteras antes que la factura.
Con OpenBot: una rutina en puzzle-smith con traspaso a puzzle-verifier en un canal. La regla de un solo propietario hace legible la secuencia; los controles Stop/Reassign la hacen recuperable. Lo que no te da es una puerta de merge: los agentes pueden coincidir en que el puzzle está bien, y tu protección de rama sigue siendo lo único entre ese acuerdo y main.
Lo que construiría primero: el validador, antes que el agente. Si el validador es débil, un agente mejor solo produce basura mejor formateada, más rápido.
Flujo 3 — el pull request que se revisa solo
Los PRs de contenido son un caso especial: tocan assets/puzzles/*.json y un fixture de test, y nada más. Es una categoría para la que puedes automatizar la revisión, con una regla dura:
El auto-merge solo está permitido cuando el diff se limita a
assets/puzzles/yapp/src/test/resources/puzzles/, CI está verde, el informe del validador va adjunto y no ha cambiado ningún archivo bajoapp/src/main/.
Todo lo que toque el solucionador, el modelo de dominio o la interfaz va a un humano, siempre. La razón no es desconfiar del agente; es que un diff en puzzle-solver puede dejar cien puzzles mal de una forma que ningún test unitario detecta hasta que la encuentra un jugador.
Las tres implementaciones se diferencian en exactamente una cosa interesante: quién no puede cerrar el trabajo.
- Paperclip lo impone en el runtime. El agente no puede pasar la tarea a hecha sin el comentario obligatorio y, si lo configuraste, sin las fases de revisión y aprobación. El bucle de revisión escala a un humano tras tres rondas de dos agentes sin ponerse de acuerdo.
- Hermes lo impone en el tablero y en el repositorio: un contrato de finalización de PR lee las reglas de protección de rama y los checks del commit exacto, y rechaza completar sin ellos. La revisión es un cambio de perfil, y
kanban_request_changeses una transición de primera clase y no un comentario que se ignora. - OpenBot te da la conversación y los controles. La revisión es un traspaso con un mensaje que puedes leer; la puerta es GitHub, no la app.
En la práctica, las tres convergen en la misma arquitectura: el repo es la fuente de verdad y la plataforma de agentes es la cola delante de él. Las plataformas que lo hacen explícito te ahorran construirlo.
Flujo 4 — el tren de release
El trabajo semanal: subir la versión, generar el changelog desde Conventional Commits, compilar y firmar el AAB, subirlo a la pista interna y publicar las notas.
La parte difícil no es la build. Son las credenciales.
El acceso a Play Console es un JSON de cuenta de servicio con permiso de publicación, las claves de firma viven en un keystore, y ambos son el tipo de secreto que acaba en una captura de pantalla. Cada plataforma lo trata de forma distinta, y la diferencia es un criterio de selección real:
- OpenBot tiene un Vault: logins, tarjetas y datos de contacto guardados en el ordenador, cifrados por el sistema operativo, con integración de 1Password y Bitwarden. Los agentes pueden iniciar sesión y rellenar formularios, pero solo ven el nombre de la tarjeta y sus últimos cuatro dígitos, y el primer relleno en cada sitio requiere aprobación. Para un flujo que hace clic en una consola web, es la respuesta más humana de las tres.
- Hermes espera secretos en el entorno (
.env, configuración) y tiene un modelo de seguridad documentado alrededor de herramientas y aprobaciones. Subir vía la API de Play con una cuenta de servicio es el camino limpio; hacer clic en la consola necesita una herramienta de navegador y un login que tienes que darle tú. - Paperclip da a las rutinas sus propios secretos, acotados a la tarea de esa rutina, además de acceso a nivel de conector y una fase de aprobación antes de la acción que publica.
Mi recomendación, con independencia de la plataforma: no automatices la consola. Automatiza la API. fastlane supply o la API de Play contra la pista interna, con una cuenta de servicio que solo pueda publicar en esa pista. Así el trabajo del agente es un bump de versión, un changelog y un comando, y la credencial que necesita es aburridamente limitada.
Para el changelog, la salvaguarda es una regla con la que el agente no puede discutir: cada línea debe corresponder a un hash de commit del rango, y el resumen no puede describir nada que no esté en el diff. Esa sola regla mata el 90% de la niebla de “mejoras de rendimiento y estabilidad” que los agentes producen cuando les pides notas de release.
Flujo 5 — BrainSuite, donde la salvaguarda es el producto
BrainSuite necesita un set semanal de sesiones diarias: qué ejercicio, con qué parámetros, en qué orden, con qué curva de dificultad. Es exactamente el tipo de contenido que un agente hace bien y exactamente donde un agente puede hacer daño en silencio.
La arquitectura que usaría es una taxonomía propiedad del humano con huecos que rellena el agente. Un humano define el catálogo de ejercicios y las bandas de dificultad una vez, en un documento que el agente lee. El agente rellena los huecos semanales de ese catálogo y nunca inventa un ejercicio. Dos reglas duras:
- Ninguna afirmación clínica o de rendimiento. Nada de porcentajes, CI, mejora de memoria o “respaldado por la ciencia” salvo que un humano cite el paper. Aquí es donde el copy generado por agentes se convierte en un pasivo.
- Sin repetición dentro de la banda. El set de la semana 12 no puede reutilizar los parámetros exactos de la semana 11; el validador lo comprueba igual que comprueba puzzles.
Con Hermes, esto es un trabajo cron que carga una skill —brainsuite-session-planning— para que la taxonomía y las reglas viajen con el trabajo en vez de vivir en el prompt. Con Paperclip es una rutina asignada a content-scribe con fase de revisión, para que un humano apruebe las primeras cuatro semanas y luego muestree. Con OpenBot es una rutina más un archivo de instrucciones en el espacio del agente, que es limpio y funciona, y se desvía en el momento en que alguien edita el archivo en local sin avisar.
Flujo 6 — crecimiento, con los frenos puestos
ASO y borradores de blog: investigación de keywords, variantes de listing, esquemas de artículos, un post por semana para el sitio. El valor es real y el modo de fallo es sonrojante, porque un agente escribiendo copy de marketing se inventa números.
Tres restricciones que codificaría en el prompt y en el paso de revisión:
- Toda afirmación enlaza una fuente. El número de instalaciones de un competidor, un benchmark, el comportamiento de un framework: si no se puede enlazar, no se publica.
- El agente propone, el humano publica. Sin excepción. La acción de publicar vive detrás de una fase de aprobación (Paperclip), un paso separado (Hermes) o un traspaso de canal (OpenBot).
- Ningún artículo sobre una herramienta sin leer su documentación. La cantidad de comparativas confiadamente equivocadas que hay en internet es la prueba de que esta regla no es obvia para los modelos.
El incidente de las 04:12
Este es el flujo que decide si te quedas con el sistema.
A las 04:12, puzzle-smith termina 20 candidatos para un tamaño nuevo de Kakuro. El verificador rechaza 17: seis tienen dos soluciones, once necesitan adivinar. Los tres supervivientes producen un PR. CI corre. El test instrumentado de Compose falla en un emulador al que se le acabó la memoria —no por el puzzle, por la máquina.
Lo que pasa después es el producto:
- Hermes. La reclamación del worker queda obsoleta, el despachador la recupera, la tarea vuelve a
readyy se lanza un worker nuevo con el hilo de comentarios como contexto. El contrato de finalización bloquea la tarjeta: los checks obligatorios no pasaron. Un mensaje de Telegram me dice que una tarjeta está bloqueada, con la clasificación del fallo. Lo leo con café y arreglo el runner o desbloqueo con un comentario. No se perdió nada y nada se reintentó en bucle. - Paperclip. La ejecución es una fila con estado y auditoría. La tarea sigue asignada. Si el presupuesto mensual del agente está al 100%, el siguiente reintento no ocurre hasta que suba el tope, lo que a las 04:12 es bueno y a las 09:00 es molesto, en ese orden. Un heartbeat atascado tiene una ruta de depuración documentada en vez de convertirse en folclore.
- OpenBot. El canal muestra el traspaso fallido con el mensaje del verificador. Si la máquina se durmió, no pasó nada y el hilo está exactamente donde lo dejé. Puede que el modelo de respaldo haya movido a un agente a otro proveedor a mitad de ejecución y haya dejado una nota; esa nota es la diferencia entre confusión y explicación.
La lección es siempre la misma: la ruta de escalado es la función. No la automatización. La automatización es el mínimo; cualquiera puede ejecutar un comando a las 02:00.
Memoria que compone
Si el sistema no recuerda, vas a reexplicar las bandas de dificultad cada semana como un jefe que perdió la wiki.
Lo que cada agente necesita saber, en concreto:
- Las reglas de cada uno de los 14 juegos, en el repo (
docs/puzzles/), no en un prompt. - Las bandas de dificultad, con los rangos de densidad de pistas que validó el solucionador.
- La lista de modos de fallo ya encontrados: las doce formas en que un candidato de Fillomino ha estado mal antes.
- El tono del listing de la tienda, que no es el tono del blog.
- Qué rompieron las últimas cuatro releases.
Con Hermes, esto se convierte en una skill que el agente escribe y refina, y en un archivo de memoria que sobrevive entre sesiones:
---
name: puzzle-difficulty-calibration
description: Úsala al generar o validar candidatos de PuzzleSuite.
---

## Bandas (validadas 2026-11, no editar sin re-ejecutar el solucionador)
- Shikaku 10x10: pistas 9–14, cadena lógica más larga >= 7
- Kakuro 12x12: dados 30–38% de celdas, ninguna cadena >= 4 que fuerce a adivinar

## Rechazar a la vista
- Dos soluciones (contar con limit=2, nunca enumeración completa)
- `required_guess` verdadero en cualquier punto de la traza de propagación
- Densidad de pistas fuera de banda en más de un 15%

## Trampas conocidas del generador
- Fillomino: las semillas simétricas producen duplicados espejados; deduplicar por forma canónica.
- Hitori: la eliminación de celdas adyacentes hace puzzles triviales; comprobar la longitud de cadena.
Ese archivo vale más que cualquier mejora de prompt, y es lo que Paperclip estructuralmente no te da por agente: la unidad de memoria de Paperclip es la tarea y la biblioteca de skills de la empresa, que es la unidad correcta para un equipo y la incorrecta para un especialista que necesita recordar sus propias cicatrices.
OpenBot queda en medio: instrucciones y memorias guardadas por agente, con límites, y un importador que puede traer entradas de MEMORY.md y USER.md y skills personalizadas desde Hermes. Si vas a migrar, exporta primero: la importación es de un solo sentido.
Cuánto cuesta
Solo precios públicos de lista, sin presupuestos. El gasto de modelos se lo come todo, y depende de cuántas veces dejes pensar a un agente.
| Montaje | Software | Modelos | Infra | Mensual realista |
|---|---|---|---|---|
| Solo, portátil, Hermes autoalojado | 0 $ (MIT) | Tu plan actual de ChatGPT/Claude, o API | 0 $ | 20–60 $ |
| Solo, portátil, OpenBot | 0 $ personal / 10 € comercial Starter | Planes actuales (Codex, Claude Code, Gemini) | 0 $ | 20–40 $ |
| Solo, siempre encendido | 0 $ | Claves de API | Hermes Cloud desde 20 $, o un VPS de 5–10 € | 40–120 $ |
| Solo, OpenBot alojado | 10 € licencia + | Planes actuales | 20 €/25 $ Starter alojado | 45–90 $ |
| Equipo de 3–5, Paperclip + Hermes | 0 $ (MIT) | API, con presupuesto por agente | VPS de 10–20 €, o tu propio Postgres | 150–500 $ |
Dos notas honestas. Primera: la fila de equipo es un rango porque el presupuesto es el punto; el aviso al 80% de Paperclip existe precisamente porque una org de cinco agentes sin tope puede gastar el presupuesto mensual de un desarrollador solo en un fin de semana. Segunda: la configuración más barata no es la que tiene menos herramientas, es la que hace los trabajos aburridos sin modelo. Un script nocturno en modo no_agent cuesta cero y detecta la mayor parte de lo que de verdad te importa.
Orden de construcción, si empezara el lunes
Semana 0 — el validador. Escribe tools/puzzlecheck. Haz que falle con ruido. Añádelo a CI. Sin agentes. Es la semana de mayor apalancamiento, porque todos los flujos posteriores dependen de una definición comprobable por máquina de “puzzle bueno”.
Semana 1 — el resumen. Flujo 1, sin LLM. Demuestra que el planificador está vivo siete noches. Si una plataforma no puede hacer esto en silencio, párate y elige otra.
Semana 2 — generación con puerta. puzzle-smith + puzzle-verifier como agentes separados, un PR por lote, auto-merge solo para diffs de contenido. Déjalo correr dos semanas antes de permitir que mergee nada.
Semana 3 — el tren de release. Cuenta de servicio acotada a la pista interna, fastlane supply, changelog generado desde commits con la regla del hash. Mantén la promoción a producción manual un mes.
Semana 4 — BrainSuite y crecimiento. Son los que dependen del gusto, así que van al final y salen detrás de un paso de aprobación.
El orden es deliberadamente anticlimático. Todos los proyectos de agentes que he visto fracasar empezaron por el flujo creativo, porque es el divertido, y se saltaron el aburrido que demuestra la fontanería.
Lo que no automatizaría
- La curva de dificultad. Un solucionador puede demostrar que un puzzle es válido; no puede decirte que el conjunto de diez es una buena tarde. Eso es gusto, y es el producto.
- La voz de las notas de release. Generarlas desde commits está bien. Dejar que el agente decida el tono es cómo acabas sonando como otra empresa cada semana.
- Precios y monetización. Ningún agente debería poder cambiar un precio sin que un humano lea la frase entera en la que aparece.
- Usuarios enfadados. Triaje, sí. Respuestas, no. Una respuesta empática enlatada a alguien que perdió su racha en el nivel 300 es peor que el silencio.
- Cualquier cosa que edite sus propias salvaguardas. Un archivo de prompt, un validador, una configuración de CI, una skill que define las reglas: esos diffs siempre necesitan un humano, y hay que decírselo al agente explícitamente en vez de confiar en que lo deduzca.
El stack que ejecutaría de verdad
Para PuzzleSuite y BrainSuite con un solo desarrollador y un mini PC que se queda encendido:
Hermes como motor — cron para los trabajos nocturnos, un tablero Kanban para todo lo que necesite traspaso o revisión, skills para el dominio de puzzles, Telegram como teléfono. Cero coste de licencia, y la memoria es la parte que compone.
OpenBot como cabina, opcional — si ya pagas Claude y ChatGPT y quieres una app de escritorio con clientes nativos de iPhone y Android, importa tus perfiles de Hermes y haz ahí el trabajo interactivo. Mantén la cola nocturna en Hermes para que haya exactamente un dueño del horario.
Paperclip cuando llegue el segundo humano — no antes. Su organigrama, sus presupuestos en dinero y sus aprobaciones impuestas por el runtime son la respuesta correcta a “tres personas y una tarjeta compartida”, y sobredimensionados para una persona con un portátil. Cuando llegue, mete Hermes dentro como runtime y deja que Paperclip sea dueño de presupuestos y firmas.
Y lo que no haría: ejecutar los tres planificadores a la vez. Dos sistemas que creen ser dueños del trabajo nocturno producen nada o el doble. Elige al dueño de la cola, escríbelo y haz que las otras herramientas le llamen.
El resumen honesto
Los agentes no hicieron el producto. Lo hizo el validador. El agente solo lo ejecuta a las 02:00, veinte veces, sin quejarse, y mete a los supervivientes en un pull request que una máquina puede rechazar.
Ese es todo el truco, y es la razón de que la elección de plataforma importe menos que el orden en que lo construyes: primero lo que sabe decir que no, después lo que trabaja mientras duermes, luego la interfaz con la que compruebas tomando café.
Si quieres la comparativa mecanismo a mecanismo que hay detrás de estos flujos —webhooks, presupuestos, heartbeats, memoria, licencias— está aquí: OpenBot vs Hermes vs Paperclip: ¿quién despierta al agente?.
También te puede interesar
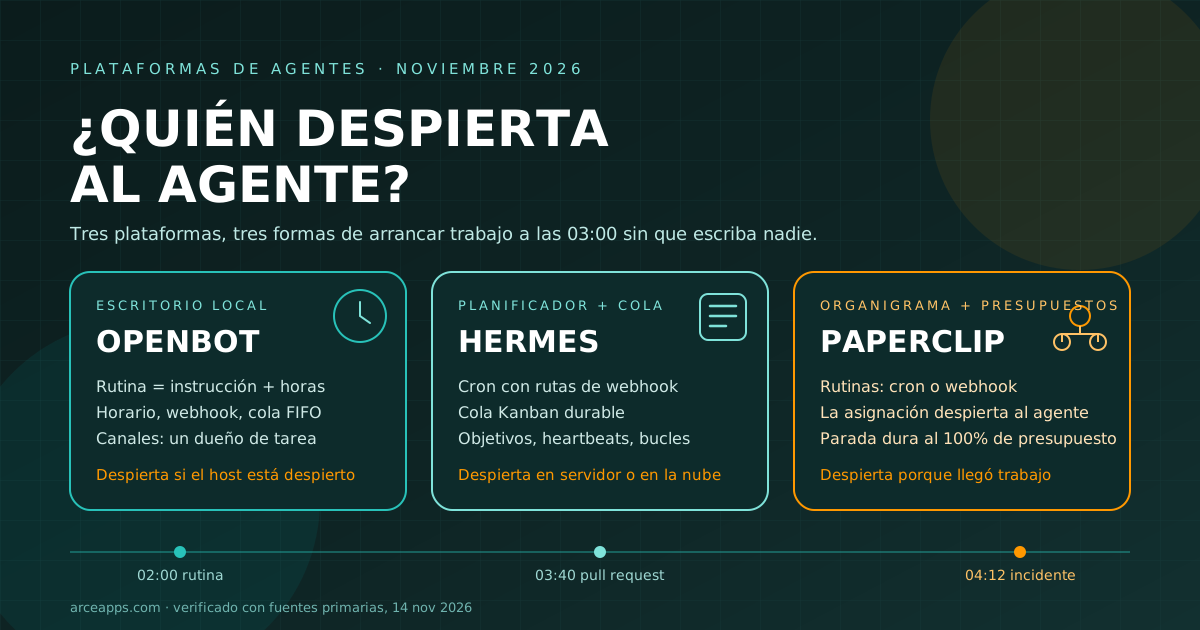
OpenBot vs Hermes vs Paperclip: ¿quién despierta al agente?
OpenBot, Hermes Agent y Paperclip comparados por la pregunta que lo decide todo a las 3 de la mañana: qué despierta al agente, qué recuerda y qué lo frena.
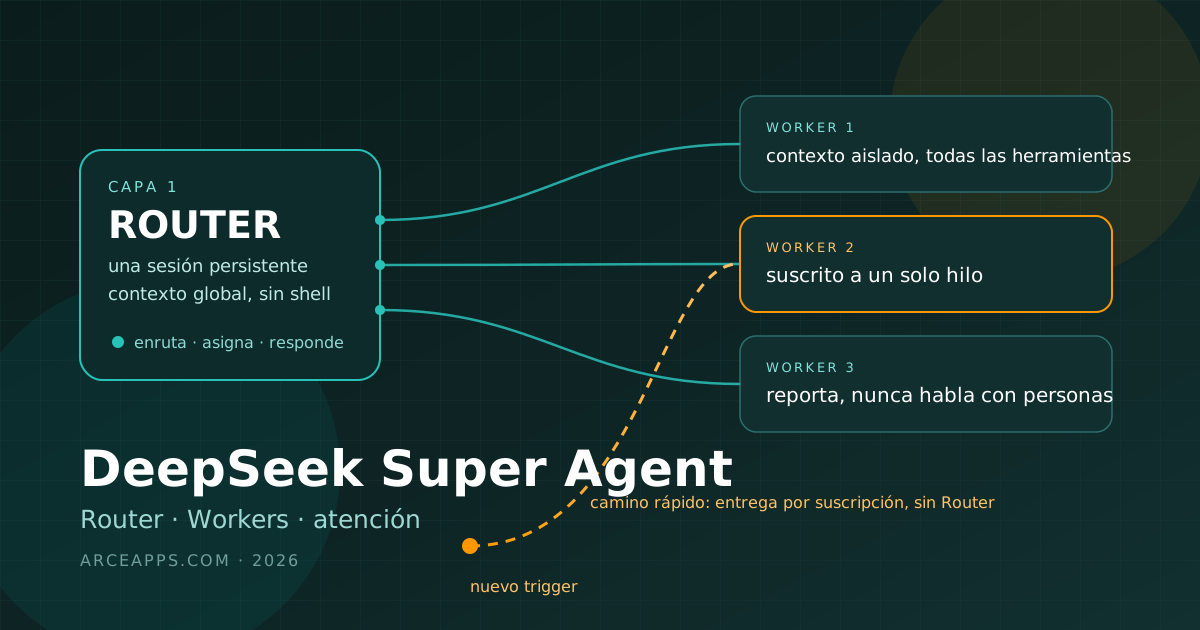
DeepSeek Super Agent: Router, Workers y atención
DeepSeek publica un prototipo MIT de su Super Agent: un Router y varios Workers aislados. Qué hace, qué demuestran sus cifras y qué cuesta montarlo.

Orquestando Agentes de IA en tu Pipeline de CI/CD
Aprende a integrar agentes especializados de IA (revisión de código, documentación, benchmarks) en tu pipeline CI/CD de Android con GitHub Actions y AGENTS.md.