
DeepSeek Super Agent: Router, Workers y atención
Índice de contenidos
Contexto en ArceApps: ya desmonté el runtime de plugins de DeepSeek Harness, lo comparé con OpenCode, Codex y Claude Code y analicé su versión Desktop. Este artículo sube una planta: qué ocurre cuando el agente deja de ser una ventana que abres y se convierte en un servicio que vigila un repositorio mientras haces otra cosa.
El 31 de octubre de 2026 el equipo de DeepSeek Harness publicó un ensayo en lugar de un producto. Se titula Exploring Super-agent Design: Towards a More Autonomous Agent System, salió primero en WeChat y después como artículo en X, y venía con un regalo pequeño: un repositorio con licencia MIT llamado dsh-superagent-prototype. Sin evento de lanzamiento, sin directo, sin tabla de benchmarks diseñada para ganar una discusión en redes.
Cuando lo consulté, el 12 de noviembre de 2026, ese repositorio tenía 22.733 estrellas y 2.766 forks, y su último push era de nueve días antes. Esa relación entre atención recibida y actividad real del código dice bastante. La gente no lo clona porque piense montar mañana un agente de código para un equipo entero. Lo clona porque el ensayo nombra algo que muchos llevábamos meses sintiendo sin saber cómo decirlo.
El argumento es más o menos este: el techo de una tarea individual lo pone el modelo; el techo de hacer varias a la vez lo pone la persona. Según su propia observación, alguien puede seguir con comodidad entre tres y cinco sesiones activas. Por encima de ese número ya no supervisas agentes: operas una centralita telefónica con problemas de memoria. Y la respuesta del sector, hasta ahora, ha sido abrir más sesiones.
Leí el ensayo dos veces, luego el código y después las instrucciones de despliegue, que son más interesantes que ambos. Lo que sigue no es un resumen. Es lo que me llevo, lo que creo que sus números demuestran de verdad y dónde no pienso seguir a DeepSeek.
Qué publicó DeepSeek exactamente
Salieron tres cosas a la vez, y confundirlas es la vía más rápida a malinterpretar el lanzamiento.
La primera es un ensayo. Es un documento de arquitectura escrito por gente que opera ese sistema por dentro, no un anuncio de funcionalidades. Lo dice en su primer párrafo: explora ideas de ingeniería y no presenta características ya existentes del producto.
La segunda es un prototipo. El README es directo de una forma poco habitual. Llama al código «research prototype for reference only», afirma que «no es un producto oficial de DeepSeek», reconoce que buena parte de la ingeniería la hicieron agentes de código, avisa de que el estilo y las prácticas pueden ser inconsistentes y aclara que se ha adaptado para publicarlo, así que no es idéntico a su versión interna. Y añade la frase que ojalá escribieran más equipos: algunos diseños del artículo son direcciones futuras y no están implementados en el prototipo.
La tercera es el despliegue interno que describe el ensayo. Una instancia de Super-agent que lleva tiempo corriendo dentro de DeepSeek, participando en la reproducción de incidencias, en respuestas a revisiones de código y en el desarrollo del propio DeepSeek Harness. Eso no se descarga. Solo puedes leer su forma e intentar aproximarla con el prototipo y tu propia infraestructura.
La prensa fundió las tres cosas en un solo relato. La cobertura de Bloomberg, sindicada por The Straits Times el 1 de noviembre de 2026, lo describió como un agente de código prototípico llamado a rivalizar con Claude Code, capaz de vigilar chats de desarrolladores y proponer arreglos sin que nadie se lo pida. Seoul Economic Daily lo resumió como una arquitectura en la que routers y workers ejecutan varias tareas a la vez para aliviar el cuello de botella de la atención humana. Ambas descripciones son correctas y ambas se saltan lo que a mí me importa: esto va sobre dónde queda la sesión en un sistema de agentes, no sobre un modelo más listo.
Aquí no hay modelo nuevo. No hay benchmark de programación. Hay una tesis sobre diseño de sistemas, una implementación de referencia de esa tesis y mucha gente que reconoció el problema.
El cuello de botella es tu atención, no la ventana de contexto
Todas las herramientas de agentes que uso fallan igual al escalar, y no es por falta de inteligencia. Fallan porque la unidad de trabajo es una conversación. Una sesión, un hilo de contexto, una cosa a la vez salvo que abras otra pestaña a mano y recuerdes qué estabas haciendo en la primera.
El ensayo describe las consecuencias con precisión. Una sola sesión da continuidad, porque todo cae en el mismo contexto, pero serializa la ejecución detrás de un único bucle ReAct y mezcla los detalles intermedios de tareas que no tienen nada que ver. Abre una sesión por evento y ganas concurrencia, pero pierdes la visión global, y varias sesiones acaban contestando a la misma persona con voces distintas. Ninguna opción es incorrecta. Optimizan cosas diferentes y casi todas las herramientas te obligan a elegir a mano, tarea a tarea, todo el día.
Las cuatro propiedades que DeepSeek persigue son continuidad entre canales, paralelismo entre tareas, proactividad ante eventos y persistencia frente a fallos. Ningún bucle único ofrece las cuatro, y eso no es polémico: cualquiera que haya visto una llamada a herramienta bloquear una conversación lo sabe. Lo interesante es la afirmación de que esas cuatro propiedades empujan hacia una arquitectura concreta, y que esa arquitectura se parece sospechosamente a cosas que los sistemas operativos llevan décadas haciendo.
El enfoque es honesto y un poco desinflante a la vez. Camino rápido y camino lento, ejecución especulativa, separar cómputo del estado, un watchdog externo, caché por localidad: nada de eso es nuevo. Lo nuevo es ensamblarlo en un sistema de agentes y publicar el ensamblaje con mediciones, incluidas las que no le favorecen. Eso es menos común que las ideas.
Un Router, muchos Workers
El reparto central son dos capas con trabajos deliberadamente desiguales.
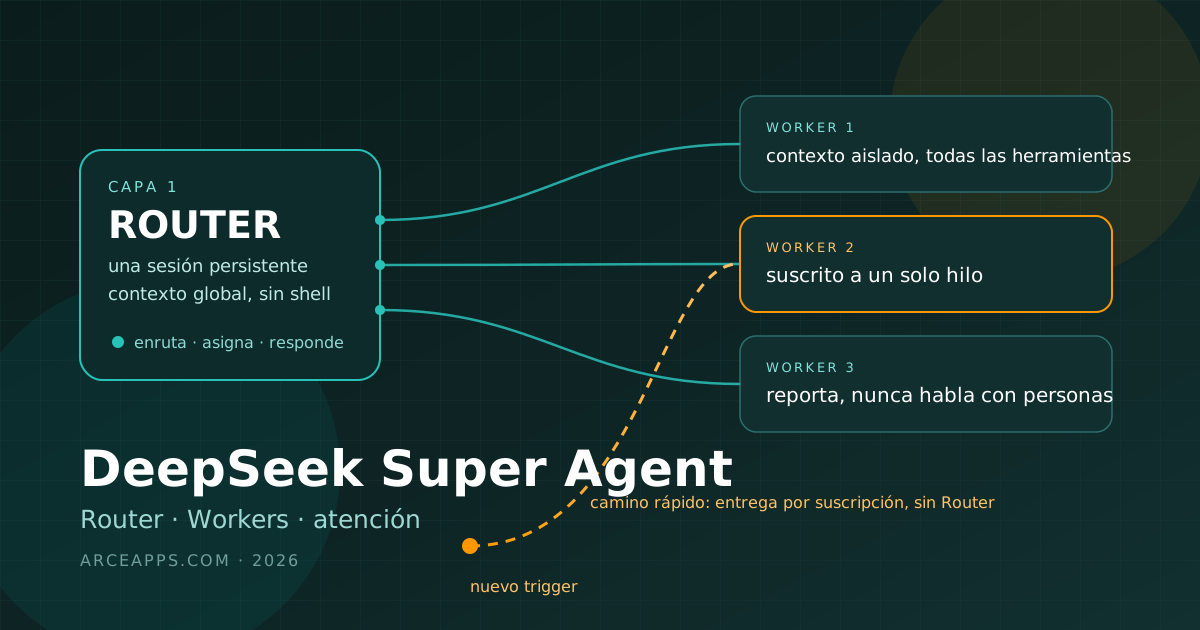
El Router es una sesión de larga vida que posee toda la interacción humana, venga del canal que venga. Mantiene la foto global, decide qué se convierte en trabajo, lo asigna y habla con la gente. Y está diseñado para no ejecutar. El ensayo dice que puede no tener ni herramienta de Bash. En el prototipo se ve en los presets: el router recibe un conjunto reducido de herramientas para enrutar, el worker recibe las de trabajar.
Los Workers toman una tarea cada uno, en un contexto aislado y con todas las herramientas. Nunca hablan con humanos. Su razonamiento y sus llamadas quedan dentro de su sesión; reportan al Router y el Router contesta. Los Workers suelen llevar el modelo más capaz; el Router, a menudo, no lo necesita.
Ese último punto es el que me ronda, porque es una decisión de coste disfrazada de decisión de arquitectura. Un Router que solo tiene que leer un mensaje, decidir si es trabajo y colocarlo en el contexto correcto es una carga de entrada larga y salida corta. Se beneficia del caché de prompt y del batching, no de razonar profundo. Poner ahí tu modelo más caro es desperdicio; poner uno barato en un Worker es un ahorro falso.
La comparación con un «Agent Team» merece interiorizarse, porque las palabras se parecen y el trabajo no. Un jefe de equipo suele descomponer una tarea difícil en subtareas acopladas, y para eso necesita entenderla a fondo y coordinar sin parar. Un Router no descompone. Decide qué pieza independiente de trabajo entrante merece un Worker y mantiene el mapa entre tareas. Por eso su carga de razonamiento es menor y por eso el ensayo puede afirmar que un modelo más pequeño suele bastar.
Las capas son lógicas, no literales. Un Worker puede crear subagentes. El Router podría fragmentarse si la escala lo exigiera, a costa de memoria compartida. El prototipo elige la versión simple: una sesión de Router persistente, entrega directa por suscripción y ninguna conversación directa entre Workers. Sus experimentos sugieren que, a su escala de equipo, esa versión simple aguanta.
Triggers, Threads y el camino rápido
La segunda mitad del diseño trata de qué despierta al agente, y aquí el vocabulario de sistemas gana su sueldo.
Las entradas ya no son prompts escritos en una sesión. Son Triggers: mensajes de chat, comentarios de revisión, resultados de CI, eventos de calendario. Una secuencia de Triggers bajo el mismo pull request, el mismo tema de mensajería o el mismo hilo de correo forma un Thread. Los Workers se suscriben a Threads, y la suscripción es de muchos a muchos: un Worker puede seguir varios Threads y un Thread puede tener varios suscriptores.
Esa suscripción es lo que abarata el enrutado. El primer evento de un Thread pasa por el Router, que crea un Worker y lo suscribe. Todos los eventos posteriores de ese Thread los entrega el código directamente al Worker suscrito, sin pasar por el Router. El Router sigue observando, pero solo evalúa lo que nadie ha reclamado. Si un evento nuevo se sale del mandato del Worker, este puede devolverlo.
Los eventos que no están en un Thread suscrito toman el camino caro, y aun así el diseño evita llamar al modelo por todo. El filtrado tiene dos etapas. Primero, código determinista comprueba lo barato: qué fuente, qué ámbito, qué lista de permitidos, si el remitente es un bot. Solo los candidatos que sobreviven llegan al modelo, que aplica políticas escritas en prompts. El ensayo toma prestado el par camino rápido / camino lento de la ingeniería de sistemas, y el mapeo es exacto: decisiones frecuentes y conocidas en código, juicio semántico en el modelo.
El contexto recibe el mismo trato. En vez de volcar todo en la ventana, el sistema inserta lo que probablemente se necesite pronto, derrama el resto y conserva identificadores para que el modelo pueda volver al objeto completo. Chain of Recall es el nombre que dan a seguir esos identificadores salto a salto por Threads y sesiones relacionadas. Es un grafo de referencias con resúmenes en cada nodo, una forma mucho más honesta de manejar el historial largo que confiar en que la ventana sea enorme.
La última pieza es la ejecución especulativa, y es la que cambiaría mi día a día si funcionara con fiabilidad. Un agente puede empezar a preparar un resultado antes de que nadie lo pida: reproducir un fallo mencionado en un chat de grupo, buscar un arreglo y entregarlo solo si confirma el problema y encuentra algo sencillo. Si no, se queda callado. En su grupo interno de usuarios de Harness esa política existe. El coste es cómputo de fondo; el beneficio es que la respuesta ya está cuando alguien pregunta.
Un bucle que deja de bloquear
La proactividad no sirve de nada si la conversación se congela cada vez que corre una herramienta. El ensayo es sorprendentemente concreto con la solución: sustituir las llamadas bloqueantes run() por start() y stop(). Llamas a start(), recibes un acuse «Started» inmediato, sigues atendiendo a la gente y recibes el resultado final más tarde como un evento nuevo. El modelo puede llamar a stop() cuando algo lleva demasiado tiempo.
DeepSeek dice que el mecanismo asíncrono ya existe en DeepSeek Harness pero no está activado por defecto. El prototipo muestra las consecuencias operativas, y aquí la documentación se vuelve realmente útil. Los comandos de shell en primer plano pasan a segundo plano a los cinco segundos en el preset de worker. Si un turno termina con trabajos o subagentes aún corriendo, el Ticket conserva su hueco de worker. El trabajo de fondo tiene treinta minutos para terminar antes de que se maten los procesos de shell y el Ticket se reporte como en espera, con las últimas palabras del Executor y la lista de lo que se mató. Los subagentes pueden continuar.
Esos límites son lo que separa una demo de un sistema. Existen porque un agente que puede lanzar trabajo de fondo acabará lanzando trabajo que no puede terminar, y algo tiene que decidir cuándo dejar de fingir. Treinta minutos es arbitrario, pero es una decisión, y está escrita.
La etiqueta por canal sigue la misma lógica. En mensajería instantánea, la regla que probaron es dura y algo maravillosa: cada respuesta, como máximo cien palabras. Los canales asíncronos reciben el trato contrario: la descripción de un pull request debe contar problema, cambio y validación con detalle. Mismo agente, distinto ancho de banda. Casi todas las herramientas que he usado lo hacen al revés: vuelcan trazas de razonamiento en un chat y dejan comentarios de revisión de una línea.
Cómputo, estado, máquinas y watchdog
Las secciones cinco y seis del ensayo son donde el diseño deja de hablar de agentes y pasa a hablar de sistemas distribuidos, y donde la distancia entre ensayo y prototipo es mayor.
Un agente local ata tres cosas a una máquina: el cómputo que avanza el bucle, el estado de sesión que debe persistir y el entorno de ejecución con su repositorio, credenciales y toolchain. Cuando el portátil se duerme, las tres se paran. La solución propuesta son dos separaciones. Primero, separar el cómputo sin estado en contenedores elásticos del estado persistente en una base de datos, para que las sesiones sobrevivan a reinicios y escalen en horizontal. Segundo, separar el bucle en la nube de los entornos de ejecución cargados de estado, dejando el repositorio donde vive de verdad y conectando mediante un demonio ligero que no guarda estado de sesión y solo ejecuta comandos.
Al resultado lo llaman Bring Your Own Machine, y marcan la diferencia con el enfoque de Anthropic de «desacoplar el cerebro de las manos»: aquí los primeros entornos que se conectan son ordenadores personales, intermitentemente en línea, con cambios sin commitear y credenciales locales. Es un problema más difícil que un sandbox gestionado, y lo dicen.
El watchdog es la idea pequeña más interesante del ensayo. Los chequeos de proceso vivo no detectan a un agente que corre bien pero no avanza, o que se desvía del objetivo. Así que el watchdog es otra sesión de agente, fuera del sistema principal, despertada por mensajes programados, con un modelo juzgando si los workers hacen trabajo sustantivo. Como tiene herramientas, quien mantiene el sistema puede preguntarle en lenguaje natural qué pasó o pedirle que cambie los prompts del sistema en marcha.
Nada de esa separación en la nube es lo que instalas. El prototipo es un perfil de DeepSeek Harness en tu máquina, un directorio de estado local, un worktree por ticket y un panel web en 127.0.0.1. El watchdog de SETUP.md es una comprobación horaria desde otro perfil que repara el servicio cuando no está corriendo: eso es liveness, no criterio. El ensayo describe hacia dónde van. El repositorio es dónde están.
Quién puede pedir trabajo
Si te salta todo lo demás, lee el modelo de permisos, porque es lo que convierte «proactivo» de palabra de marketing en algo auditable.
Cada fuente tiene su lista de permitidos. Cada fuente tiene una tabla de admisión cuyas filas son ámbitos de recepción —un chat de Feishu, una superficie de GitHub— y cuyas celdas deciden en qué se convierte un mensaje que no menciona al agente: petición explícita, candidato inferido o nada. Los bots se reconocen y solo pueden producir candidatos, nunca peticiones explícitas. Un candidato lleva una fuerza: explícita, inferida o no admitida.
Luego viene el modo de aceptación, y este es el detalle que copiaría en cada agente que construya. off significa que nada inferido se convierte en candidato. observe, el modo por defecto en el setup, significa que los candidatos inferidos se evalúan y una evaluación positiva se registra como «lo habría aceptado» sin hacer nada. auto significa que la evaluación arranca trabajo de verdad. Se supone que empiezas en observe, lees las decisiones registradas y solo entonces amplías.
La unidad de autorización no es la sesión, es el Mandate: una concesión inmutable que registra la versión de la política, el alcance, la fuerza, las reglas coincidentes y la identidad del remitente. Un Ticket termina, el Mandate no; solo lo retira una persona al parar, y una política que ya no lo sostiene lo revoca. Cuando la política cambia con trabajo en marcha, el cambio se entrega al ticket en lugar de cancelarlo en silencio.
Toda esa estructura existe para responder una pregunta: qué puede hacer el agente sin que nadie se lo pida. Casi todos los sistemas la responden en un prompt y esperan que salga bien. Este la responde con una política versionada y un registro de decisiones.
Viene con un aviso que debería citarse en toda revisión de este tipo de herramienta. Los presets de worker corren con danger-full-access como el usuario del sistema operativo del operador. Un worker puede ejecutar programas por ruta y leer tu directorio personal. La recomendación de la propia documentación es usar una cuenta de sistema dedicada que solo contenga las credenciales del agente, porque los envoltorios de cuenta no aíslan el proceso. Un agente siempre encendido que puede leer todo tu home y actuar en tu nombre en GitHub no es un juguete, diga lo que diga la licencia.
Qué midieron los experimentos
La sección de resultados es corta, sintética y más honesta que la mayoría de benchmarks de proveedor. Cuatro enfoques, cinco ejecuciones cada uno, con un flujo de unos 300 mensajes de chat y CI, de los cuales alrededor de veinte eran peticiones de trabajo. El trabajo de código se sustituyó por una herramienta que solo consume tiempo, así que el experimento mide planificación y coordinación, no si el agente escribe buen código.
| Métrica | Super-agent | Sesión única, prompt neutro |
|---|---|---|
| p50 de finalización | 12,4 min | sin p50 reportado |
| p95 de finalización | 15,7 min | 29,5 min |
| Delegación | Workers por construcción | Subagente no invocado en 5 de 5 ejecuciones |
| Tokens de cache-read por ejecución | 23,23 M con entrega directa | línea base más alta, sin cifra equivalente en la tabla |
El titular es el p95: 15,7 minutos frente a 29,5. Si divides uno entre otro sale aproximadamente 1,9×, que es de donde vienen los titulares de «1,9 veces más rápido». Es aritmética sobre sus cifras, no una afirmación suya, y mide planificación bajo una carga sintética. Con un prompt que prioriza delegar, la sesión única mejoró y delegó en cuatro de cinco ejecuciones, pero siguió perdiendo en conjunto, y la quinta produjo una cola larga porque el modelo decidió que la tarea era pequeña e hizo el trabajo él mismo.
Los números de sobrecarga son los que más me creo, porque la sobrecarga es difícil de maquillar. Eliminar la entrega directa por suscripción dejó los tiempos de finalización prácticamente iguales, pero aumentó las decisiones del Router alrededor de un 30% y llevó los tokens de cache-read de 23,23 M a 31,77 M por experimento, un 37% más. Dicho de otro modo: la optimización que parece barata vale un tercio de la factura de tokens del Router con esta carga.
El experimento de batching es independiente y más limpio. El Router usó un modelo real y los workers uno simulado. Al subir la llegada de triggers de aproximadamente uno por minuto a unos cuarenta, el tamaño medio de lote pasó de 1,0 a 2,8, la duración de una petición de 2,5 a 3,9 segundos y el tiempo de inferencia amortizado por decisión bajó de 6,4 a 1,6 segundos. Es la economía de prefill con entradas largas y salidas cortas haciendo exactamente lo que uno espera, y explica por qué una sola sesión de Router no se convirtió en cuello de botella a su escala.
Lo que los experimentos no muestran: calidad del código, comportamiento en un repositorio real durante semanas, coste por pull request fusionado o cuánta atención humana se ahorró de verdad. Nadie midió interrupciones por tarea completada, que es justo la métrica sobre la que discute todo el ensayo. Me gustaría ver ese estudio. Hasta entonces, tomemos los números como evidencia de que el enrutado funciona, no de que el producto funcione.
Montarlo como desarrollador indie
El documento de despliegue no tiene nada de humo. Necesitas Node 22.19+ o 24+, pnpm, git 2.32+, Python 3.8+, tmux, GitHub CLI 2.48+ y una versión de DeepSeek Harness dentro del rango que declara package.json (la documentación fija 0.2.1-rc.3). Necesitas un perfil dedicado de DeepSeek Harness llamado superagent, separado del que usas para trabajar, porque el plugin cambia el PATH y la configuración de git de todo el proceso. Necesitas una cuenta de usuario de GitHub para el agente, con permiso de escritura, autenticada en su propio envoltorio de gh; una GitHub App no sirve, porque el sistema lee las notificaciones de la cuenta. Feishu es opcional y requiere lark-cli.
La instalación son cuatro comandos, y luego empieza el trabajo de verdad.
npm install -g @deepseek-ai/dsh@0.2.1-rc.3
git clone <this repository> dsh-superagent && cd dsh-superagent
pnpm install && pnpm build
dsh superagent --from-default-profile web --dump-config > /dev/null
dsh plugin --profile superagent add "link:$PWD"
Después copias una configuración de máquina con un directorio de estado absoluto, decides qué repositorio vigila el agente, escribes un comando de preparación que cree un worktree de git por ticket y defines la política. Los valores por defecto son sensatos: puerto 3082, prefijo de rama agent/, modo de aceptación observe, comprobación de reparación cada hora desde tu propio perfil. El panel es local, que es el default correcto y también una limitación: esto no es un servicio que consultes desde el móvil.
La restricción que más me afecta es que una instancia vigila un solo repositorio de GitHub. Yo tengo media docena de proyectos. Seis instancias, seis cuentas de agente dedicadas, seis directorios de estado, seis juegos de tokens, en una máquina que debe quedarse despierta. No es imposible; es un hobby en sí mismo. El usuario previsto es un equipo con un repositorio y varias personas, que es justo el escenario donde la atención escasea y una cuenta de agente compartida tiene sentido.
Dónde encaja en mi stack
He escrito sobre las capas que rodean a esta, y conviene no mezclarlas.
El runtime de plugins trata de cómo se componen las capacidades dentro de un harness. La comparativa con OpenCode, Codex y Claude Code trata de qué harness y qué modelo elijo. El análisis de Desktop trata de cómo se siente al usarlo. Este ensayo sobre el Super-agent trata del sistema que decide qué sesión hace qué, una capa que ninguno de esos artículos toca.
También solapa con dos cosas que ya defendí. Mi artículo sobre routing de modelos para subagentes sostenía que las decisiones de enrutado son decisiones de presupuesto; este ensayo da a ese argumento un ejemplo medido, donde saltarse el router para los hilos suscritos ahorra cerca de un tercio de sus tokens. Y Dark Factory describía la fábrica de software siempre encendida como aspiración; aquí hay una implementación de referencia de la fontanería, con el capítulo de seguridad aún sin escribir.
Lo de seguridad tampoco es hipotético. Mis notas sobre fallos de seguridad en agentes y sobre benchmarks de memoria apuntan a las mismas dos grietas que tiene este diseño: entrada no confiable llegando a un actor siempre encendido, y memoria a largo plazo que nadie ha presupuestado. Las preguntas abiertas del propio DeepSeek dicen lo mismo, lo cual es humildad o un registro de riesgos exacto. Probablemente las dos cosas.
Las partes incómodas
La sección de seguridad del ensayo es la página más honesta del lanzamiento, y debería preocupar a cualquiera que piense ejecutar esto en una máquina con credenciales. Un bucle siempre encendido conectado a infraestructura en la nube y a demonios en dispositivos asume confianza mutua entre ellos. Si comprometen el bucle mediante una intrusión en el servidor o una inyección de prompt, todos los dispositivos conectados quedan potencialmente a su alcance. Incluso sin compromiso, las credenciales que entran en el contexto del modelo pueden filtrarse. Su conclusión es que hacen falta mecanismos para usar credenciales sin que el modelo las toque nunca, y que hasta entonces un Super-agent solo puede operar en un ámbito pequeño y de confianza.
Su respuesta sobre memoria a largo plazo es igual de insatisfactoria: el Router y Chain of Recall manejan tareas recientes, pero operar durante meses es el cuello de botella de escalabilidad. Quien haya tenido un agente vivo mucho tiempo sabe que eso no es un detalle. Es la diferencia entre un sistema que mejora con el historial y uno que olvida poco a poco por qué existe.
Y luego está la realidad de ingeniería del código de investigación. El README avisa de estilo y prácticas inconsistentes. Las peer dependencies están fijadas a paquetes 0.2.1-alpha.2 mientras la instalación fija 0.2.1-rc.3, que es el tipo de desajuste que te cuesta una tarde de depuración. Hay tests, muchos, pero no hay contrato de soporte ni promesa de compatibilidad. Cero issues abiertas en un repositorio tan popular no es una señal de salud; es señal de que nadie espera abrir una.
Y la validación independiente es más fina de lo que sugiere el número de estrellas. Cuando consulté Hacker News el 12 de noviembre de 2026, el envío más votado del repositorio tenía 11 puntos y ningún comentario. La conversación ocurrió sobre todo en X y en blogs técnicos en chino. No es razón para descartar el trabajo; es razón para leer el código en vez de las reacciones.
Qué copiaría
Cinco ideas, ordenadas por lo rápido que podría usarlas en mis propias herramientas.
La suscripción como camino rápido. Deja el coordinador caro para arrancar trabajo y enruta los seguimientos por identificador. Es la mejora de rendimiento más barata del diseño y no requiere un modelo nuevo.
Observar antes de automatizar. Registra lo que el agente habría hecho, revisa el registro y luego amplía permisos. Es una función de cinco líneas en casi cualquier orquestador y cambia el modo de fallo de «hizo algo mal» a «habría hecho algo mal».
La atención como presupuesto. Cuenta interrupciones por tarea completada, no solo tokens. Toda la premisa del ensayo es que el recurso escaso es la atención humana, y luego sus experimentos miden minutos y tokens. Yo puedo medir lo que de verdad me importa en mi flujo.
Filtrado determinista antes del modelo. Listas de permitidos y comprobaciones de ámbito en código; juicio semántico solo para los supervivientes. Mis cron jobs ya hacen una versión tosca; hacerlo a propósito recortaría muchas llamadas inútiles.
Un ticket no es una sesión. Un seguimiento debería reanudar la unidad de trabajo con su mandato e historial, no reabrir un chat y confiar en que vuelva el contexto. Las etapas del ticket en el prototipo, con estados de espera explícitos y una etapa de revisión humana, son buen vocabulario aunque nunca lo instales.
Veredicto
Lee el ensayo. Clona el repositorio si te gusta leer TypeScript escrito en buena parte por la cosa que describe, que es una experiencia extraña y algo melancólica. No lo pongas en producción y no lo ejecutes en la máquina donde viven tus claves SSH salvo que hayas seguido su consejo de una cuenta de sistema y una identidad de GitHub dedicadas.
Como documento de arquitectura es lo más útil que he leído sobre agentes este otoño, porque deja de fingir que lo difícil es el modelo. El Router sin shell, la tabla de admisión, el modo de observación, el coste en tokens de la entrega directa: son decisiones que puedo evaluar, discutir y copiar. Eso es lo que quiero de un lanzamiento así. No la promesa de que mi trabajo será autónomo, sino un mapa de dónde están las costuras.
Lo que sigo sin tener claro es si el reparto en dos capas sobrevive al contacto con proyectos largos y desordenados. Sus propias preguntas abiertas dicen que el modelo de memoria y el de seguridad no están resueltos, y no son notas al pie. Pero el diagnóstico es correcto, y el diagnóstico es la parte valiosa: pasadas tres o cinco sesiones, el límite soy yo.
Referencias
- Exploring Super-agent Design: Towards a More Autonomous Agent System — DeepSeek Harness Team. El ensayo original, publicado en chino en WeChat el 31 de octubre de 2026 y como artículo en X el 1 de noviembre; las secciones 2–9 son la fuente de todas las afirmaciones arquitectónicas de este artículo. https://x.com/i/article/2116829218935857152
- Exploring DeepSeek Super Agent Design (traducción completa al inglés) — Offloop. Traducción no oficial usada para las citas; el original chino sigue siendo la referencia. https://offloop.org/learn/exploring-deepseek-super-agent-design
- dsh-superagent-prototype README — GitHub, deepseek-ai. Alcance, el aviso «research prototype, not an official DeepSeek product» y la lista de diseños no implementados. https://github.com/deepseek-ai/dsh-superagent-prototype/blob/main/README.md
- 000 Philosophy — documentación de dsh-superagent. La atención como presupuesto de diseño; actuar solo si se pide o si una regla escrita lo permite. https://github.com/deepseek-ai/dsh-superagent-prototype/blob/main/docs/000-philosophy.md
- 001 Domain model — documentación de dsh-superagent. Source, Trigger, Thread, Eval, Mandate, Ticket, Assignment, Subscription y las reglas de cada uno. https://github.com/deepseek-ai/dsh-superagent-prototype/blob/main/docs/001-domain.md
- 002 Authorization — documentación de dsh-superagent. Listas de permitidos, tabla de admisión, fuerza de la petición y modos
off/observe/auto. https://github.com/deepseek-ai/dsh-superagent-prototype/blob/main/docs/002-authorization.md - 003 Execution — documentación de dsh-superagent. Etapas del ticket, huecos de worker, límite de treinta minutos y presets de router y worker. https://github.com/deepseek-ai/dsh-superagent-prototype/blob/main/docs/003-execution.md
- 006 Deployment — documentación de dsh-superagent. Requisitos, comandos de instalación,
danger-full-access, recomendación de cuenta de sistema y panel local. https://github.com/deepseek-ai/dsh-superagent-prototype/blob/main/docs/006-deployment.md - 007 Architecture — documentación de dsh-superagent. Runtime, Engine y el mapa de módulos detrás del modelo de dominio. https://github.com/deepseek-ai/dsh-superagent-prototype/blob/main/docs/007-architecture.md
- SETUP.md — dsh-superagent. Configuración guiada por agente y valores por defecto: perfil
superagent, puerto 3082, prefijoagent/, modoobserve, reparación horaria. https://github.com/deepseek-ai/dsh-superagent-prototype/blob/main/SETUP.md - package.json — dsh-superagent. Versión 0.1.0 con licencia MIT,
engines.dshen^0.2.1-alpha.2, Node 22.19 o 24. https://github.com/deepseek-ai/dsh-superagent-prototype/blob/main/package.json - Metadatos del repositorio — GitHub REST API. Creado el 2026-10-31T09:32:46Z, último push el 2026-11-03T09:29:14Z, 22.733 estrellas y 2.766 forks al consultarlo el 2026-11-12. https://api.github.com/repos/deepseek-ai/dsh-superagent-prototype
- DeepSeek Harness — DeepSeek. Página oficial del producto: preview pública, código abierto y arquitectura «everything is a plugin». https://www.deepseek.com/en/harness/
- DeepSeek drops enhanced coding agent with aim to rival Anthropic — The Straits Times / Bloomberg, 1 de noviembre de 2026. Cobertura del lanzamiento que lo presenta como rival de Claude Code y fecha el post de WeChat el 31 de octubre. https://www.straitstimes.com/asia/east-asia/deepseek-drops-enhanced-coding-agent-with-aim-to-rival-anthropic
- DeepSeek Unveils ‘Super Agent’ to Run Multiple Tasks at Once — Seoul Economic Daily, 1 de noviembre de 2026. El encuadre de routers y workers y el cuello de botella de la atención humana. https://en.sedaily.com/world/2026/11/01/deepseek-unveils-super-agent-to-run-multiple-tasks-at-once
- Envíos de Hacker News que mencionan dsh-superagent — API de Algolia para HN. El envío más votado tenía 11 puntos y ningún comentario al consultarlo el 2026-11-12. https://hn.algolia.com/api/v1/search?query=dsh-superagent&tags=story
- DeepSeek Harness’s “Super-agent” design: a Router with no Bash — sysnote, 1 de noviembre de 2026. Análisis independiente de lo que afirma el ensayo frente a lo que entrega el prototipo. https://sysnote.net/news/deepseek-harness-super-agent-design-router-workers
- DeepSeek’s Super-agent Design Puts a Router Behind Every Task — NYU Shanghai RITS, 2 de noviembre de 2026. Resumen que pone el acento en el argumento de la atención por encima del modelo. https://rits.shanghai.nyu.edu/ai/deepseeks-super-agent-design-puts-a-router-behind-every-task/
También te puede interesar

DeepSeek Harness Desktop: análisis de su app
Descubre DeepSeek Harness Desktop: instalación, plugins, automatización, seguridad y límites reales de su nueva aplicación para agentes de IA.

DeepSeek Harness: el runtime donde todo es un plugin
DeepSeek Harness (dsh) es un runtime open-source MIT donde modelo, herramientas, sesión, sandbox e incluso el loop son plugins. Análisis en profundidad: Cordis, modos, sesión append-only y self-evolution.
DeepInfer: qué ha abierto DeepSeek y qué falta
Descubre DeepInfer de DeepSeek: kernels optimizados, paralelismo MoE, inferencia determinista, requisitos reales y límites para alojar modelos.