
OpenBot: agentes, rutinas y flujos de trabajo
Índice de contenidos
La primera vez que reunimos tres agentes de programación en una misma interfaz es tentador pensar que ya tenemos un equipo trabajando. No lo tenemos. Tenemos tres modelos capaces de editar archivos y la posibilidad de multiplicar por tres nuestros errores de coordinación. OpenBot comienza a resultar interesante cuando dejamos de pensar en sus agentes como chats y empezamos a pensar en ellos como procesos con contexto, responsables y condiciones de salida.
OpenBot reúne Codex, Claude Code, Gemini, Grok, OpenCode y otros motores en un espacio de trabajo persistente. El usuario puede dar a cada agente una identidad, un directorio, instrucciones y herramientas, organizar conversaciones compartidas, encadenar pasos en workflows y recuperar el trabajo desde móvil o navegador cuando su host está accesible.
Esta es la segunda entrega de un díptico. En OpenBot vs MausBot: la nueva era de los asistentes comparé ambos enfoques, sus licencias y cinco tareas concretas. Anteriormente estudié OpenBot frente a Hermes y Paperclip desde el ángulo de la proactividad. Aquí no vuelvo a hacer una comparativa: quiero diseñar un sistema pequeño, comprobable y útil alrededor de OpenBot.
Las funciones y comandos de esta guía están contrastados con la documentación pública disponible a 19 de noviembre de 2026. Los ejemplos de organización son propuestas que puedes adaptar; no afirmo haber ejecutado una instalación propia ni medido tiempos. El otro OpenBot, el proyecto de CopilotKit en open.bot, no es el que describimos: aquí hablamos exclusivamente de nightly-labs/openbot y openbot.run.
Qué es y qué no es OpenBot
OpenBot no es otro modelo fundacional. Tampoco sustituye por completo al motor de los agentes que ya utilizas. Es una aplicación que ejecuta herramientas de IA existentes —como Codex o Claude Code— con una capa de identidad, persistencia, comunicación, interfaz, tareas y automatización.
Esa separación importa cuando se evalúan los resultados. Si Codex diagnostica mal un error, no significa necesariamente que el gestor de agentes haya fallado. Si una tarea nunca llega al revisor, podría ser un problema de cola, de permisos, de configuración del canal o de flujo. Si un agente pierde contexto tras cambiar de proveedor, es importante distinguir entre datos guardados, contexto que se envía al nuevo motor y datos que solo existían en la sesión original.
La documentación sitúa el estado de OpenBot en la máquina anfitriona, con una base SQLite y carpetas de trabajo. Los proveedores de modelos pueden seguir recibiendo prompts, archivos y resultados de herramientas según la tarea. Local-first significa que puedes poseer el registro de trabajo; no significa que todo el razonamiento ocurra desconectado.
En este blog ya explicamos por qué un agente necesita más que un historial de chat y cómo organizar rutas entre distintos proveedores. OpenBot aporta una interfaz en la que esas ideas pueden organizarse alrededor de asistentes que continúan existiendo entre sesiones.
Antes de instalar: tres decisiones que conviene tomar
La primera decisión es dónde deben ejecutarse las tareas. Puedes empezar en macOS, Windows o Linux con la aplicación de escritorio. Si necesitas un proceso disponible cuando apagas el portátil, la documentación contempla servidores Linux propios y Docker, además de opciones alojadas. La ubicación determina qué disco contiene los datos, qué credenciales puede leer el agente y qué sucede cuando el host duerme.
La segunda es con qué identidad del sistema se ejecutará. Un agente con acceso al terminal puede hacer todo aquello que permita su usuario del sistema, en la medida en que el runtime y los permisos del proveedor no lo limiten. Para experimentar, utilizaría una cuenta sin privilegios, un repositorio de prueba y sin claves de producción. No instalaría la aplicación con permisos de administrador para ahorrarme una pantalla de autorización.
La tercera decisión es qué motor usar primero. No empezaría conectando ocho proveedores. Uno basta. Si ya utilizas Claude Code, empieza por él; si tu flujo depende de Codex, arranca con Codex; si trabajas con OpenCode, revisa su integración. Añade un segundo motor únicamente cuando exista una función concreta que el primero no resuelve bien.
Antes de pulsar «aceptar», leería el modelo de permisos de OpenBot y su documento de privacidad. Las versiones documentadas pueden iniciar agentes con acceso muy amplio una vez aceptado el consentimiento inicial. No es un detalle secundario que debamos dejar para después de la primera automatización.
Instalación y primera configuración sin recetas imaginarias
La ruta más sencilla es visitar la página oficial de descargas y elegir el instalador de tu sistema. La aplicación te guiará para conectar un proveedor compatible. Utiliza su comprobación de conexión y asegúrate de que la CLI correspondiente funciona con la cuenta que piensas usar; que aparezca un modelo en un desplegable no garantiza que tu cuenta tenga acceso a él.
Crea un primer agente con una misión estrecha. Un buen ejemplo sería «Analista de incidencias», con acceso al repositorio de pruebas, capacidad para leer código y logs y una instrucción de no modificar nada sin definir primero el fallo. Evitaría llamarlo «superagente autónomo»: el nombre no aporta capacidades, pero sí puede inducir expectativas equivocadas.
La primera tarea no debería ser «corrige todo el proyecto». Pide algo delimitado:
Lee la prueba que falla y el archivo bajo prueba. Explica en qué punto divergen el comportamiento esperado y el observado. Guarda un diagnóstico con los archivos consultados y dos posibles soluciones. No modifiques el repositorio todavía.
Comprueba el resultado fuera del chat. ¿Existe el diagnóstico en el espacio de trabajo? ¿Incluye rutas y evidencias? ¿Distingue hechos de hipótesis? ¿Ha ejecutado comandos sin necesidad? Una tarea tan pequeña permite descubrir problemas de acceso, entorno y contexto antes de que existan efectos difíciles de deshacer.
Después añade un segundo agente revisor, no un coordinador de siete especialistas. Dos agentes con una frontera clara suelen aportar más valor que ocho roles vacíos.
Diseñar bien la identidad de un agente
La configuración efectiva de un agente no necesita una biografía de cien líneas. Necesita un propósito, un alcance, unas entradas, un entregable y unas condiciones de parada. También debe saber qué hacer cuando faltan fuentes o no puede continuar.
Por ejemplo, el agente Implementador puede tener esta misión:
Trabaja exclusivamente en la rama asignada y el directorio del proyecto. Antes de editar, inspecciona la implementación existente. Realiza el cambio mínimo que resuelve el requisito. Entrega un diff, las verificaciones ejecutadas y las limitaciones conocidas. No publiques ni fusiones sin una autorización explícita.
El agente Revisor utiliza otra:
Revisa el diff contra el requisito y las comprobaciones disponibles. Busca regresiones, casos límite, seguridad y cambios fuera de alcance. Señala observaciones concretas con archivo y línea cuando sea posible. No modifiques el trabajo del implementador salvo que se te pida expresamente.
Observa que los dos tienen resultados incompatibles con el autoengaño. El implementador no puede resolver el problema diciendo «todo bien»; debe producir cambios y verificaciones. El revisor no debe repetir un elogio genérico; debe identificar evidencia.
Un tercer agente de investigación puede ser útil si las tareas requieren fuentes externas frecuentes. Pero no crearía roles por deporte. Cada traspaso añade latencia, consumo de tokens y una oportunidad para perder información. Los agentes solo merecen existir por separado cuando la separación mejora control, calidad o claridad.
Workspace, conversación y memoria: no son la misma cosa
El espacio de trabajo guarda archivos. La conversación conserva la discusión. La memoria del agente intenta preservar conocimientos útiles. Son tres mecanismos distintos y no deberían mezclarse conceptualmente.
En un proyecto de desarrollo mantendría archivos sencillos: un brief de la tarea, las decisiones relevantes, referencias verificadas y un resultado final. Si se trata de una investigación, el entregable es un informe con fuentes; si se trata de código, el entregable real es el diff y su test. En ambos casos el hilo de chat resulta una bitácora complementaria, no la fuente exclusiva de verdad.
OpenBot permite cambiar el proveedor de un agente sin eliminar automáticamente su identidad y su carpeta de trabajo. Pero la documentación advierte que el nuevo modelo no necesariamente recibe toda la conversación previa: puede recuperar partes seleccionadas y buscar más información guardada. Por eso conviene mencionar explícitamente los archivos que debe volver a leer al retomar un trabajo.
Ejemplo de continuación:
Antes de continuar, lee el brief y el registro de decisiones de esta tarea. Confirma la rama y el commit actuales, comprueba qué verificaciones faltan y propón únicamente el siguiente paso más pequeño. No des por terminada ninguna comprobación si no puedes mostrar su resultado.
No necesitas construir una base vectorial para cada proyecto. A menudo una buena estructura de archivos y nombres coherentes resuelve más problemas que una memoria sofisticada que nadie inspecciona.
Un canal no es un grupo de agentes gritando a la vez
Los canales de OpenBot son conversaciones compartidas. Su decisión más valiosa es tener un propietario de la tarea en cada momento. El traspaso se comunica de forma explícita; el resto puede aportar información sin apropiarse simultáneamente del trabajo.
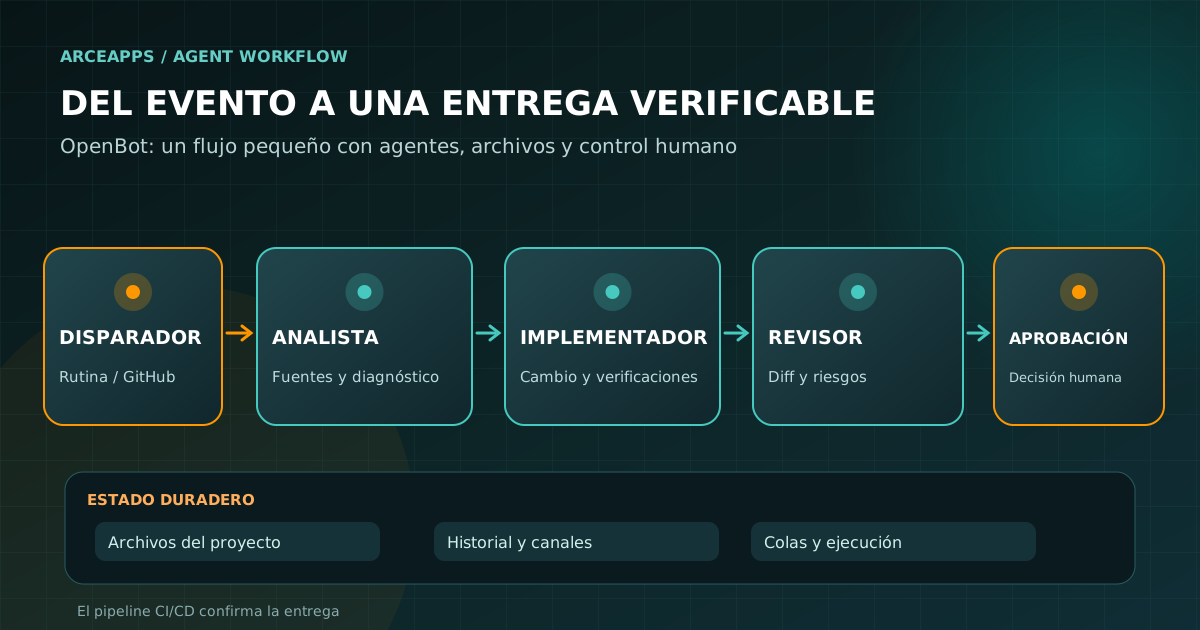
Para una incidencia concreta, imagino este recorrido:
- El humano aporta el requisito, el error reproducible y las condiciones de aceptación.
- Analista revisa evidencias y solicita la intervención de Implementador.
- Implementador crea una rama y produce un cambio comprobable.
- Revisor recibe el diff y las verificaciones, formula observaciones y devuelve el trabajo si es necesario.
- El humano revisa la entrega y decide si corresponde crear o fusionar la PR.
Esta secuencia es un diseño propuesto, no una garantía de que el producto haga todos esos pasos automáticamente sin configurarlo. La propiedad del canal debe reflejarse en quién tiene acceso de escritura al archivo principal y en quién puede publicar. Si los tres agentes comparten un directorio sin disciplina, un canal no evitará por sí mismo que se sobrescriban.
También conviene diferenciar el canal de un workflow. El canal sirve para colaborar en una tarea que puede cambiar de manos. El workflow codifica un proceso repetible con pasos definidos. Utilizaría canal para una investigación abierta y workflow para algo que ya hemos realizado varias veces con un procedimiento estable.
Rutinas: la forma más sencilla de empezar a automatizar
Una rutina de OpenBot es una instrucción y uno o varios momentos para ejecutarla. Es perfecta para trabajos recurrentes, pero no debe confundirse con un planificador de sistemas de garantías estrictas. No la utilizaría como única garantía de un pago, una copia de seguridad crítica o un evento que deba ocurrir exactamente una vez.
Empezaría con una rutina diaria del Analista de incidencias:
Revisa los cambios y fallos recientes que todavía no hayan sido resumidos. Si no hay novedades, termina sin producir trabajo artificial. Si existe una regresión, informa del identificador de commit o run, el error relevante, la hipótesis y la siguiente comprobación. No modifiques código ni abras PR automáticamente.
La frase «si no hay novedades» tiene valor económico. Una instrucción que exige encontrar siempre un problema puede fabricar conclusiones para justificar la ejecución. Lo ideal es que la rutina sea silenciosa cuando no hay nada útil que informar.
Las rutinas pueden responder a horarios y también existen disparadores por webhook. Cuando el equipo anfitrión está apagado, sus capacidades no funcionan como un servicio 24/7 salvo que haya una instancia disponible. Si el flujo depende de continuidad, hay que revisar despliegue, reintentos, entrega de eventos y comportamiento ante reinicios.
Dejaría en el registro de la rutina el ID del evento analizado, el resultado y cualquier bloqueo, para distinguir un trabajo completado de uno que simplemente comenzó.
Workflows: del prompt único al proceso visible
OpenBot dispone de un editor de workflows que conecta pasos de agentes, modelos y aprobaciones. La documentación oficial muestra un flujo donde un agente produce un informe y un paso de Approval exige revisión antes de distribuirlo. Esa separación permite incorporar una frontera que un simple prompt no asegura.
El error típico consiste en dibujar un diagrama enorme antes de saber qué tarea queremos resolver. Yo empezaría por un flujo de tres pasos: preparar → revisar → aprobar. Solo cuando funciona añadiría disparadores automáticos, ramificación o publicación.
Un ejemplo para el mantenimiento del blog:
| Paso | Responsable | Entrada | Salida y criterio |
|---|---|---|---|
| 1. Investigar | Agente Research | Tema y fuentes oficiales | Brief con enlaces y dudas |
| 2. Redactar | Agente Writer | Brief aprobado | Markdown con metadatos y bibliografía |
| 3. Verificar | Agente Reviewer | Markdown y schema | Lista de errores o PASS con evidencias |
| 4. Aprobar | Humano | Archivos y diff | Decisión explícita |
| 5. Publicar | Pipeline CI/CD | Commit revisado | Build y despliegue comprobados |
La imagen mental correcta no es «cinco modelos debatiendo». Es una cadena de artefactos. Cada paso crea algo que el siguiente puede inspeccionar. El paso final puede dejarse a GitHub Actions, sin necesidad de pedirle a un agente que replique las mismas comprobaciones dentro de un terminal improvisado.
Los workflows más recientes también contemplan disparadores relacionados con GitHub; como todas las integraciones, requieren configuración de cuenta, repositorios y permisos. Comprueba los triggers reales contra la versión instalada y consulta el changelog si algo no funciona como en la documentación.
Un caso completo: corregir un bug sin saltarse la revisión
Supongamos que una web Astro empieza a producir una página vacía después de un cambio en el frontmatter. El propósito no es maximizar la autonomía, sino reducir el trabajo repetitivo sin ceder el control de publicación.
Primero, un evento de GitHub o una instrucción manual entrega al agente Analista la referencia exacta del fallo. El agente inspecciona el job y guarda un breve diagnóstico. No escribe código: mantiene claro qué se ha comprobado y qué se supone.
Segundo, un agente Implementador recibe ese diagnóstico, las condiciones de aceptación y una rama. Reutiliza componentes y convenciones existentes, cambia solo lo necesario y deja un diff. Puede ejecutar pruebas focalizadas que CI todavía no cubre, pero no tiene sentido repetir una batería completa ya automatizada en Actions si no aporta nueva información.
Tercero, el Revisor compara el diff con el requisito original. Comprueba si hay una excepción innecesaria, un enlace roto o una regresión evidente. Si encuentra un fallo, lo comunica al implementador con evidencia. Si no, deja constancia de qué examinó; no equivale a una aprobación automática para publicar.
Cuarto, un humano o el procedimiento autorizado decide crear y fusionar la PR cuando los checks relevantes estén verdes. El despliegue lo realiza el pipeline existente. Después se comprueba que la página real sirve la versión esperada. Si la comprobación falla, el trabajo vuelve al flujo: «mergeado» no significa «entregado».
La ventaja del sistema no está en que todos esos pasos sean exclusivos de OpenBot. Está en que identidad, mensajes, historial y orquestación pueden vivir en un mismo espacio mientras Git y CI siguen siendo las fuentes de verdad de la entrega.
Automatizar desde scripts: OpenBot tiene una CLI local
Hay una función menos visible y muy práctica para desarrolladores: la API de scripts locales, acompañada por openbot-cli. Permite enviar mensajes a agentes, esperar la respuesta, disparar rutinas o consultar solicitudes pendientes desde scripts ejecutados en el mismo host que ejecuta OpenBot.
El ajuste Local scripts se habilita por agente en Permisos y está desactivado por defecto. En macOS, por ejemplo, la documentación localiza el archivo CLI dentro de la aplicación. Estos comandos aparecen en la referencia oficial:
alias openbot-cli='node "/Applications/OpenBot.app/Contents/Resources/cli/openbot-cli.mjs"'

# Enumerar agentes que permiten scripts locales
openbot-cli list

# Pedir una comprobación y esperar la respuesta
openbot-cli run "Ada" "Run the tests and tell me what failed" --wait

# Enviar una tarea desde un archivo y obtener JSON
openbot-cli run "Ada" - --wait --json < task.md
La ruta anterior es específica de macOS. Linux y Windows almacenan la CLI en ubicaciones diferentes indicadas en la documentación. Además se necesita Node 18 o posterior para ejecutar el archivo CLI. No basta con copiar el alias en cualquier sistema operativo.
Hay varios detalles de contrato importantes. Sin el argumento de espera, el comando puede devolver cuando el mensaje entra en cola, no cuando termina el trabajo. Con espera, devuelve la respuesta de la ejecución, pero un timeout de la espera no cancela la tarea. La documentación contempla códigos distintos para trabajo completado, error, espera de una aprobación, timeout y host no disponible.
Si un script pudiera reintentarse, utilizaría la clave de idempotencia documentada en la opción —id en lugar de enviar mensajes repetidos sin control. Un proceso que recibe dos notificaciones del mismo fallo no debería abrir dos incidencias por accidente.
Y no confundiría este puente con una API pública expuesta a Internet: la interfaz se publica en loopback, con token y archivos de credenciales locales. Convertirla en un endpoint abierto mediante un túnel mal configurado sería ampliar significativamente su superficie de ataque.
Cómo combinar OpenBot, OpenCode, Codex y Claude sin un laberinto
El valor de OpenBot está en poder reunir distintos motores sin que la plataforma decida que todos son idénticos. Codex y Claude Code tienen modelos, herramientas y semánticas de permisos propias. OpenCode y otros agentes compatibles con ACP aportan otra ruta. También existen endpoints compatibles con OpenAI y servicios de inferencia local como Ollama o LM Studio.
No diseñaría una arquitectura donde todos se llaman entre sí arbitrariamente. Definiría un motor principal por tipo de trabajo y dejaría los cambios de modelo como una decisión concreta. Por ejemplo, un agente de investigación puede usar una opción de menor coste; la implementación compleja puede exigir un motor más capaz; el revisor debe ver el artefacto final, no heredar ciegamente la conclusión de quien lo escribió.
El resultado de un modelo no se transporta íntegro al otro: sesiones, estado interno y herramientas pueden variar. Por eso el fichero de requisitos y el diff resultan cruciales. Si cambio el motor de un agente a mitad del trabajo, le pido que recupere el contexto desde los artefactos y confirme qué entiende, no que improvise continuidad perfecta.
En un proyecto indie, el primer criterio de selección debería ser la tarea y el entorno, no el modelo más nuevo. Un agente compatible con tu flujo Git puede ser más valioso que uno con mejores números en una prueba sintética pero sin acceso adecuado al repositorio.
Los permisos de OpenBot no son un asunto de estilo
La documentación de inicio y de privacidad describe un comportamiento de alto poder: los agentes pueden ejecutar comandos, modificar archivos, usar la red y controlar el navegador con mecanismos de acceso amplios después del consentimiento inicial. Eso hace posible una gran autonomía, pero implica riesgo real.
La opción «Workspace only» descrita por OpenBot limita escrituras para proveedores compatibles. No impide por sí sola leer otros directorios ni acceder a la red. Si quieres aislar secretos, debes controlar el usuario del sistema, los directorios montados, la red y, cuando corresponda, la virtualización o el contenedor. Los permisos visibles en la interfaz complementan esas barreras; no las sustituyen.
Para agentes que revisan páginas externas, trataría cualquier texto recibido como contenido no confiable. Una instrucción en una issue o en una página HTML no puede autorizar borrar archivos, leer el llavero ni publicar información privada. Las páginas pueden contener ataques de prompt injection aunque se vean perfectamente normales.
Y los permisos deberían crecer por necesidad. El Investigador no necesita modificar el repositorio. El Implementador no necesita claves de publicación. El Revisor no necesita poder fusionar PR. El Publicador no necesita ser propietario de todos los archivos privados del equipo. Un único superagente que lo puede todo es cómodo hasta el primer error serio.
Un servidor propio: cuándo merece la pena
Para pruebas ocasionales, la app de escritorio basta. Si quieres que una rutina trabaje mientras el portátil está cerrado, necesitas una instancia que permanezca accesible. OpenBot documenta instalación en servidores Ubuntu y un despliegue Docker con imagen oficial.
La guía de Docker incluye este procedimiento básico de Compose para un servidor:
curl -fsSLO https://raw.githubusercontent.com/nightly-labs/openbot/main/docker/compose.yaml
curl -fsSLO https://raw.githubusercontent.com/nightly-labs/openbot/main/docker/seccomp.json
docker compose up -d
docker compose exec openbot openbot login
Es un ejemplo extraído de documentación oficial, no una instalación validada por mí. Antes de ejecutarlo, inspeccionaría los archivos descargados, fijaría versiones cuando corresponda y comprobaría los requisitos de Docker, recursos y acceso a la cuenta. No montaría el directorio personal completo del host ni el socket de Docker dentro del contenedor.
La documentación es especialmente explícita: los agentes dentro del mismo contenedor pueden acceder a archivos y procesos de otros agentes bajo el mismo usuario. El contenedor es una frontera frente al host, no necesariamente una separación completa entre agentes. Si los agentes no deben compartir secretos, hay que plantear instancias distintas.
Tampoco habilitaría network_mode: host por simple comodidad. La guía advierte de que puede eliminar el aislamiento de red del contenedor y hacer accesibles servicios locales que no lo eran. Un despliegue fiable necesita conocer sus fronteras, no solo arrancar correctamente.
Para un servidor Ubuntu sin pantalla hay una guía específica de self-hosting. Recomendaría empezar por los instaladores documentados, revisar sus scripts y utilizar una cuenta dedicada. El mantenimiento, las copias de seguridad, la actualización y el registro de incidentes siguen siendo responsabilidad de quien hospeda el sistema.
Móvil y navegador: supervisar sin trasladar el cerebro
OpenBot tiene clientes iOS, Android y web. Su utilidad es poder consultar, asignar o seguir el trabajo de los agentes, no convertir el teléfono en una máquina de ejecución permanente de todos los motores. Los procesos, los directorios y las credenciales siguen donde esté el host.
Esto cambia cómo diseñaría las aprobaciones. Un agente puede preparar una modificación y esperar; tú recibes el contexto desde el móvil y decides continuar o detenerlo. El resumen debería incluir qué archivo o servicio se alterará, qué verificación lo respalda y cuál es el riesgo. Si la aprobación solo muestra «¿continuar?», no es un control suficiente.
Con un servidor en casa o en un VPS, también revisaría el mecanismo de conexión remota documentado por OpenBot y mantendría versiones compatibles del cliente y del host. La existencia de una app móvil no garantiza conectividad cuando el servidor duerme, cuando expira una sesión o cuando una red restringe la conexión.
Por eso una buena automatización debe poder esperar a la persona sin entrar en un bucle ni consumir solicitudes innecesarias. La movilidad mejora la supervisión; no elimina las decisiones humanas.
Costes, límites y fallos que debemos anticipar
Una configuración con varios proveedores puede facilitar cambios de modelo, pero no crea capacidad infinita. Los límites de suscripción siguen ahí; los endpoints por API pueden facturar; un servidor siempre encendido consume recursos; y algunas integraciones requieren servicios o planes adicionales.
Tampoco presumiría de ahorro de tokens por el simple hecho de usar varios agentes. Cada traspaso puede necesitar contexto duplicado. Un revisor añade consumo. Un workflow mal diseñado puede repetir el mismo trabajo cuando se reinicia o recibe dos veces el mismo webhook.
Para las primeras pruebas definiría un presupuesto y un límite de pasos. No hace falta una plataforma de observabilidad completa: bastan el número de ejecuciones, sus resultados y qué tarea humana se evitó realmente. Es un experimento de producto, no una ceremonia de dashboards.
Los casos límite merecen un apartado propio: proveedor no disponible, host reiniciado, archivo que otro agente modificó, credencial caducada, evento duplicado, aprobación denegada y respuesta sin evidencias. Para cada uno debe existir una decisión: reintentar, bloquear, pedir información, revertir o terminar con un error legible.
El criterio de éxito de un agente no es que siempre tenga respuesta; es que su estado y sus límites sean comprensibles cuando no puede continuar.
Checklist de una primera implantación sensata
Antes de considerar útil una configuración mínima de OpenBot, comprobaría estas condiciones:
- Cada agente tiene una responsabilidad concreta y un entregable verificable.
- Existe una carpeta y un brief para el trabajo persistente, sin depender de recordar toda la conversación.
- Los permisos de archivos, terminal, navegador y aplicaciones siguen el principio de mínimo privilegio.
- El canal mantiene un único propietario por tarea y el traspaso es visible.
- Las rutinas aceptan «sin novedades» y no generan trabajo por obligación.
- Los workflows reservan aprobaciones para acciones externas o irreversibles.
- Git y CI verifican cambios de código; los agentes no inventan sus resultados.
- Hay una estrategia para errores, interrupciones, duplicados, cuotas y restauración del host.
- La publicación y los secretos viven fuera del alcance del investigador o implementador.
- Puedes explicar qué hizo cada agente y conservar el artefacto aunque mañana cambies de modelo o plataforma.
No hace falta implantar todo el primer día. Empezaría por un agente y una tarea revisable, añadiría el revisor cuando hubiera una razón y automatizaría solo una secuencia que ya funciona manualmente. La progresión es más lenta que una demo, pero deja una base que puede mantenerse.
Lecciones: menos asistentes, mejores contratos
OpenBot parece especialmente pulido como espacio donde personas y agentes comparten trabajo que sigue existiendo mañana. La identidad del agente, los canales, las colas, las rutinas y los workflows aportan estructura a algo que, sin ella, serían conversaciones dispersas. Esa es su aportación principal, mucho más que la posibilidad de cambiar de Claude a Codex desde un selector.
La contrapartida es que una interfaz unificada puede ocultar diferencias importantes entre motores, niveles de acceso y ubicación de los datos. La misma tarea puede comportarse de forma distinta en dos proveedores. El almacenamiento local convive con peticiones a APIs remotas. Un «workspace» no es necesariamente un sandbox. Y tres agentes que dicen «terminado» no reemplazan un test, un diff y una verificación de despliegue.
Mi punto de partida sería un pequeño circuito de analista → implementador → revisor, con la última decisión en manos del desarrollador y la ejecución automatizada de CI donde corresponde. Añadiría una rutina cuando el circuito resuelva algo repetitivo. Después, y solo después, estudiaría eventos, servidor propio e integraciones externas.
Por cierto, si vas a usar OpenBot como parte de un proyecto comercial, recuerda que su licencia actual es PolyForm Noncommercial. Puedes leer el código y probarlo personalmente, pero un uso comercial puede requerir licencia adicional. Es una condición real que no debe desaparecer bajo la etiqueta fácil de «open source».
Bibliografía y siguientes lecturas
- OpenBot — página oficial.
- Repositorio nightly-labs/openbot, licencia y notas de versión.
- OpenBot: primer agente, persistencia y seguridad.
- OpenBot: de la tarea al resultado mediante workflows.
- OpenBot: workspace frente a historial de chat.
- Referencia de API y openbot-cli.
- Servidor propio en Ubuntu y despliegue Docker.
- Política técnica de privacidad y changelog.
- En ArceApps: OpenBot vs MausBot, OpenBot vs Hermes vs Paperclip y orquestación desde ChatGPT Desktop.
El siguiente paso no es crear otro agente
Si al terminar esta guía piensas «necesito siete asistentes más», quizá todavía no hemos encontrado el primer problema real. Elegiría una tarea que ya consume tiempo, le pondría una salida verificable y probaría una versión limitada. Cuando funcione, la repetiría. Cuando vuelva a funcionar, la convertiría en rutina o workflow.
Ese es el cambio de era que me interesa: no asistentes que hablan continuamente para demostrar que están vivos, sino asistentes que trabajan con límites claros, producen archivos y decisiones comprobables, y saben cuándo devolvernos el control.
La tecnología empieza a estar ahí. El oficio sigue estando en diseñar el proceso.
También te puede interesar

DeepSeek Harness vs OpenCode, Codex y Claude Code: cara a cara
Comparativa honesta entre DeepSeek Harness (dsh), OpenCode, Codex CLI y Claude Code. Filosofía, plugin model, sandbox, ecosistema y para quién gana cada uno en 2026.

AI CLI Grand Final: El Campeón Absoluto del Terminal en 2026
La Gran Final del torneo AI CLI 2026. Comparamos OpenCode, OpenAI Codex, Claude Code y Hermes Agent para elegir al campeón definitivo para desarrolladores indie.

El Stack de Memoria Persistente que Realmente Uso en Mis Proyectos
Deep dive técnico y honesto en el stack de memoria persistente que combino a diario en mis proyectos: opencode-supermemory para auto-compact, basic-memory como memoria principal con Markdown + grafo, y forgetful como capa de skills procedurales.