
ODD vs SDD: menos burocracia, mejores decisiones
Índice de contenidos
Este artículo continúa una conversación anterior del blog: SDD y agentes de IA, SDD + TDD y criterios de aceptación y Grill Me frente a SDD. Aquí la pregunta es diferente: ¿cómo decide un agente cuánto proceso necesita un cambio antes de empezar a programar? Al terminar encontrarás un laboratorio ODD en Android con un ejemplo ficticio y pruebas.
El coste oculto de organizar demasiado el trabajo
Hay tareas que justifican sentarse a pensar durante una tarde y otras que deberían quedar resueltas tras leer tres archivos y escribir una prueba. Si tratamos las dos igual, algo no funciona. Un cambio en el cálculo de una puntuación puede necesitar una especificación precisa porque afecta a miles de datos persistidos. Corregir una etiqueta aislada probablemente no necesita un comité de documentos, diez artefactos y una ronda de aprobación para cada paso.
En el desarrollo asistido por IA se ha popularizado una respuesta razonable: escribir especificaciones antes del código. Ese enfoque, conocido como Spec-Driven Development o SDD, evita que el agente invente requisitos, olvide restricciones y avance acumulando cambios imposibles de justificar. Lo he defendido otras veces. Pero hay una trampa: cuando un método de planificación se aplica de forma indiscriminada, acaba convirtiendo la seguridad en fricción. La documentación crece, la implementación queda al final y cada sesión parece tener que empezar de nuevo por el mismo formulario.
Organic Driven Development, ODD, propone cambiar la pregunta. En lugar de «¿qué fases tengo que completar?», pregunta «¿qué necesito saber para actuar con seguridad, cómo recuperaré el estado si interrumpo el trabajo y qué evidencia demostraría que está bien?». Esa diferencia es pequeña en una diapositiva y enorme cuando pasas el día entre un editor, Git y un agente que escribe código.
No hablo de eliminar planificación. Hablo de que una tarea bien comprendida avance rápido y de que un cambio complejo conserve una pista durable. Cuanto más caro sea equivocarse, más importante es capturar la intención, los límites y los criterios de aceptación. La proporción cambia; la responsabilidad de verificar permanece. Eso es lo que hace interesante ODD, y también lo que exige leerlo con espíritu crítico en vez de adoptarlo como una nueva religión de las siglas.
Primero, ¿de qué ODD estamos hablando?
ODD tiene varios significados en ingeniería de software. Existe Outcomes-Driven Development, existe Observability-Driven Development y hay otros usos del acrónimo. En este texto se refiere específicamente a Organic Driven Development, el protocolo promovido por el proyecto abierto Gentle-AI. Atribuirle propiedades de otras metodologías produciría una comparación engañosa.
El documento Usage de Gentle-AI describe ODD como un comportamiento por defecto del agente, no como un comando nuevo que se activa para una tarea determinada. Se conserva el recorrido esencial de explorar, implementar y comprobar, pero se adapta la cantidad de investigación, seguimiento y estructura. El código pequeño y comprendido no crea artefactos permanentes de tareas; un trabajo sustancial autorizado sí crea un documento de feature antes de tocar la implementación.
Conviene situar la fuente en el tiempo. El documento de la rama main puede incorporar cambios que todavía no estén publicados en una versión estable. La propia documentación lo advierte. Por eso separaremos lo que el repositorio declara como protocolo de aquello que hayamos observado de verdad. No he desplegado Gentle-AI ni medido productividad comparada para escribir este artículo: estamos analizando su contrato publicado y sus consecuencias prácticas, no presentando un benchmark.
SDD tampoco es una única implementación. OpenSpec, Spec Kit y distintos harnesses definen artefactos y pasos diferentes. En el ecosistema Gentle-AI se describió un flujo anterior con ocho etapas, desde explorar hasta archivar. Las guías actuales de SDD incluyen comandos adicionales de inicialización y verificación. Reducir todo SDD a «ocho pasos obligatorios» sería una caricatura. La distinción relevante no es el número exacto, sino quién decide cuándo se necesita un proceso formal y cuánta documentación queda asociada.
En ODD ese ajuste forma parte del protocolo siempre activo. En SDD una especificación es deliberadamente el centro del trabajo y, según la herramienta, sus fases se solicitan o se integran en una experiencia automatizada. En ambos casos es posible trabajar bien o mal. El nombre del método no sustituye la calidad de los requisitos ni de las pruebas.
Los siete movimientos del protocolo ODD
La documentación oficial enumera siete responsabilidades. No son siete formularios que el desarrollador tenga que rellenar. Funcionan como decisiones encadenadas que el agente debe tomar con un coste proporcional al trabajo. Entender esa sutileza impide sustituir una burocracia por otra.
1. Autorizar. La primera pregunta es si la petición permite modificar código. «Explícame por qué falla» no significa «reescribe el módulo». Una investigación, una revisión de alternativas o una propuesta pueden ser estrictamente de lectura. Esa frontera evita una de las regresiones más desagradables: que el agente convierta curiosidad en un commit inesperado.
2. Explorar. Antes de escribir, hay que mirar el código, los requisitos y el comportamiento existente. Pero explorar no significa leer todo el monorepo. El agente abre los puntos de entrada, los tests y las dependencias directamente implicadas. Si una función ya valida un dato compartido, duplicarla en otro lugar es probablemente un error, aunque el nuevo código compile.
3. Resolver incertidumbre. Se investiga una duda concreta; no se organiza un interrogatorio interminable. Si el producto no define qué hacer con una sincronización conflictiva, quizá sea necesaria una pregunta al desarrollador. Si el repositorio ya demuestra el comportamiento esperado, preguntar de nuevo solo traslada trabajo al humano. La regla de cuestionar supuestos de consecuencias importantes tiene sentido, pero no convierte cualquier decisión en una crisis arquitectónica.
4. Clasificar. Este punto es el corazón del método. Gentle-AI propone considerar pequeña una tarea cuando está comprendida, el riesgo está contenido y otra sesión podría reanudarla con la petición original y el diff de Git. Si esa recuperación ya no es fiable, hablamos de trabajo sustancial. No se decide por el número de archivos, ni por la cantidad de comandos, ni por la longitud de una checklist solicitada.
5. Registrar antes del primer cambio. Las tareas sustanciales reciben un único documento recuperable, con especificaciones, tareas y registro de decisiones y evidencia. En Gentle-AI se ubica bajo odd/tasks y puede tener un espejo en Engram, su componente de memoria. Esta persistencia sirve para continuar sin tener que reconstruir una conversación interminable. No es una licencia para grabar datos privados sin criterio.
6. Implementar tarea a tarea. Cada unidad debe tener verificaciones pertinentes y, cuando existe una prueba determinista y observable, la política descrita favorece el ciclo test-first. Los commits deben ser revisables; la cifra orientativa de unas 400 líneas modificadas se declara heurística, no un límite rígido ni una razón para trocear artificialmente una solución coherente. La evidencia importa más que marcar una casilla como hecha.
7. Cerrar. El agente comunica qué resultado verificó, qué comprobaciones fallaron o quedaron pendientes y cuál es el siguiente paso. «He terminado» sin un test ejecutado o una inspección adecuada no es cierre; es una impresión. Tampoco una lista de tareas completadas equivale a aprobar un cambio para publicarlo. El dueño del repositorio y sus reglas de entrega mantienen la última palabra.
El flujo completo puede resumirse sin perder la intención: autorización → exploración → duda relevante → clasificación → seguimiento si hace falta → implementación comprobada → cierre honesto. Su atractivo no reside en inventar nuevas técnicas de testing. Reside en hacer que esas técnicas aparezcan exactamente cuando aportan seguridad.
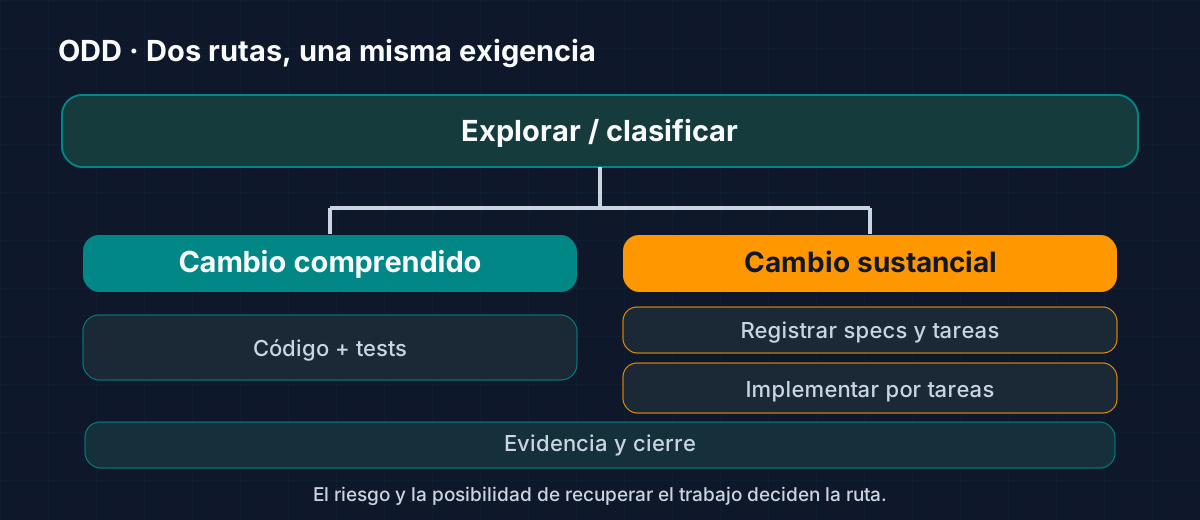
Esquema propio: ambas rutas exploran y verifican; solo el trabajo que no sería fácil recuperar crea seguimiento durable. La imagen simplifica el protocolo y no representa un experimento de rendimiento.
ODD frente a SDD: una comparación sin hombres de paja
| Aspecto | ODD en Gentle-AI | SDD en un flujo formal |
|---|---|---|
| Pregunta inicial | ¿Está autorizado y qué incertidumbre existe? | ¿Cuál es el cambio que debemos especificar? |
| Activación | Comportamiento por defecto del agente configurado | Suele ser un flujo elegido explícitamente o establecido por el proyecto |
| Artefactos pequeños | Ningún documento durable de tarea si el cambio está comprendido | Pueden existir artefactos reducidos o más formales, según el framework |
| Artefactos sustanciales | Un documento vivo de specs, tareas y registro | Propuesta, especificaciones, diseño, tareas y verificaciones, con variantes |
| Centro de gravedad | Proporcionalidad, continuidad y evidencia | Contrato explícito y trazabilidad del comportamiento |
| Decisiones humanas | Solo preguntas que realmente bloquean el producto o el riesgo | Mayor definición anticipada para fijar alcance y aceptación |
| Pruebas | Proporcionales, test-first cuando aplica y existe runner válido | Derivadas de escenarios y criterios de aceptación |
| Principal peligro | Clasificación pobre que infravalora un cambio | Ceremonia excesiva que retrasa o rigidiza el trabajo |
La comparación tiene límites. Un SDD ligero puede ser casi idéntico a un ODD bien aplicado. Un ODD configurado para un entorno de alto riesgo puede exigir tanto cuidado documental como un proyecto SDD completo. Las herramientas no garantizan el comportamiento por su etiqueta: lo hacen sus instrucciones, permisos, pruebas y controles de entrega.
También hay una diferencia de perspectiva. SDD responde especialmente bien a «¿qué significa correctamente implementado?». ODD añade explícitamente «¿cuánto proceso requiere descubrirlo y demostrarlo?». Pueden convivir: aplicar ODD por defecto y seleccionar SDD cuando la funcionalidad necesite especificaciones formales, escenarios exhaustivos o una revisión de arquitectura seria. No sería una derrota del enfoque orgánico, sino precisamente una buena clasificación.
De hecho, para algunas tareas podría ser peor obligar a ODD a decidir por sí solo toda la profundidad. Si existe regulación, una política de privacidad estricta, datos financieros o un esquema persistente crítico, prefiero restricciones del repositorio que obliguen a pruebas y revisión, independientemente de que el agente considere la tarea pequeña. La autonomía útil necesita límites previsibles.
La prueba de recuperación: una regla sorprendentemente práctica
Imagina que cierras el portátil ahora mismo. Mañana abres una sesión nueva con el mismo repositorio. ¿Podría otro agente entender lo que intentabas hacer únicamente con la petición y los cambios sin confirmar? Si la respuesta es sí y el riesgo es bajo, documentar una gran especificación quizá no aporte nada. Si la respuesta es no, necesitamos conservar intenciones, decisiones y próximos pasos fuera del chat.
Ese criterio evita confundir tamaño aparente con dificultad. Un cambio de una línea que altera cómo se firman peticiones puede tener consecuencias enormes. Una migración mecánica de nombres en treinta archivos puede ser fácil de entender, revertir y probar. El número de ficheros no captura esa diferencia. La incertidumbre, la reversibilidad, la posibilidad de interrupción y los efectos observables suelen ser mejores señales.
No convertiría la prueba de recuperación en una fórmula matemática. Es una heurística, no un detector perfecto. Un agente puede creer que el contexto es obvio y perder una restricción que el desarrollador da por supuesta. Por eso conviene añadir señales duras: cambio de contratos públicos, persistencia de datos, permisos, pagos, autenticación, migraciones irreversibles y alteraciones del proceso de publicación. Ninguna debería quedar fuera de la revisión solo por ocupar pocas líneas.
Otro detalle importante es que «documentar poco» no significa «tener poca memoria». El código, los tests y los commits pueden ser los artefactos suficientes para explicar un arreglo pequeño. Si la corrección está expresada en una prueba de regresión con un nombre legible y el commit describe la causa raíz, ya existe una pista de auditoría útil. Crear un documento adicional que repite exactamente lo mismo sería ruido.
En el extremo contrario, el registro ODD aporta valor real si necesitamos volver dentro de una semana: qué pidió la persona, qué comportamiento se acordó, qué restricciones surgieron, qué casos se probaron, qué sigue pendiente y qué commit contiene cada unidad. No se trata de conservar cada conversación; se trata de conservar conocimiento accionable y verificable.
Tres cambios ficticios para decidir el nivel de trabajo
Caso A: texto que no cabe en una pantalla pequeña
Una app Android muestra un botón cuya traducción se corta en una anchura reducida. El agente inspecciona el composable, los recursos y la prueba visual existente. No hay ambigüedad de producto ni impacto en almacenamiento. La petición autoriza corregirlo. Una modificación localizada, una comprobación de accesibilidad y una captura de la pantalla afectada podrían bastar. No necesitamos cuatro documentos para cambiar un ajuste de layout.
Pero incluso aquí habría que comprobar dos cosas. Primero, que el texto es realmente el que debería mostrarse: esconder palabras con puntos suspensivos podría empeorar el problema. Segundo, que los otros idiomas y tamaños de fuente no se rompen. Proporcionalidad no significa verificar únicamente la pantalla que tenemos delante; significa comprobar los efectos más probables.
Caso B: evitar operaciones duplicadas al reintentar
Un cliente móvil reenvía una acción cuando la conexión se interrumpe. La app necesita idempotencia para no registrar dos veces una operación. Parece una función pequeña, pero abre preguntas: ¿quién genera la clave?, ¿cuánto dura?, ¿qué significa «misma operación»?, ¿dónde se persiste?, ¿qué sucede con dos procesos? En este punto el diff por sí solo difícilmente recuperará las decisiones. El trabajo merece especificaciones y escenarios de aceptación explícitos.
Aquí conviene crear un documento de feature antes del primer cambio, aunque al final el núcleo de la implementación tenga veinte líneas. La parte difícil no es escribir esas veinte líneas. Es evitar que queden dos definiciones contradictorias de duplicado en el cliente y en el almacenamiento. Un test unitario puede comprobar la transición; una prueba de integración debe comprobar el comportamiento real con persistencia y reintentos.
Caso C: migración del almacenamiento de usuarios
Ahora imagina que cambiamos el esquema local de Room, conservando los datos de instalaciones existentes. Además del contrato funcional hay que verificar migración, compatibilidad de versiones, estado sin conexión, rollback, consumo de recursos y fallos a mitad de una operación. El agente puede usar ODD como protocolo de entrada, pero lo razonable es acudir a una especificación SDD más exhaustiva y a una batería de pruebas de migración.
Ninguna tabla de prioridades automática elimina la necesidad de una decisión humana cuando existe riesgo de pérdida irreversible. Un proceso de verificación debería medir también lo que no debe cambiar. Pasar tests del esquema nuevo en una base vacía no demuestra que la base antigua sobreviva a la actualización. Una prueba bien diseñada parte de datos anteriores reales o representativos y comprueba el resultado después de migrar.
Estos tres casos muestran por qué no basta preguntar «¿es pequeño?». Preguntaría «¿lo comprendemos?», «¿qué puede salir mal?», «¿qué información se perdería si dejamos el trabajo a medias?» y «¿qué evidencia necesitamos para confiar en el resultado?». ODD convierte esas preguntas en el ruteo natural del trabajo.
Qué debería contener el documento ODD cuando sí es necesario
La documentación de Gentle-AI propone un documento único con tres zonas: Specs, Tasks y Log. La primera captura requisitos identificados y criterios de aceptación; la segunda vincula unidades de trabajo a esos requisitos; la última conserva la petición y las correcciones con su justificación y evidencia. La idea de dar a cada tarea un identificador estable evita que el estado se reduzca a una checklist cuyo significado cambia en cada sesión.
Un ejemplo abreviado y completamente inventado sería:
# Feature: evitar duplicados en guardado local
## Specs
S1. Reintentar una solicitud con la misma clave no crea otro registro.
Aceptación: dos llamadas idénticas producen un único elemento.
S2. Una clave distinta permite una operación independiente.
Aceptación: dos claves válidas producen dos elementos.
## Tasks
T1 → S1/S2: añadir casos de regresión y adaptador de escritura.
T2 → S1/S2: probar persistencia tras reiniciar el proceso.
## Log
L1. Petición original y límites autorizados.
L2. Pruebas ejecutadas, fallos, commit y cambios de alcance.
No hay magia en la sintaxis. Lo que importa es que una nueva sesión pueda reanudar el trabajo sin confiar en un resumen de memoria ambiguo. La petición original puede contener expresiones exactas del usuario, y los requisitos deben conservar los mensajes o valores literales cuando forman parte del contrato. Si cambiamos una decisión, actualizamos la especificación afectada y reabrimos su tarea; no tiramos a la basura toda la evidencia anterior.
La integración con Engram es una capacidad del ecosistema Gentle-AI, no una condición universal para practicar esta filosofía. Si no utilizas esa herramienta, puedes conservar el mismo principio con Git y un Markdown legible. El riesgo aparece cuando empezamos a duplicar tareas entre un issue, un tablero, dos archivos, una memoria de agente y un documento de diseño sin saber cuál manda. Un solo origen claro suele ser mejor que cinco sincronizaciones frágiles.
Tampoco asumiría que cualquier agente cumple automáticamente la totalidad del protocolo solo porque haya recibido el prompt. Un contrato instruccional necesita evaluación. La propia documentación distingue el comportamiento pretendido de las garantías que ofrecen sus pruebas. Antes de depender de él en un repositorio importante, comprobaría que respeta modo lectura, que no olvida tareas pendientes y que registra evidencia verdadera.
La relación con TDD, CI y revisión independiente
ODD y TDD contestan preguntas distintas. ODD dirige el proceso; TDD guía la construcción de un comportamiento cuando existe un test determinista adecuado. El protocolo oficial de Gentle-AI contempla observar una prueba fallida antes de implementar, obtener después el resultado esperado y refactorizar manteniendo el verde. Esa secuencia es buena disciplina, pero no todas las tareas admiten un test automático útil. Una mejora de legibilidad visual sigue necesitando inspección en un dispositivo o navegador.
Los criterios de aceptación no deben confundirse con detalles internos. «Al repetir la acción no se crean duplicados» es un resultado observable. «Usar un HashSet en el ViewModel» es una solución propuesta. Si escribimos un test que solo comprueba la presencia de ese HashSet, podemos superar CI con un comportamiento roto. Prefiero probar interfaces públicas, estados y efectos persistidos, y dejar la implementación abierta mientras respete el contrato.
El papel de CI también merece matiz. Pasar build y unit tests reduce incertidumbre, pero no valida automáticamente accesibilidad, rendimiento real o publicación. Tampoco garantiza privacidad. Si el agente afirma «verificado» debe decir con qué comando, contra qué revisión y con qué resultado. Si el runner está caído o un test no se ha ejecutado, el cierre correcto incluye esa carencia, aunque el código parezca razonable.
La revisión independiente, cuando está disponible, debe recibir un candidato concreto: un commit o un pequeño tramo de PR. Revisar repetidamente la rama entera después de cada casilla completada genera fatiga y no aumenta necesariamente la detección de errores. En Gentle-AI el componente RDD de revisión se mantiene separado del protocolo ODD; uno no autoriza silenciosamente al otro. Esto importa cuando alguien interpreta ODD como permiso para fusionar por su cuenta.
Personalmente, conservaría una norma sencilla: la autonomía del agente puede llegar hasta la implementación y las comprobaciones autorizadas; la entrega debe respetar las reglas del repositorio. En un proyecto privado que publica a uno público, hay además un requisito especial: no filtrar notas, secretos o ficheros internos. La metodología de planificación no reemplaza un pipeline de publicación que aplique una lista permitida de artefactos.
Los fallos que ODD no resuelve
El primero es clasificar mal. Un cambio aparentemente pequeño puede ocultar una regla de negocio que nadie explicitó. Si el agente confunde «pocas líneas» con «poco riesgo», hará justo lo que ODD intenta evitar. La solución no es una nueva fase universal de documentación, sino señales claras de riesgo y una revisión proporcionada del código adyacente.
El segundo es memoria falsa o incompleta. Un registro persistente puede guardar una conclusión incorrecta con un tono muy convincente. Conservar la petición literal, las correcciones y la evidencia ayuda a detectarlo, pero no convierte automáticamente una conclusión en verdad. Hay que poder trazar cada afirmación crítica hasta una prueba o una fuente fiable.
El tercero es automatizar la forma y olvidar el fondo. Un agente puede crear documentos preciosos, marcar todas las tareas como realizadas y hasta generar un resumen de calidad. Nada de eso prueba el comportamiento. El cierre necesita comprobaciones observadas, y los tests requieren cobertura de aquello que realmente preocupa al usuario. El protocolo es un mecanismo de organización, no un sustituto del criterio técnico.
El cuarto es convertir flexibilidad en arbitrariedad. Dos sesiones podrían clasificar de forma opuesta una misma tarea. Para reducir esa variación, el repositorio debería declarar las normas que no admiten negociación: formatos, seguridad, compatibilidad, pruebas de migración, política de ramas, privacidad, visibilidad pública y condiciones de despliegue. ODD decide la ceremonia restante dentro de esos límites.
El quinto es perder de vista el coste humano. Cuando un agente detiene diez veces una implementación para «confirmar» decisiones que ya están en el código, no está siendo cuidadoso: está evitando hacerse cargo del análisis. ODD intenta cortar ese patrón con preguntas centradas en incertidumbres genuinas. Aun así, ningún prompt garantiza buen juicio. Conviene medir las interrupciones innecesarias y corregir instrucciones que las incentiven.
Cómo incorporaría ODD a un flujo real sin abandonar SDD
No sustituiría todas las reglas de un repositorio por un único manifiesto nuevo. Empezaría identificando lo que ya funciona: guías del proyecto, pruebas, workflows de CI, convenciones de commits, restricciones de publicación y mecanismos de revisión. Después añadiría una regla de clasificación con la prueba de recuperación y con los riesgos que fuerzan seguimiento durable. Solo entonces decidiría si hace falta una integración de memoria.
Mi contrato mínimo sería: explorar antes de modificar; distinguir lectura de escritura; reutilizar código existente; preguntar únicamente por decisiones no deducibles; documentar los cambios que no puedan recuperarse bien; probar comportamientos observables; registrar errores y límites; cerrar con evidencia. Esto cabe en un archivo de instrucciones de tamaño razonable. No exige instalar una infraestructura distinta para cada proyecto.
Mantendría SDD como herramienta disponible, especialmente cuando una funcionalidad supone decisiones nuevas de producto, un contrato externo o datos que no podemos permitirnos perder. Si la especificación resulta necesaria, la escribiría bien, con ejemplos y límites, no simplemente como un trámite para rellenar carpetas. Si no lo es, dejaría que la prueba de regresión y el commit hagan el trabajo de memoria.
Para evaluar la mejora, no miraría solo los tokens ahorrados. Contaría cuántas veces una tarea se interrumpe por una pregunta innecesaria, cuántas veces un cambio produce una regresión, cuánta información hay que repetir al retomar, cuánto esfuerzo cuesta revisar el diff y si los requisitos verificables llegan a CI. También vigilaría que el número de documentos no aumente sin que mejore la recuperación del contexto. Las comparaciones tendrían que hacerse con tareas equivalentes y un periodo suficiente, no con una demostración aislada.
Si trabajas con un agente que aún no incorpora ODD, puedes aplicar la idea manualmente. No necesitas un nuevo comando para preguntarte si una tarea está autorizada, qué debes inspeccionar, si una nueva sesión podrá reanudarla y qué evidencia te permitirá declarar el resultado correcto. La independencia respecto a una herramienta concreta es una de las razones por las que este enfoque merece atención.
Mi conclusión: menos ritual, no menos ingeniería
ODD no demuestra que las especificaciones sean un error. Señala que una única intensidad de proceso para todas las tareas lo es. SDD sigue siendo valioso cuando el coste de equivocarse es alto y los requisitos necesitan fijarse antes de escribir código. ODD permite tratar con ligereza lo que está entendido y con profundidad lo que tiene consecuencias o incertidumbres importantes.
La pregunta final que llevaría a cualquier repositorio es esta: «¿qué debo guardar y comprobar para que otro desarrollador —humano o agente— entienda y confíe en este cambio mañana?». Si la respuesta es un test y un commit, estupendo. Si requiere especificaciones, casos de migración, revisión y seguimiento, también. Lo peligroso es decidirlo a partir de una receta ciega.
En el siguiente artículo, ODD aplicado a Android, pondremos el método a trabajar con una pequeña app de hábitos ficticia. Diseñaremos tareas de distinta complejidad, un ejemplo Kotlin y pruebas que muestran qué merece seguimiento y qué no. La clave será diferenciar siempre lo que el código permite comprobar de lo que sería una ejecución real en un proyecto Android.
Bibliografía y fuentes
- Gentle-AI — repositorio oficial: contexto del ecosistema, componentes y desarrollo abierto.
- Gentle-AI — Usage / protocolo ODD: siete responsabilidades, criterio de tamaño, documentos, test-first y cierre. La rama main puede adelantarse a las versiones publicadas.
- Gentle-AI — documentación de SDD: relación entre el protocolo orgánico y el flujo SDD; comprobar versión indicada en la página.
- Android Developers — pruebas de corrutinas: referencia práctica para el laboratorio Android.
- ArceApps — SDD y aceptación: análisis anterior de los requisitos observables y TDD.
- ArceApps — SDD en profundidad: contexto de especificaciones y agentes.
ODD me interesa por una razón muy poco espectacular: quiero escribir menos papeles repetidos y conservar mejor las decisiones importantes. Si lo pruebas en tu propio flujo, me gustaría saber qué tareas te hacen dudar entre una corrección pequeña y una feature que merece su propio contrato.
También te puede interesar
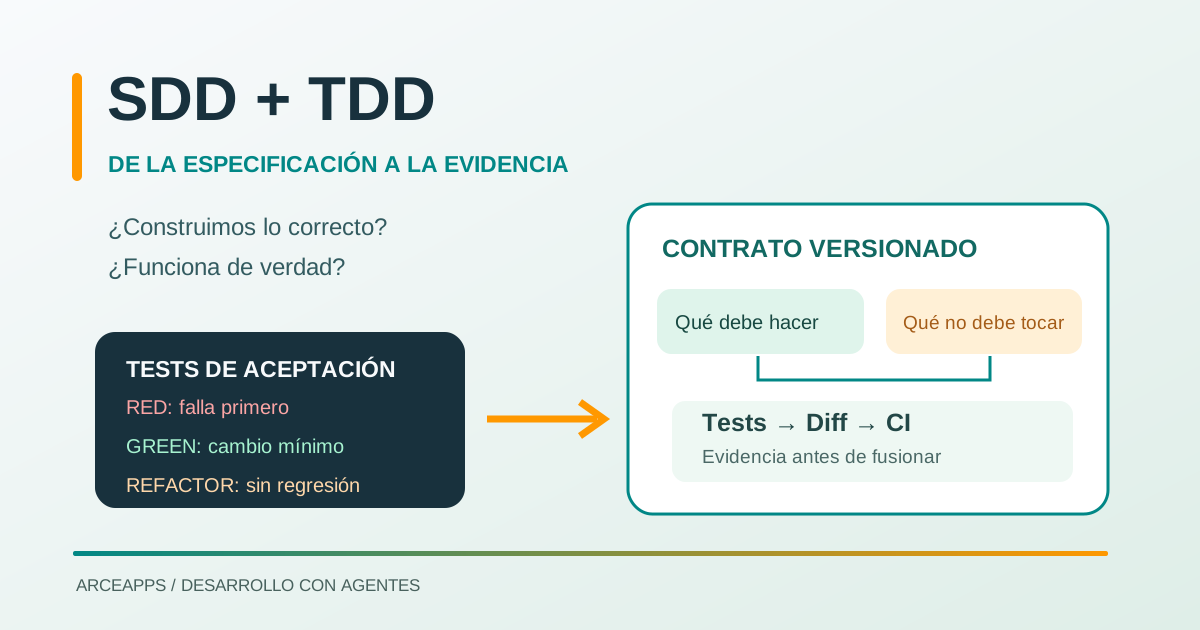
SDD + TDD: del requisito a la prueba verificable
Aprende a combinar SDD y TDD con agentes de IA: especificaciones ligeras, criterios de aceptación, pruebas Red-Green-Refactor y revisión con CI.
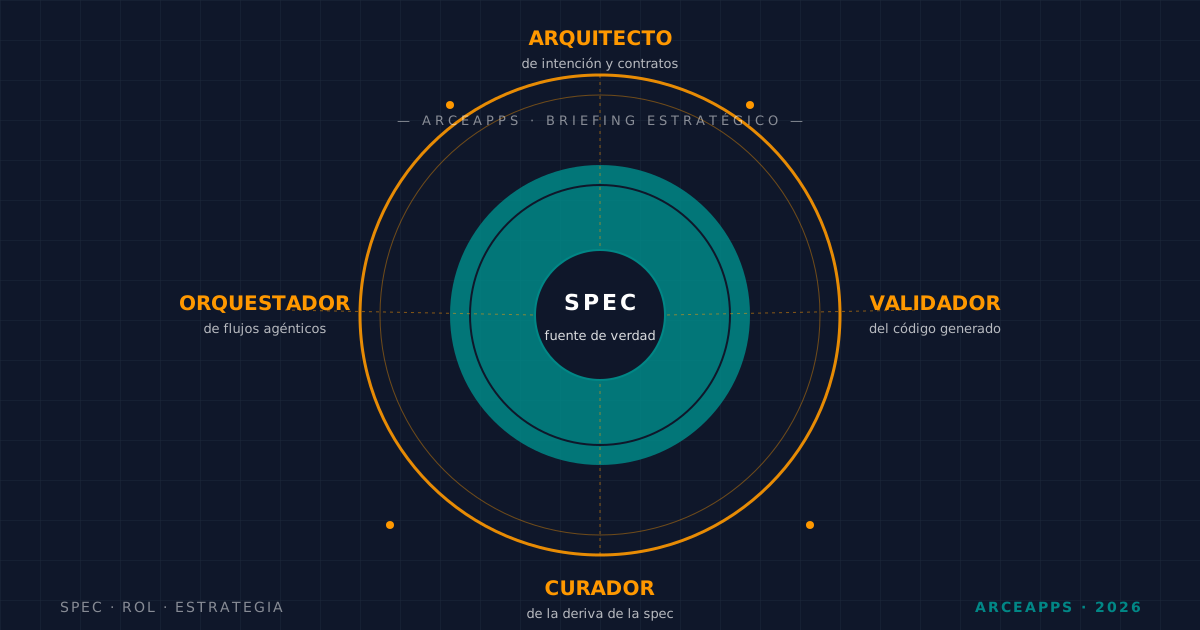
SDD: Implicaciones Estratégicas y Evolución del Rol del Desarrollador
Cómo el Spec-Driven Development convierte al desarrollador de mecanógrafo en arquitecto de la intención. Dentro del mapa de desperdicio 40-60%, los tres niveles de madurez y el salto de rol que requiere Spec-as-Source.
Agent Skills de Addy Osmani: 24 Skills para el Ciclo Completo
Tour a fondo por addyosmani/agent-skills: las 24 skills del ciclo Define→Ship, la anatomía de un SKILL.md con anti-rationalizations y red flags, el eval framework de tres niveles, y comparativa honesta con Superpowers, Spec-Kit y OpenSpec.