
DeepInfer: qué ha abierto DeepSeek y qué falta
Índice de contenidos
Abrir los pesos de un modelo y publicar el software con el que se ejecuta no son la misma cosa. Lo primero permite inspeccionar y, dentro de los límites de licencia y hardware, ejecutar un modelo. Lo segundo nos enseña cómo se resuelve una parte considerable del problema de servir ese modelo a gran escala. Por eso me parece especialmente interesante DeepInfer, el framework de inferencia que DeepSeek ha liberado como código abierto.
La descripción oficial dice que DeepInfer impulsa los servicios de producción de DeepSeek, pero hay una precisión que cambia la lectura: la publicación proporciona inferencia offline y componentes centrales para servir a escala; no incluye todo lo necesario para montar un servicio completo. Confundir ambos niveles convertiría una noticia técnica excelente en una promesa falsa para quien quiere alojar modelos en su propia máquina.
Además, DeepInfer no debe confundirse con DeepSeek Harness. Harness es una capa para agentes, herramientas y orquestación. DeepInfer es una pieza de infraestructura de inferencia: administra el cómputo necesario para generar salidas de un modelo.
Qué ha publicado realmente DeepSeek
El repositorio oficial deepseek-ai/DeepInfer está publicado bajo Apache 2.0. En el estado revisado para este artículo, declara soporte para un modelo: DeepSeek-V4.1-Flash. Sus requisitos de hardware documentados se centran en GPU NVIDIA SM100 y NPU Huawei Ascend 950. No es un runtime genérico que podamos instalar en cualquier portátil y usar con cualquier modelo.
Entre sus capacidades publicadas figuran kernels optimizados, paralelismo de atención y mezcla de expertos, mecanismos de aceleración de decodificación, planificación asíncrona, inferencia invariante respecto a los lotes, muestreo determinista y salidas estructuradas.
La lista suena abstracta si no conocemos el coste de generar cada token. Conviene descomponerla antes de hablar de rendimiento.
La inferencia tiene varias fases y cuellos de botella
Para atender una petición, un modelo autoregresivo suele procesar primero los tokens de entrada y luego generar nuevos tokens. La primera fase suele llamarse prefill; la generación posterior, decode. Las características de rendimiento son diferentes: prefill puede aprovechar paralelismo sobre muchos tokens, mientras decode produce tokens secuencialmente y depende fuertemente del movimiento de datos y de la gestión del estado.
Cuando hay varios usuarios, la planificación debe combinar solicitudes sin desperdiciar capacidad. A esto se suman memoria de activaciones, parámetros del modelo, caché KV, comunicación entre aceleradores y costes de verificación si se emplea decodificación especulativa.
No existe un único kernel mágico que resuelva todo. Un servidor de inferencia real es una combinación de cómputo, memoria, comunicación y scheduling. DeepInfer expone buena parte de esa ingeniería.
                Solicitudes
                     |
               Planificación
                     |
                 Prefill
                     |
          Atención / expertos MoE
                     |
                  Decode
             /        |        \
          draft    verificación  salida
                     |
               Nuevos tokens
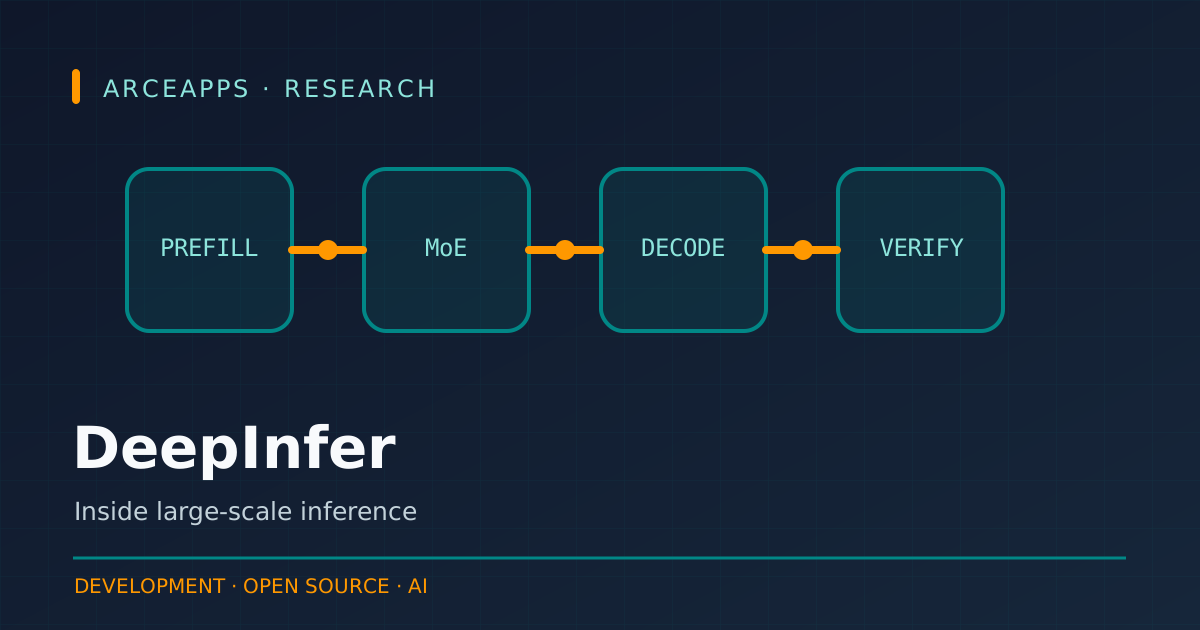
El esquema es conceptual. DeepInfer implementa componentes de estas etapas, pero no debe interpretarse como un diagrama exacto de todos sus procesos internos.
Kernels optimizados: donde importa cada microsegundo
El README menciona FlashMLA, DeepGEMM, DeepEP, TileKernels, DeepSelect y kernels personalizados con TileLang. Son nombres distintos para optimizaciones que atacan partes diferentes del cálculo y la comunicación.
En modelos muy grandes, el rendimiento no depende solo de tener aceleradores rápidos; depende de mantenerlos ocupados y evitar que las transferencias de memoria o la coordinación entre dispositivos dominen la ejecución. Optimizar matrices, atención y comunicación puede cambiar radicalmente el aprovechamiento del hardware.
La consecuencia interesante para desarrolladores es que la eficiencia del modelo no se mide únicamente en parámetros o calidad lingüística. Dos sistemas que ejecutan el mismo modelo pueden ofrecer latencias y costes muy diferentes debido a la implementación de inferencia.
Eso sí: sin reproducir los benchmarks con la misma topología y el mismo modelo, no tiene sentido convertir un número comercial en una comparación general entre DeepInfer, vLLM, SGLang o TensorRT-LLM.
Paralelismo y modelos de mezcla de expertos
El framework documenta Attention DP / balanced CP y MoE EP + EPLB. El primero alude a mecanismos de paralelización de atención; el segundo a distribuir expertos de una arquitectura Mixture of Experts, con equilibrio de carga entre expertos.
En un MoE, una entrada no necesariamente utiliza todos los expertos de la misma manera. La distribución de rutas puede generar desequilibrios: algunos dispositivos procesan más trabajo y otros esperan. EPLB ayuda a abordar esa asimetría.
Imaginemos un pequeño taller con varias máquinas: no basta con tener ocho máquinas si seis permanecen inactivas mientras dos acumulan trabajo. La analogía simplifica mucho el comportamiento del MoE, pero ilustra por qué la planificación y el reparto importan tanto como la potencia teórica.
Esta infraestructura no está pensada para la típica app Android que hace una única petición ocasional. Su valor aparece cuando la escala y la arquitectura del modelo justifican coordinación compleja entre aceleradores.
DSpark: proponer tokens y decidir cuándo verificarlos
DeepInfer incorpora DSpark y verificación programada por confianza. La idea general de la decodificación especulativa es producir candidatos de tokens y verificar su validez con mecanismos del modelo, para reducir trabajo secuencial cuando resulte rentable.
El README describe un parámetro para activar el modo y otro para controlar la longitud máxima del borrador. No reproduciría esos flags sin revisar el código y el modelo compatible: una configuración de inferencia avanzada puede ser válida para una arquitectura concreta y perjudicial para otra.
El concepto que importa es que generar borradores no significa aceptar respuestas sin comprobación. La verificación forma parte del mecanismo. Si el coste de verificar supera el ahorro, el beneficio desaparece.
Además, una mayor tasa de aceptación de borradores no implica necesariamente una mejor respuesta al usuario. El objetivo del mecanismo es acelerar la generación manteniendo su semántica bajo las condiciones documentadas.
SWA con replay acotado
Otra capacidad publicada es SWA bounded replay: optimizar el trabajo de prefill del decodificador reejecutando únicamente un sufijo acotado cuando esa estrategia es válida. El README define valores por defecto vinculados a V4.1 y advierte que el tramo retenido debe cubrir la ventana de atención más el posible retroceso.
Aquí hay una lección general: cuando una arquitectura proporciona límites conocidos de dependencia, el runtime puede evitar recomputar información que ya no necesita. Pero esa decisión exige respetar exactamente las invariantes del modelo.
No lo reduciría a «cortar contexto para ir más rápido». Truncar indiscriminadamente tokens puede cambiar una respuesta. Un replay acotado correcto utiliza propiedades concretas del mecanismo de atención, no una intuición sobre qué parte de la conversación parece importante.
Batches, determinismo y reproducibilidad
Dos funciones merecen atención fuera de las grandes cifras de rendimiento. Batch-invariant inference intenta que los resultados sean idénticos aunque una misma petición se procese junto con solicitudes diferentes. Deterministic sampling proporciona reproducibilidad con los parámetros y semillas adecuados.
En un servicio compartido, la composición del lote cambia dinámicamente. Si altera sutilmente los resultados numéricos, reproducir un fallo puede volverse complicado. La invariancia de lote facilita comparar ejecuciones, depurar resultados y establecer pruebas controladas.
El README indica que estas opciones están disponibles solo para NVIDIA en el estado descrito. También señala que para el muestreo determinista hay que desactivar un modo concreto de DSpark y pasar una semilla fija. Por tanto, no podemos prometer determinismo en cualquier combinación de hardware y configuración.
Reproducibilidad tampoco implica corrección. Una respuesta incorrecta que se repite siempre sigue siendo incorrecta; al menos resulta más fácil estudiarla.
Salidas estructuradas y aplicaciones reales
DeepInfer documenta structured outputs con restricciones basadas en expresiones regulares, esquemas JSON o gramáticas EBNF. Para una aplicación, esta capacidad es importante porque evita tener que confiar únicamente en que el modelo siga por cortesía un formato de respuesta.
Pensemos en una herramienta que extrae datos de un documento. Si espera un objeto con campos conocidos, validar o restringir la forma de salida puede reducir errores de integración. Pero hay dos capas distintas: que el JSON tenga la forma esperada y que sus valores sean verdaderos.
Un esquema correcto no impide que el modelo invente un precio o confunda una fecha. Por eso seguiría validando reglas de dominio y comprobando fuentes antes de escribir esos datos en una base de datos real.
La pieza ausente: el sistema de KV cache
Aquí llega el detalle más relevante para el autoalojamiento. El README enumera explícitamente lo necesario para un servicio completo que no se incluye en la publicación:
- un sistema de KV cache;
- la desagregación entre entornos de prefill y decode, aunque gran parte de las funciones del motor ya está implementada;
- equilibrado de carga entre réplicas paralelas tanto de prefill como de decode.
La caché KV guarda información intermedia que evita recalcular toda la atención en cada token generado. Administrarla para muchos usuarios, con diferentes longitudes de contexto y ciclos de vida, es uno de los problemas centrales de servir LLM a gran escala.
Por tanto, llamar DeepInfer «el stack completo de producción de DeepSeek listo para desplegar» sería incorrecto. DeepSeek libera piezas importantes de su motor, pero el README reconoce con claridad lo que falta.
Esta honestidad técnica del propio proyecto merece destacarse más que cualquier cifra llamativa de un hilo de Hacker News.
Requisitos: no es un instalador para el mini PC de casa
La documentación exige Linux, Python 3.12, GCC 13 o superior y, según acelerador, CUDA 13 o CANN 9.2. Los dispositivos soportados son NVIDIA SM100 o Huawei Ascend 950.
El flujo de compilación documentado comienza así:
export DEEPINFER_ACCELERATOR=nvidia
./build.sh
python examples/offline_inference.py
Estas órdenes presuponen haber preparado previamente el entorno Python 3.12 y disponer del hardware y software requeridos. Son una referencia de la documentación oficial, no una instalación que haya realizado. El ejemplo descarga por defecto el checkpoint DeepSeek-V4.1-Flash-1017 desde Hugging Face si no se configura una ruta local.
Para un portátil convencional o un mini PC sin esos aceleradores, la conclusión práctica es sencilla: DeepInfer no es actualmente la solución directa para ejecutar pequeños modelos locales. No conviene confundir la liberación del framework con un soporte universal de GPU.
Cómo interpretaría sus benchmarks
El repositorio aporta benchmarks de rendimiento de prefill y decode con una configuración de 4 GPU SM100 para prefill y 64 para decode, cada grupo dentro de un dominio de escalado. Su guía indica cómo reproducir mediciones.
Ese escenario se parece muy poco a una máquina doméstica. Aun si los resultados son excelentes para su objetivo, extrapolarlos a una RTX de consumo sería metodológicamente incorrecto. Hay que comparar el mismo modelo, precisión, longitud de contexto, tamaño de lote y costes de comunicación.
También separaría los objetivos: máxima utilización de aceleradores, mínima latencia de una petición y coste por millón de tokens son indicadores relacionados, pero no idénticos.
DeepInfer frente a vLLM y SGLang
DeepSeek reconoce que DeepInfer se construyó originalmente sobre todo a partir de vLLM, con inspiración adicional en SGLang y TensorRT-LLM. No estamos ante un proyecto surgido en completo aislamiento.
Para un desarrollador que quiera servir otros modelos o trabajar con hardware más común, seguiría empezando por comparar los runtimes que soporten exactamente su arquitectura y dispositivo. DeepInfer aporta una ventana magnífica a optimizaciones de DeepSeek, pero actualmente está más especializado.
La comparación justa exige evaluar soporte de modelos, compatibilidad de hardware, gestión de KV cache, APIs de serving, mantenimiento, rendimiento por carga y facilidad de operaciones. No basta con contar estrellas de GitHub.
Qué aporta aunque nunca lo instalemos
El principal valor puede ser educativo y arquitectónico. Podemos estudiar cómo se acoplan kernels, planificación y paralelismo; cómo se preserva determinismo bajo batching; qué se necesita para mantener eficiente un MoE; y por qué falta una pieza tan sustancial como la caché KV.
También es una señal interesante de apertura: publicar código de un sistema real permite discutir sus decisiones y límites con más precisión que una presentación de marketing. Eso no obliga a adoptar esa arquitectura, pero mejora la conversación técnica.
La gran pregunta no es si DeepInfer debe estar dentro de nuestra app indie. Es si las ideas que demuestra pueden inspirar infraestructuras de inferencia más eficientes y accesibles en el futuro.
Por qué un runtime de inferencia se parece a un sistema operativo especializado
Al observar una API de generación de texto parece que la operación consiste en enviar un prompt y recibir tokens. A escala, la infraestructura debe decidir qué solicitud entra, dónde se ejecuta cada fase, cuánto estado conserva y cómo reparte recursos cuando aparecen nuevas peticiones.
Hay responsabilidades que recuerdan a un sistema operativo: planificar trabajo concurrente, administrar memoria escasa, asignar tareas a unidades de cómputo y controlar efectos de la ejecución. La analogía tiene límites, pero ayuda a entender por qué un framework de inferencia acaba incorporando tantas piezas distintas.
DeepInfer pone el foco en la eficiencia del modelo soportado. No pretende ser una base de datos, un gestor de usuarios ni una plataforma completa de APIs. Al evaluar cualquier solución de self-hosting es útil separar al menos tres capas: motor de inferencia, servicio que atiende solicitudes y operación de la plataforma. La última incluye observabilidad, autenticación, límites de uso, recuperación ante fallos y facturación si corresponde.
La presencia de un runtime avanzado no significa que las otras capas existan. Tampoco garantiza que podamos modificar la topología sin entender sus requisitos. Esta separación evita atribuir al código de DeepInfer responsabilidades que la propia release excluye.
La caché KV como problema de recursos compartidos
La caché KV merece una explicación más concreta porque suele ser la diferencia entre una demo aislada y un servicio viable. Cada generación conserva estados derivados de tokens previos. Si tenemos una sola solicitud, la gestión puede parecer sencilla. Con cientos de sesiones concurrentes, las longitudes de contexto crecen de forma desigual.
Imaginemos diez usuarios. Uno envía cien tokens; otro envía veinte mil; un tercero solicita una respuesta larga mientras los demás terminan pronto. La memoria disponible no se distribuye de manera uniforme, y el sistema debe decidir qué entradas puede mantener, cuándo liberar bloques y cómo evitar que una sesión larga perjudique al resto.
Esa administración afecta a latencia y throughput. Una buena política puede reducir recomputación y aprovechar mejor la memoria; una mala puede provocar desperdicio, presión de memoria y cambios bruscos de rendimiento. No se trata únicamente de almacenar un array de claves y valores.
Por eso es tan significativa la lista oficial de elementos ausentes. DeepInfer ofrece componentes importantes del motor de cálculo, pero un sistema de caché KV para serving es una responsabilidad de infraestructura de primer orden. Ignorarla produciría una arquitectura incompleta.
El coste de comunicarse entre aceleradores
El paralelismo es útil mientras el trabajo adicional que genera no anula el beneficio. Repartir un modelo entre dispositivos puede aumentar capacidad, pero obliga a mover información y sincronizar fases. En determinadas topologías, la comunicación se convierte en un cuello de botella.
Esta es una razón para no interpretar una cifra de rendimiento sin su topología física. Cuatro GPU dentro de un dominio de escalado y cuatro dispositivos conectados por una red distinta no ofrecen necesariamente el mismo comportamiento. La latencia de interconexión, el ancho de banda y el patrón de comunicación importan.
Con los modelos MoE, además, la decisión de qué experto procesa cada token influye en qué dispositivos reciben trabajo. No basta con distribuir pesos de forma uniforme. Si las rutas reales no reparten la carga, un acelerador puede convertirse en el punto de espera de todos los demás.
DeepInfer documenta precisamente mecanismos para coordinar estos aspectos. El aprendizaje que extraigo no es que exista un modo universalmente mejor de paralelización, sino que las decisiones del runtime deben medirse junto con la arquitectura del modelo y del hardware.
Determinismo: esencial para evaluar, no solo para depurar
La generación determinista suele aparecer como una funcionalidad de comodidad, pero también es una herramienta metodológica. Si queremos comparar dos kernels o dos estrategias de planificación, necesitamos saber si una diferencia en el resultado proviene del cambio técnico o de otra fuente de variación.
Una semilla fija ayuda, aunque no siempre basta si el procesamiento de lotes y los algoritmos numéricos introducen diferencias dependientes del orden de ejecución. Por eso la combinación documentada de batch-invariant inference y sampling determinista resulta conceptualmente interesante.
Un sistema que reproduce resultados bajo condiciones conocidas facilita pruebas de regresión, análisis de incidentes y comparación de optimizaciones. Hay que documentar, sin embargo, qué condiciones se fijaron: modelo, pesos, hardware, versión, semilla, parámetros y organización de los lotes.
Fuera de ese conjunto, afirmar «siempre devuelve exactamente lo mismo» sería excesivo. La reproducibilidad es una propiedad del experimento completo, no de un parámetro aislado.
Qué preguntaría antes de elegir un motor para una app propia
Mi lista de evaluación no empezaría por los tokens por segundo de una gráfica promocional. Empezaría por el modelo que realmente necesito y por el hardware disponible. Después comprobaría licencia, memoria requerida, precisión soportada, formatos de entrada y salida, herramientas de operación y comportamiento bajo concurrencia real.
También haría pruebas de carga pequeñas y reproducibles. Una app con un usuario concurrente tiene necesidades distintas de un servicio con miles de sesiones. En el primer caso, probablemente valoraría una instalación sencilla y buena latencia; en el segundo, la utilización eficiente de aceleradores y la planificación se vuelven centrales.
Por último, prestaría atención a mantenimiento y actualizaciones. Un runtime especializado puede ser una elección excelente si se utiliza exactamente el modelo para el que está optimizado. Puede ser poco adecuado si quiero probar diez modelos distintos cada semana.
Esta es la razón por la que me gusta leer releases como DeepInfer sin convertirlas inmediatamente en una recomendación de instalación. Conocer los límites de una herramienta es parte de saber utilizarla.
Qué no podemos deducir del anuncio
No podemos concluir que cualquier usuario vaya a obtener la misma eficiencia económica que DeepSeek. Tampoco que el framework reproduzca todo el servicio desplegado por la organización, ni que sus optimizaciones sean trasladables sin cambios a cualquier arquitectura.
Los números difundidos por comentaristas de Hacker News sobre volumen de tokens o coste de tarjetas no aparecen verificados en la documentación oficial del proyecto. Los trataría como comentarios de terceros, no como hechos que deban sustentar decisiones técnicas.
Tampoco debemos interpretar una licencia abierta como promesa de soporte comercial o de compatibilidad futura. Apache 2.0 permite estudiar y reutilizar el código dentro de sus condiciones; no obliga al mantenedor a adaptarlo a nuestros dispositivos o a resolver nuestras incidencias.
Lo valioso de esta apertura es que podemos formular preguntas mejores. ¿Qué capa se ha publicado? ¿Qué restricciones documenta? ¿Qué benchmark puede reproducirse? ¿Qué capacidad falta para convertir la demostración en un sistema utilizable? Esas preguntas seguirán siendo relevantes aunque cambien los modelos.
Conclusión
DeepInfer es importante por lo que revela del trabajo que hay debajo de una API de modelos. Optimizar generación a gran escala implica kernels, scheduling, memoria, comunicación, paralelismo y reproducibilidad. El release abre una parte sustancial de ese sistema, con limitaciones explícitas.
No lo vendería como un servidor de producción completo ni como el runtime ideal para cualquier equipo local. Lo leería como una contribución técnica especializada, especialmente valiosa para estudiar cómo se sirve un modelo complejo a gran escala.
Referencias
- DeepInfer — repositorio y documentación oficial.
- DeepInfer — instrucciones de evaluación.
- DeepSeek Harness: el runtime donde todo es un plugin.
- DeepSeek Harness Desktop: análisis.
A veces lo más revelador de una release abierta no es solo lo que incluye, sino la lista exacta de las piezas que todavía no permite reproducir.
También te puede interesar

DeepSeek Harness Desktop: análisis de su app
Descubre DeepSeek Harness Desktop: instalación, plugins, automatización, seguridad y límites reales de su nueva aplicación para agentes de IA.
DeepSeek Harness: el runtime donde todo es un plugin
DeepSeek Harness (dsh) es un runtime open-source MIT donde modelo, herramientas, sesión, sandbox e incluso el loop son plugins. Análisis en profundidad: Cordis, modos, sesión append-only y self-evolution.
DeepSeek R1: El Modelo Open Source que Desafía a los Gigantes
DeepSeek ha lanzado R1, un modelo de razonamiento open source que compite de tú a tú con o1 de OpenAI. Analizamos su arquitectura, rendimiento en código y por qué es un terremoto para la industria.