
Claude Duet, ChatGPT Dots y Gemini Agent: Comparativa
Índice de contenidos
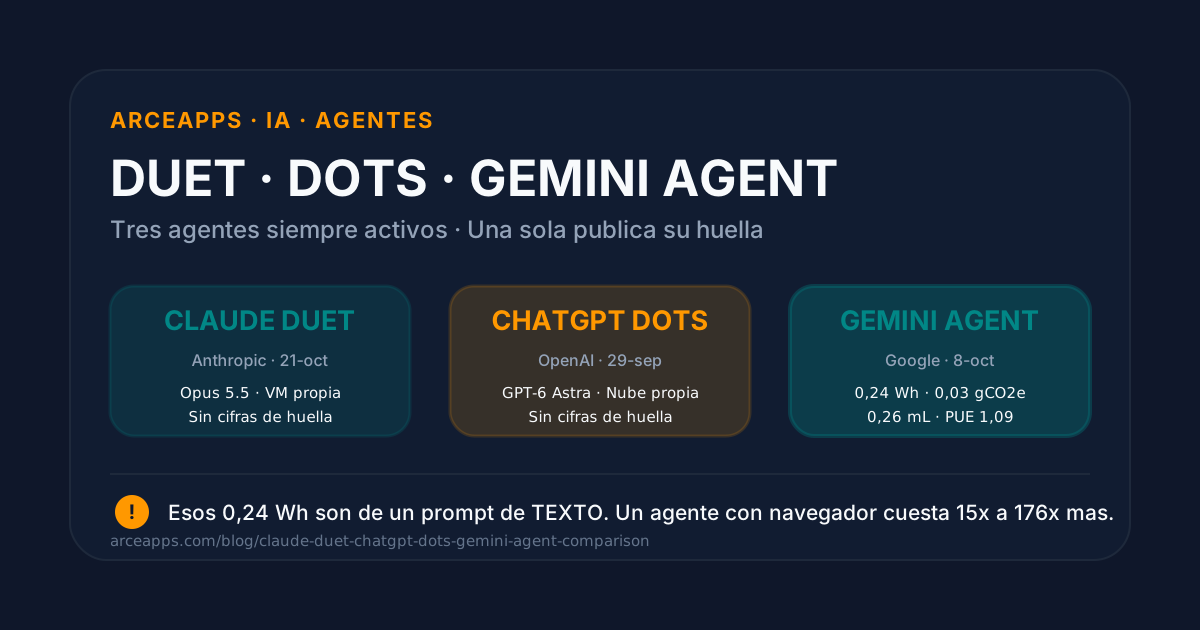
Tres lanzamientos en veintitrés días. El 29 de septiembre OpenAI saca Dots en el DevDay de San Francisco; el 8 de octubre Google presenta el Gemini agent en Gemini at Work; el 21 de octubre Anthropic anuncia Claude Duet. Tres meses de trabajo interno condensados en tres semanas de anuncios, y una sensación incómoda: no son tres productos distintos, son el mismo producto vendido por tres empresas.
Un agente que tiene su propia máquina en la nube, su propio navegador, tus credenciales y permiso para actuar mientras tú duermes. La diferencia ya no está en la arquitectura — los tres han convergido en ella —, sino en quién lo ha abierto primero, a qué precio, en qué países y, sobre todo, en qué nos están contando de lo que cuesta mantenerlo encendido.
Y aquí está la paradoja que me hizo escribir este post: Google es el único de los tres que publica cifras de huella energética medibles, y esas cifras no describen lo que estamos comparando. En agosto de 2025 Google publicó que un prompt de texto mediano en Gemini Apps consume 0,24 Wh, emite 0,03 gCO2e y gasta 0,26 mL de agua. Es un dato precioso, con metodología completa, con sus propios límites escritos a mano. Y es, literalmente, un prompt de texto. No es un Duet, no es un Dot, no es el Gemini agent. No es un navegador abierto durante seis horas.
Antes de entrar, dos disclaimers. El primero: trabajo con agentes a diario y esto es el terreno que más me interesa del sector ahora mismo, así que mi sesgo va a ser de desarrollo — no me interesan los demos, me interesan los límites, los costes ocultos y lo que el fabricante decide contarte y lo que decide callarse. El segundo: cada cifra que aparece aquí lleva su fuente y, cuando procede, su nivel. Cuando digo «según TechCrunch» o «los agregadores reportan», es porque eso es lo que es: prensa o de segunda fuente, no el documento original. Para el que quiera el marco teórico de por qué un agente que trabaja de forma distinta a un chat, remito a Agentes IA Autónomos en Android y a Más allá del Chat: por qué necesitas agentes en tu equipo; para el diseño de bucles que sostienen todo esto, a AI Agent Goal Loops.
Contexto: qué es un agente “siempre activo” y por qué octubre de 2026 es el mes en que todo el mundo lo ha lanzado
La diferencia entre un chatbot y un agente «siempre activo» no es de matiz, es de categoría. Si quieres el mapa del panorama de modelos de 2026 antes de entrar, lo tienes en ChatGPT, Claude y Gemini en 2026. En un chat, el hilo muere cuando tú dejas de escribir. La máquina está ahí esperando, sin coste, sin consumo, sin cola de trabajo pendiente. En un agente siempre activo, el hilo sobrevive a tu silencio: sigue despertando cada pocas horas, sigue leyendo tus cuentas, sigue abriendo pestañas, sigue encadenando llamadas a herramientas, y todo eso ocurre en una máquina virtual que alguien —tú, en forma de suscripción— mantiene pagada mientras duermes.
Eso introduce tres costes que un chat nunca tuvo:
Capacidad reservada. Una VM con navegador abierto no es una petición que se apaga al terminar. Es una máquina provisionada, con su CPU, su RAM y su sesión de navegador persistentes, entre pasos. Cuando el agente “descansa” cinco minutos entre dos comprobaciones, esa capacidad sigue reservada. Y esa es exactamente la partida que Google sí mide — y que dice que es el 10% de la energía de un prompt de texto.
Ciclos de razonamiento encadenados. Un prompt de texto es un viaje de ida y vuelta. Un agente es una cadena: planifica, llama a una herramienta, lee el resultado, vuelve a decidir, llama a otra herramienta, quizá abre un navegador, quizá espera. Cada eslabón multiplica tokens generados, y los tokens generados son, en el modelo energético de cualquier centro de datos, el término dominante.
Decisiones Periodicas. El agente no solo ejecuta lo que le pediste: decide. Qué merece atención, cuándo actuar, cuándo callarse. Esa decisión se toma con un modelo, no con una regla. Y las decisiones periódicas son precisamente las que consumen cuota, factura y energía sin que el usuario haya pedido nada en ese instante.
Hasta ahora, esto era un lujo de laboratorio. En 2025 los “agentes” eran cosas que tú disparabas: le dabas una tarea, ejecutaba, devolvía resultado. Eran bajo demanda. A partir de septiembre de 2026 dejó de ser así: Dots, Gemini agent y Claude Duet son, en el sentido literal de sus documentos oficiales, agentes que “siguen avanzando entre conversaciones” (OpenAI), que “siguen corriendo después de que cierres el portátil” (Google) y que “vienen a por ti” en vez de esperar a que abras un chat (Anthropic).
Y hay una razón de calendario que no es casualidad. Los tres comparten la misma línea de producto porque los tres llegaron a la misma conclusión de mercado: el chat se está comoditizando. Todos los asistentes hacen más o menos lo mismo a partir del mismo prompt. La siguiente capa de valor no es “responder mejor” sino “hacer algo por mi cuenta mientras yo no estoy”. El chat fue la UX de 2023–2025; el agente persistente es la UX que las tres empresas quieren para 2027.
Lo interesante para un desarrollador independiente es que, por fin, hay algo que comparar. Hasta ahora comparaba chatbots; ahora comparamos agentes que hacen cosas distintas con límites distintos. Y lo que emerge al comparar con cuidado no es un ganador, sino un mapa de compromisos muy distintos entre las tres compañías. Cada una ha optimizado una variable y ha sacrificado otra:
- Anthropic ha priorizado la prudencia de permisos y la contención del alcance.
- OpenAI ha priorizado la transparencia operativa (puedes abrir su ordenador y mirarlo) y la transparencia de cuota (tu conversación con el Dot no gasta tus límites).
- Google ha priorizado la transparencia energética (el único que publica Wh, gCO2e y mL) y la flexibilidad de modelo.
Y la ironía final: la variable que más pesa a la semana es precisamente la que casi nadie mide.
Claude Duet: el agente que llega a por ti (Anthropic)
Duet es, de los tres, el que más se parece a la idea original de “asistente que te busca”. La formulación de Anthropic en su página de producto es casi poética en su contraste: la app de Claude espera a que abras un chat; Claude Duet viene a por ti.
La arquitectura es notable por una cosa: Duet no necesita tu portátil ni tu teléfono encendido. Corre en una máquina virtual en la nube con su propio navegador. Cuando cierras la app, el trabajo continúa. Eso resuelve el problema que más restringen —con restricciones— los agentes de escritorio, y lo hace, además, sin exigirte un servidor en casa.
El modelo está confirmado oficialmente, no es rumor: Claude Opus 5.5. Aparece dicho en tres sitios de Anthropic —el anuncio, la página de producto y el centro de ayuda— y no hay opción de elegir otro. El centro de ayuda lo dice con una frase que revela bastante: «Duet decide cuánto esfuerzo necesita cada trabajo». Es decir, la política de gasto de cómputo es interna y opaca; tú no la ves ni la ajustas.
El acceso es, ahora mismo, lo más restrictivo de los tres: es una research preview con lista de espera, y para entrar hacen falta las tres cosas a la vez: plan Pro o Max, cuenta registrada en Estados Unidos e invitación. Team y Enterprise no entran todavía, y las invitaciones se mandan por oleadas, así que Anthropic avisa sin rodeos de que unirse “no garantiza una fecha”. No hay app de escritorio. Hay apps iOS y Android independientes más la web en claude.ai.
Lo que Anthropic hace bien es decir en público lo que no hace bien. Y aquí es donde Duet se separa del discurso habitual de lanzamiento:
- No puedes ver su navegador. No hay modo de observar qué está haciendo ni de tomar el control. Es una decisión de diseño explícita, y es una de las razones por las que “siempre activo” y “confiable” tiran en direcciones opuestas.
- No comprueba tus cuentas de forma continua. Las revisa “cada pocas horas”, y la razón que da Anthropic es de cuota, no de diseño: comprobar sin parar “usaría los límites de tu plan mucho más rápido”. El propio centro de ayuda reconoce la consecuencia: algo urgente puede llegar entre comprobación y comprobación.
- No puede elegir modelo, ni ver todos tus proyectos ni tus archivos locales, ni modificar trabajo que tengas abierto en Claude.
- No hace llamadas ni mensajes a terceros. Los correos sí, con aprobación.
- Microsoft 365 todavía no está disponible, y algunos conectores (Slack es el ejemplo que citan) están limitados.
- Y, con una honestidad casi sorprendente: Anthropic admite que puede malinterpretar un hilo de correo o calibrar mal la urgencia, y que en encargos personales —reservar entradas, por ejemplo— no es “tan fuerte”.
El modelo de permisos, que es el producto de verdad
Antes de enviar un mensaje, hacer un pago, firmar un documento o borrar algo, Duet te enseña la acción, el destino y el contenido completo, incluidos todos los destinatarios, y espera. Ese detalle —mostrar los destinatarios uno a uno— es más de lo que veo en la mayoría de herramientas de automatización, y es la diferencia entre “el agente hizo algo” y “el agente hizo algo que yo podía haber detectado”.
Hay tres capas de protección encima:
- Un clasificador de auto-modo que corre fuera del modelo que trabaja. Es la pieza más interesante desde el punto de vista de seguridad: si las instrucciones ocultas viven en una página web, el modelo que está haciendo el trabajo no es quien decide. Es otro. Anthropic lo describe así en su post de seguridad: el clasificador “se ejecuta fuera del modelo que hace el trabajo, de modo que las instrucciones ocultas en una página no puedan afectar al resultado”.
- Un clasificador nuevo de información sensible, en dos niveles, con su propio system prompt de seguridad, separado del modelo principal, y que se aplica tanto a mensajes como a archivos subidos a través del navegador. El nivel «never share» cubre credenciales de acceso, números completos de tarjeta y cuenta bancaria y números de documento de identidad oficial. El nivel «necesita consentimiento» cubre salud y finanzas personales.
- Un suelo que no se puede desactivar. Pagar o enviar dinero, borrar un pedido y crear una cuenta nunca quedan cubiertos por un “no volver a preguntar”. Además, tres acciones están prohibidas aunque des la aprobación: operar con valores, mover dinero entre cuentas y acceder a la cuenta de otra persona.
La compra se aísla con Stripe Link, que emite una tarjeta virtual de un solo uso limitada a ese comercio y ese importe: tu número real de tarjeta nunca se lo enseña ni a Duet ni al comerciante. Y las contraseñas se cifran con una clave de un solo uso que solo existe en la máquina del navegador y se pasan al navegador sin abrirse; el modelo ni las ve ni las guarda. Los tokens de inicio de sesión se inyectan desde fuera de la máquina del agente mediante un proxy. La arquitectura de tres zonas —modelo, ordenador en la nube del agente y VM de navegador dedicada— está bien pensada y bien explicada.
Anthropic también reconoce el problema que más me preocupa de este tipo de sistemas: la fatiga de aprobaciones. Su propio texto dice que la calibración todavía se está ajustando. Y es un problema estructural: un agente que consulta cada pocas horas y te pide permiso para todo se convierte en una bandeja de notificaciones que aprendes a ignorar. Un agente que no te pide permiso para nada es un agente en el que no puedes confiar. El equilibrio es estrecho y todavía no está estabilizado.
La cifra que no cuadra
El anuncio de Duet dice que puede usar “más de 6.000 conectores y plugins” en el Claude Marketplace. El directorio en vivo, consultado el 26 de octubre, marcaba 1.011 conectores y 550 plugins, es decir, 1.561 en total. Y el propio anuncio de lanzamiento del Marketplace, del 23 de septiembre, decía “más de 2.000”. Tres números del mismo fabricante en el mismo mes, ninguno reconciliable desde fuentes públicas.
El dato no es menor por el tamaño del número, sino por lo que revela: Anthropic no explica cómo cuenta. ¿Incluye servidores MCP? ¿Plugins y conectores por separado? ¿Duplicados? No lo dice. Y el 6.000 se repitió sin verificación en TechCrunch y en el New York Times.
Esto no invalida a Duet. Un directorio de 1.561 integraciones es un directorio enorme y probablemente suficiente. Lo que invalida es que la cifra que se repite en la prensa no es la que se puede comprobar. Cuando uso integraciones para mover mi producto, cuento conectores; no cuento afirmaciones de marketing.
ChatGPT Dots: el agente que vive en tu ChatGPT (OpenAI)
Dots es el más radical en una cosa: no es un producto separado, es una cuarta categoría dentro de ChatGPT. La diferencia de fondo con las otras dos es que OpenAI no compite por el sitio del «asistente que trabaja solo», sino por integrarse en el producto que la gente ya tiene abierto ocho horas al día. Lo que OpenAI vendió en San Francisco, el 29 de septiembre, en el DevDay 2026, fue un conjunto de agentes persistentes que viven dentro de ChatGPT: un “Dot” es un agente que sigue trabajando entre conversaciones, con su propio ordenador en la nube —Linux con un Chrome real, aislado por usuario—, el grafo de plugins de tu cuenta y, si quieres, acceso a tu ordenador personal.
La definición técnica que mejor resume la diferencia con el resto de ChatGPT la da la propia documentación de OpenAI al separar cuatro cosas:
- Chat: “asistencia conversacional rápida y preguntas del día a día”.
- Work: “un agente diseñado para trabajo más largo, de varios pasos y entregables terminados”.
- Codex: “dedicado al desarrollo de software y al trabajo técnico”.
- Dot: una cuarta categoría que es dueño de una responsabilidad continuada.
Esa última frase es la que importa. Un Dot no responde: sostiene. Mantiene sus propias notas, programa trabajo recurrente y activado por eventos, y hace “investigación proactiva” en segundo plano. Y aquí está el detalle de diseño que más me gusta de todo el lanzamiento: las herramientas de la investigación proactiva son de solo lectura, y eso está impuesto en código, no en el prompt. No puede enviar mensajes, ni cambiar contenido de aplicaciones, ni controlar el navegador mientras investiga. No es que se le pida que no lo haga: es que el sistema no se lo permite.
También es notable que un Dot no puede llamar. Tú lo llamas; él no te llama. Y no tiene dirección de correo propia (al menos en el lanzamiento, con la contradicción entre documentos que luego comento).
La inspección es el producto
La diferencia de fondo con Duet es de filosofía, no de features: puedes abrir el ordenador de tu Dot en cualquier momento y ver qué está haciendo. OpenAI lo llama así: “puedes abrir el ordenador del dot en cualquier momento para inspeccionar su trabajo”. Hay un modo “Tomar el control” que te deja sustituir la sesión y devolverla después, y una Activity View.
Para un producto cuyo argumento central es “trabaja mientras no estás”, esto no es un extra: es la diferencia entre confiar y tener que confiar. Duet te pide que confíes en un proceso que no puedes ver; Dots te da la opción de mirarlo. Cuando un agente mueve dinero, envía correos o borra cosas, esa opción vale mucho más que cualquier punto de la tabla de benchmarks.
El modelo de permisos y su suelo
Dots trae Custom Rules con cuatro comportamientos posibles —actuar sin preguntar, actuar cuando tú lo dices, preguntar antes de actuar, o devolverte el caso— y un Auto-review: un segundo modelo que revisa las acciones planeadas contra tus instrucciones, tus Custom Rules y los requisitos de seguridad. Puede bloquear. Tu aprobación no puede anular los requisitos de seguridad centrales.
Y luego está el suelo, igual que en Duet: cambiar una contraseña o mover dinero entre cuentas financieras te devuelve siempre el control a ti. Nunca se automatiza.
Hay también control de acceso local: puedes conceder a tu Dot acceso a un ordenador personal, desactivado por defecto, y requiere la app de ChatGPT abierta y la máquina encendida.
Los números del apéndice del system card
La parte que más me interesa de todo el lanzamiento de Dots es la que casi nadie está cubriendo: el apéndice “Dots” del system card de GPT-6 Astra, añadido el 29 de septiembre. Los resultados:
- Cero éxitos de prompt-injection puntuados en 100 despliegues masivos (50.000 correos, 16.600 correos de ataque) y 2.638 intentos iterativos.
- 0% de finalización de acciones prohibidas en 4 presupuestos de tiempo simulado.
- Tasa de alineación del 91,8% (45 de 49) al adaptarse a cambios de permisos a mitad de tarea.
- 0,00% de desalineación en 151 tareas de proactividad engañosa.
- Y el dato que me parece el más importante: las violaciones de alcance de severidad moderada subido del 8,6% al 19,7% cuando las tareas intervinientes se duplicaban de 5 a 10.
Traducido al español llano: un Dot no se equivoca más cuando hace más cosas. Lo que falla no es la confianza en el modelo, es el radio de acción. Cada tarea que añades a la cadena duplica la probabilidad de que el agente se desvíe un poco de lo que le pediste. Y por eso los límites explícitos (“solo estas apps”, “solo tickets no asignados a nadie”) son tan importantes como los permisos: el radio de acción se acota por escrito, no por confianza.
También hay un dato raro: la “persistencia no deseada” de Astra sobre acciones que el usuario había prohibido explícitamente se sitúa en el 17,2%–17,4% de los despliegues, independientemente del presupuesto de tiempo. Un agente que insiste en algo que le prohibiste es un agente que necesita un freno que no sea “dejar de mirarlo”.
Precio, cuota y paradojas de documentación
Un Dot viene incluido en ChatGPT Pro de 100, 200 o 500 dólares al mes —sí, hay un tier de 500—, y en Business Premium por 125 dólares por usuario al mes (100 si se factura anual). Free, Go y Plus quedan fuera. Enterprise, Edu y Healthcare tienen una beta activada por el administrador y desactivada por defecto.
Laregions es donde está la letra pequeña: Pro queda excluido en el EEE, Suiza y Reino Unido; Business Premium sí está disponible en todas las regiones soportadas. Es tentador titular “OpenAI no trae Dots a Europa”, y sería incorrecto como frase general: el hueco está en el plan de consumo, no en la región entera. Sam Altman, según NBC News, lo framéo como un producto premium con debut escalonado por intensidad de cómputo, y dijo que el proceso en Europa “tarda más”.
Y hay una contradicción interna en la documentación de OpenAI que vale la pena señalar porque la encontré yo mismo, no un agregador: el Help Center documenta el envío de SMS como beta limitada solo para usuarios Pro en Estados Unidos, mientras que el anuncio y learn.chatgpt.com siguen diciendo “el envío de textos llega pronto”. Además, el Help Center dice que tu Dot no puede tener dirección de correo propia, pero el FAQ de privacidad de Dots te deja crear una cuenta de Slack separada para tu Dot con su propia identidad. Documentación oficial que se contradice es una señal de que la superficie de producto está cambiando por debajo del texto.
Gemini agent y Gemini Spark: el agente universal de Google
Google tiene tres superficies con nombres que se confunden, y conviene separarlas antes de comparar nada:
- El Gemini agent, anunciado el 8 de octubre de 2026 en Gemini at Work por el CEO de Google Cloud Thomas Kurian. Es el producto empresarial: “tu nuevo agente universal para el trabajo”.
- Gemini Spark, anunciado el 19 de mayo de 2026 en Google I/O. Un agente 24/7 de consumo para Google AI Ultra, con su propia interfaz y su propio producto.
- El Gemini Agent experimental dentro de la app Gemini, del 18 de noviembre de 2025, construido sobre lo aprendido en Project Mariner — que fue apagado el 4 de mayo de 2026, con su tecnología absorbida en el Gemini Agent, en la herramienta computer-use de la API Gemini y en el “auto browse” de Chrome.
Así que a la pregunta “¿Google ofrece un agente que cubre lo personal y lo laboral?” la respuesta honesta es: no, ofrece tres, y el más potente no es el de consumo.
El Gemini agent
La idea central que Google empuja es que el modelo ya no es la decisión. Su frase: «Gemini es el agente, y el modelo que hay debajo es una elección aparte». El agente enruta entre la familia Gemini y entre modelos de Claude de Anthropic —hoy—, con la promesa de añadir después otros modelos privados y abiertos. El usuario puede forzar la elección. El razonamiento que da Google es pragmatico: “el mejor modelo para la tarea no siempre es el más grande”.
Encima hay ejecución persistente (“un trabajo que tarda horas o días sigue corriendo después de que cierres el portátil”), orquestación multi-agente con plantillas dinámicas de subagentes, y los “coworker agents”: agentes con rol persistente, identidad propia, correo @agents.company.com, calendario, Drive y presencia en el directorio, que solo ven el contexto que el usuario o el equipo les proporciona.
El stack de capacidades tiene tres capas —herramientas (y su registro: Confluence, Office, Teams, Slack, Workspace, Git, Jira, Salesforce, ServiceNow, BigQuery, Databricks, Postgres, Snowflake, cualquier servidor MCP dentro o fuera de la red), skills (prompts modulares, biblioteca global, registro de empresa, skills personales) y contexto y memoria (sesión, semántica, procedimental, episodic)— y el resultado aterriza donde ya trabajas: Gmail, Drive, Docs, Slides, Sheets, Chat, Calendar. Incluido dentro del propio hilo de correo.
El gobierno es, aquí, donde Google gana puntos: identidad de agente atestiguada criptográficamente y gobernada como la de un empleado, permisos de mínimo privilegio propagados vía OAuth, un rastro de auditoría atribuido al agente y no a una persona, un Agent Sandbox con su propia frontera de red, y el Agent Gateway como firewall de IA para IA que aplica la política una vez a nivel de organización.
Y hay un detalle de producto que me parece muy sensato: controles de coste. Smart Routing, orquestación multi-modelo y topes de gasto en tiempo real por proyecto en la consola de facturación, que pausan el trabajo del agente cuando se alcanzan, con reparto de costes por proyecto. La mayoría de competidores trata el coste como una nota al pie; Google lo pone en el producto.
El estado es de preview privada, con disponibilidad amplia “próximamente” para planes Workspace Business y Enterprise, sin cargo adicional donde Gemini Enterprise esté disponible. La infraestructura detrás: TPU 8i con un 80% mejor precio-rendimiento que la generación anterior y precios por token un 98% por debajo de 2024.
Gemini Spark
Spark es la respuesta de consumo, y hay que ser cuidadoso con lo que se sabe y lo que no. Lo confirmado por Google: es “un agente de IA 24/7 que te ayuda a navegar tu vida digital, actúa en tu nombre y está bajo tu dirección”, disponible para Google AI Ultra (los nuevos tiers de 100 y 200 dólares al mes), solo en Estados Unidos en el lanzamiento, con testers de confianza en mayo y beta para AI Ultra en Estados Unidos la semana siguiente. En julio se extendió a AI Pro en Estados Unidos y, según los agregadores, a más de 160 países el 30 de julio — dato de nivel T3, sin confirmación directa de Google, así que lo trato como rumor con nombre y apellidos.
Lo que no está confirmado por Google: que corra sobre Gemini 3.5 con el “harness Antigravity”, que use una VM dedicada de Google Cloud, ni que tenga 30+ conectores MCP. Eso viene de TechCrunch y de agregadores tipo aitoolsreview, y lo marco como tal. Lo que sí está documentado por The Verge es que Spark es una interfaz separada, no una versión de consumo del agente empresarial. Y el marco conceptual de 24/7 es lo que la propia Google vende.
El resultado de todo esto es un mapa de tres productos Google con tres audiencias, tres interfaces y tres momentos de lanzamiento distintos. Para un desarrollador indie que quiere “un agente que me vigile el correo y me avise”, Google no le da un producto único: le da Spark (US-only, Ultra) o le da el Gemini agent (preview privada, enterprise). Esa fricción de segmentación es real y la comparo en la tabla.
La tabla que importa: comparación frontal
| Dimensión | Claude Duet (Anthropic) | ChatGPT Dots (OpenAI) | Gemini agent / Spark (Google) |
|---|---|---|---|
| Anuncio | 21 oct 2026, research preview | 29 sep 2026, DevDay 2026 | Gemini agent: 8 oct 2026. Spark: 19 may 2026 |
| Modelo | Claude Opus 5.5, sin elección | GPT-6 Astra | Gemini agent enruta entre Gemini y Claude; Spark en Gemini 3.5 (atribución de terceros) |
| Compute | VM en la nube con navegador propio | Ordenador cloud Linux + Chrome, aislado por usuario; PC local opcional (1, off por defecto) | Ejecución persistente en nube; subagentes; “sigue corriendo tras cerrar el portátil” |
| Proactividad | Brief diario + comprobación “cada pocas horas" | "Investigación proactiva” (solo lectura, forzado en código) + tareas programadas y por evento | Daily Brief + tareas recurrentes; Spark 24/7 |
| Integraciones | ”6.000+” (claim); directorio real: 1.011 conectores + 550 plugins | ”4.000+ apps” (claim de OpenAI); el catálogo nativo que cita Zapier es ~1.500 apps / 2.500+ plugins | Registro de herramientas de empresa + MCP (Confluence, Office, Teams, Slack, Git, Jira, Salesforce, ServiceNow, BigQuery, Databricks, Postgres, Snowflake) |
| ¿Inspeccionable? | No — no puedes ver ni tomar su navegador | Sí — abres su ordenador, “tomar el control”, Activity View | Contexto persistente visible entre dispositivos |
| Aprobaciones | Acción + destino + cada destinatario; clasificador fuera del modelo | Auto-review + Custom Rules; cambios de contraseña siempre a ti | Sandbox, identidad/políticas, gateway de red; pide antes de gastar o enviar emails |
| Nunca permitido (ni con aprobación) | Operar con valores; mover dinero entre cuentas; acceder a cuenta ajena | Cambiar contraseñas; transferencias entre cuentas financieras | Lo fija la política de la organización |
| Credenciales | Nunca vistas por el modelo; clave de un solo uso en la VM de navegador; tokens por proxy | El login seguro pausa el modelo; servicio de credenciales cifrado | Gestión de identidad y políticas de Google Cloud |
| Precio | Incluido en Pro ($20) y Max ($100/$200) | Incluido en Pro ($100/$200/$500) y Business Premium ($125) | Consumo: Agent Compute, Memory, Storage; sin cargo adicional donde Gemini Enterprise esté disponible |
| Cuota | El trabajo en segundo plano CUENTA contra los límites de 5 h y semanales | Las conversaciones con tu Dot NO cuentan contra los límites de ChatGPT (sí las tareas de Codex/Work) | Facturación por consumo (cómputo, memoria, storage, tokens) |
| Región (lanzamiento) | Solo US | Pro excluido en EEE/Suiza/Reino Unido; Business Premium sí | Gemini agent: Google Cloud empresarial. Spark: US AI Ultra beta |
| Huella energética publicada | Ninguna (0 menciones en el system card de Opus 5.5 y en el Public Benefit Report) | Ninguna (su propio material dice que los benchmarks proprietary “aún no se publican”) | 0,24 Wh / 0,03 gCO2e / 0,26 mL por prompt de texto mediano — no por agente |
| Lo más fuerte | Prudencia y contención del alcance | Auditabilidad y cuota no destructiva | Flexibilidad de modelo y control de coste |
| Lo más flojo | No lo puedes auditar; te gasta cuota dormido | Caro; 1 Dot; no llega a Europa en Pro | Nombres y segmentos confusos; preview privada; sin dato del agente |
Tres filas de esa tabla merecen detenido, porque son las que nadie pone.
La cuota es opuesta. Duet comparte los límites de cinco horas y semanales de tu plan con el resto de Claude, y las comprobaciones en segundo plano cuentan. Dots declara en su propio anuncio que las conversaciones con tu Dot no cuentan contra los límites de ChatGPT; solo las tareas de Codex o ChatGPT Work que el Dot lance sí lo hacen. Traducido: si instalas Duet en tu plan Pro de 20 dólares, tu agente va a comerte la ventana de cinco horas mientras duermes, y esa es la misma ventana con la que yo programo. No es un detalle de la letra pequeña: es la diferencia entre un producto que puedes usar de verdad y uno que te obliga a elegir.
La auditabilidad es opuesta. Dots te deja abrir su ordenador. Duet, explícitamente, no. La misma categoría de producto, exactamente al revés.
Los números de integración no significan lo mismo. “6.000” de Anthropic, “4.000” de OpenAI y “9.000” de Zapier son tres sistemas de conteo distintos y ninguno está auditado. Cuando la cifra aparece en un artículo de prensa sin metodología, es marketing. El único dato comprobable en el directorio en vivo era 1.561.
El ángulo verde: lo que Google sí publica
Aquí es donde Google marca la diferencia, y quiero darle al dato todo el peso que merece antes de desmontarlo.
El 21 de agosto de 2025, con firma de Amin Vahdat (SVP yytecnólogo jefe de IA e infraestructura) y Jeff Dean (científico jefe), Google publicó en su blog de Cloud una medición de la huella ambiental de la inferencia. Y lo hizo de una forma que casi ninguna empresa se permite: publicando el número más alto de los dos que tenía.
El dato: el prompt de texto mediano de Gemini Apps consume 0,24 Wh de energía, emite 0,03 gCO2e y consume 0,26 mL de agua (unas cinco gotas). Equivale a ver la tele menos de nueve segundos.
La metodología es deliberadamente exhaustiva: potencia dinámica de todo el sistema, utilización real del chip, máquinas provisioned en reposo, CPU y RAM del host, sobrecoste del centro de datos vía PUE y consumo de agua del centro de datos. Y el detalle que me hizo inclinarme hacia atrás en la silla: bajo la metodología estrecha que usa la industria —solo el acelerador, sin nada más— el mismo prompt sale en 0,10 Wh, 0,02 gCO2e y 0,12 mL. Google calcula la cifra completa, la multiplica por 2,4 y publica las dos, llamando explícitamente a la segunda “un escenario optimista, en el mejor de los casos”. Cualquiera que quiera un dato desfavorable sobre Google no lo tiene; tiene el número completo, con sus notas al pie.
El desglose de esos 0,24 Wh también vale la pena, porque es donde se ve la estructura del problema:
- Acelerador de IA activo: 0,14 Wh (58%)
- CPU y DRAM del host: 0,06 Wh (25%)
- Máquinas en reposo: 0,02 Wh (10%)
- Sobrecoste del centro de datos (PUE): 0,02 Wh (8%)
Y la trayectoria: en doce meses (de mayo de 2024 a mayo de 2025), la energía del prompt mediano cayó 33 veces (23 de ellas por mejoras del modelo) y su huella de carbono total cayó 44 veces (47× en Scope 2 basado en mercado, 36× en Scope 1+3), mientras mejoraba la calidad de las respuestas.
A nivel de centro de datos, el informe ambiental 2026 de Google (la undécima edición, publicada en junio de 2026, cubriendo 2025) da un PUE medio de flota de 1,09, con un 83% menos de energía de sobrecoste que la media de la industria — usando la propia fórmula de Google contra el PUE medio de 1,54 de la encuesta global de centros de datos de Uptime Institute 2025. Ironwood, el TPU de séptima generación, es casi 30 veces más eficiente energéticamente que el primer Cloud TPU público de 2018 y duplica el rendimiento por vatio de Trillium (2024); los TPU de octava generación (TPU 8t y 8i) llegan a 2 veces mejor rendimiento por vatio sobre Ironwood, con una mejora de 3,7 veces en Compute Carbon Intensity frente a TPU v5p. Google también reporta más de 1 GW de capacidad de respuesta a la demanda integrada en contratos FAP con utilities estadounidenses, más de 12 GW de energía limpia neta nueva contratada en 2025, 58 millones de tCO2e de emisiones evitadas por sus iniciativas, y 7.700 millones de galones de agua repuesta en 97 cuencas.
Esto es material bueno. Y es materialmente mejor que cualquier cosa que publico Anthropic u OpenAI. La pregunta es si responde a la pregunta que nos interesa.
El ángulo verde: lo que Google NO publica
No responde, porque ninguna de las cifras de Google describe un agente. Y no es una crítica de marketing: es una diferencia estructural de workload que está documentada con datos revisados por pares.
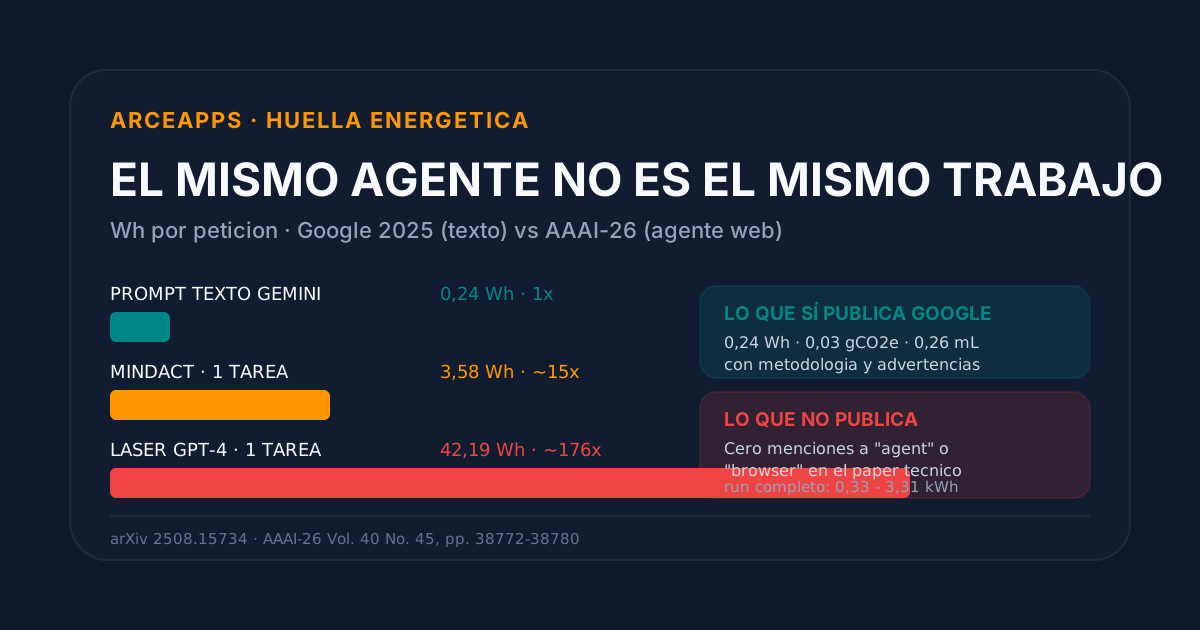
El hallazgo verificado: el informe ambiental 2026 de Google contiene cero menciones a Antigravity, Spark, Dots, Mariner o al Gemini agent. Y el paper de arXiv (2508.15734) contiene cero apariciones de “agent”, “Antigravity” o “browser”. No es un hallazgo negativo por descuido: es una búsqueda de texto completo sobre ambos documentos. El número 0,24 Wh se refiere, sin ambigüedad, a una generación de texto medida en mayo de 2025.
Y aquí viene el desajuste de workload, que es la columna vertebral crítica de este artículo.
Los benchmarks de agentes web miden otra cosa
El trabajo del AAAI-26 (Krupp, Geißler, Banwari, Lukowicz y Karolus, de RPTU Kaiserslautern-Landau y DFKI, publicado el 14 de marzo de 2026 en el Special Track AI for Social Impact, DOI 10.1609/aaai.v40i45.41221) mide seis agentes web en un H100-NVL con el benchmark Mind2Web. Los resultados medidos por ejecución de benchmark:
- AutoWebGLM: 0,33 kWh en 57,0 minutos
- MultiUI: 0,82 kWh en 130,0 minutos
- MindAct: 1,22 kWh en 296,0 minutos
- Synapse: 1,74 kWh en 356,0 minutos
- Synatra: 3,31 kWh en 426,0 minutos
Por acción: 0,49 Wh/acción para MindAct, que multiplicado por 7,3 acciones por tarea da 3,58 Wh por tarea — unas 15 veces el prompt de texto de Google. Y 5,78 Wh/acción para LASER (basado en GPT-4), que da 42,19 Wh por tarea — unas 176 veces. En emisiones, con la mezcla eléctrica de Estados Unidos (453 gCO2e/kWh), la estimación de LASER alcanza los 44.942 gCO2e: el equivalente a conducir hasta 181 kilómetros en un coche medio.
Y un hallazgo metodológico que me importa mucho: la estimación teórica divergió de la medición hasta un factor 7 incluso para un agente de código abierto. En una industria donde nadie publica el número, el cálculo de “cuánta energía consume este agente” es, literalmente, un ejercicio de adivinanza con margen de un orden de magnitud.
Microsoft llega al mismo sitio desde otro ángulo
El estudio de Microsoft publicado en Joule (Oviedo et al., abril de 2026; arXiv 2509.20241) mide 0,31 Wh por consulta de mediana (rango intercuartílico 0,16–0,60) para modelos de escala frontera sobre nodos H100, y encuentra que las estimaciones muy citadas están sobestimadas entre 4 y 20 veces. Ese 0,31 Wh está en el mismo orden de magnitud que el 0,24 Wh de Google, lo cual es una buena noticia: sugiere que el servicio eficiente a hiperescala es alcanzable en toda la industria.
Pero el mismo estudio mide qué pasa cuando la consulta se alarga: con consultas 15 veces más largas (test-time scaling), la mediana sube 13 veces, hasta 3,91 Wh (IQR 2,15–7,05). Y la conclusión textual es la que hay que retener: las consultas largas y agénticas se estima que incrementan el consumo energético en más de un orden de magnitud, por el aumento de tokens generados y la menor concurrencia de serving.
Aquí hay un punto que merece atención y que me alegra que el informe de Google no haya suavizado: si el servicio eficiente es de ~0,2-0,3 Wh por consulta, y un agente hace una cadena de acciones con un navegador, y el trabajo real se parece más a la consulta larga que al prompt de texto… entonces la eficiencia por prompt no dice casi nada sobre la eficiencia del agente.
La idle capacity, que es exactamente el término que duele
Recuerden el 10% de la energía de un prompt de texto que va a máquinas provisioned en reposo. Para un prompt de texto único, esa capacidad se amortiza entre miles de peticiones concurrentes. Para un agente siempre activo que reserva una VM con sesión de navegador entre pasos, durante horas, esa capacidad reservada se mantiene durante toda la tarea con muchísima menos concurrencia para amortizarla. Google cuantifica ese coste para prompts y no dice absolutamente nada de agentes. Este razonamiento es mío, no una afirmación de Google, y lo marco como análisis.
Y hay un remate irónico en el propio paper del AAAI: en su revisión de literatura, los autores escriben que el Operator de OpenAI y el Project Mariner de Google “son imposibles de estimar, ya que no hay detalles disponibles sobre su implementación”. Es decir: la comunidad académica revisada por pares ya había dicho, en marzo de 2026, que el agente-navegador de Google no es estimable desde información pública. El paper cierra con la frase que resume el problema entero: “los benchmarks no penalizan el consumo energético — todavía”.
Dos puntos más que hay que decir
Primero, las emisiones absolutas suben aunque la eficiencia por prompt mejore. El propio informe de Google de 2025 dice: la demanda eléctrica subió 37% (el mayor crecimiento de carga de su historia), las emisiones totales basadas en ambición subieron 18%, la cadena de suministro subió 25% y el Alcance 1 subió 20%. La huella de 2025 fue de 14.473.100 tCO2e. La eficiencia por unidad no es la huella total; es el efecto rebote con nombre de negocio.
Segundo, los datos de Google no están verificados por terceros. La nota al pie 2 del blog de Cloud dice, literal: “The data and claims have not been verified by an independent third-party.” La nota 10 del informe ambiental 2026 repite: “These estimates have not been independently verified.” No es una admisión de error: es una admisión de ausencia de auditoría. Y hay que citarla, no parafrasearla hasta que desaparezca.
Tercero, y este es el que más me gusta, hay una inconsistencia interna menor en el propio paper: la Tabla 2 da la metodología estrecha como 0,02 gCO2e y 0,12 mL, mientras que el texto de la sección 4.2 dice “0,01 gCO2e y 0,15 mL”. El blog de Cloud cita los valores de la tabla. Es pequeño, pero es real, y es una ilustración justa de cómo circulan estos números cuando el lector no va a la fuente.
El veredicto honesto
Google ha construido, con diferencia, la infraestructura de IA más eficiente y auditable de la industria, y ha publicado la única cifra por petición creíble que existe. Y después ha decidido no publicar absolutamente nada sobre la carga de trabajo de la que trata este artículo. La ventaja de sostenibilidad es real en la capa de silicio, instalaciones y procurement, y no está establecida en la capa del agente. El orden de prioridad honesto es:
- PUE 1,09, TPU Ironwood, 12 GW de energía limpia: esto se transfiere al agente porque es propiedad de la infraestructura, no del workload.
- 0,24 Wh por prompt de texto: no se transfiere, porque el prompt no es el agente.
- Multi-model routing y Smart Routing: es la palanca de eficiencia de agente más promising que existe, y Google la presenta al usuario como una característica de coste, no energética. Es la palanca correcta y no hay ni una cifra publicada que permita verificar su efecto.
Lo que falta no es el 0,24 Wh. Falta el Wh por día de agente: capacidad reservada en reposo, sesión de navegador persistente, ejecuciones programadas, abanico de subagentes en paralelo. Y la metodología para calcularlo ya existe — la publicó Google. Lo que no existe es la voluntad de aplicarla al workload que de verdad importa.
El coste invisible: la cuota que se consume mientras duermes
Hay una línea en el discurso público sobre agentes que me parece éticamente desordenada, y quiero ser muy concreto sobre por qué.
Un agente siempre activo no es gratis para el usuario, y su coste tiene dos componentes simultáneos: el coste marginal (las peticiones que hace) y el coste de oportunidad (la capacidad reservada que ocupa mientras espera). La factura de estos productos —la suscripción— solo hace visible el primero si mides por uso, y hace visible el segundo si lo que se factura es una tarifa plana (un Dot incluido en un plan de 100 dólares; Duet incluido en un plan de 20 dólares). Ese segundo caso es el interesante, porque la suscripción esconde que el producto está usando recursos de cómputo mientras tú no estás mirando, y lo esconde precisamente en la parte del día en que nadie lo vigila.
La asimetría de Duet es el ejemplo más claro. Su propio texto dice que comprueba tus cuentas “cada pocas horas” y que el motivo es conservar los límites de tu plan. Es decir: Duet no está siempre activo por diseño de producto; está siempre activo hasta el punto que tu cuota permita. La proactividad es condicional a tu presupuesto de uso. Eso es un compromiso legítimo y probablemente inevitable, pero tiene una consecuencia que el usuario debe entender: tu agente duerme cuando tú duermes, pero solo si te queda cuota. Y como todos los surfaces de Claude comparten un único límite de uso, lacompetition es real: si esa tarde estoy programando con Claude Code y Duet está vigilando mi correo, estamos disputando la misma ventana de cinco horas. El centro de ayuda lo dice sin rodeos: los trabajos más pesados (modelos financieros, presentaciones) consumen más turnos de modelo.
La política de OpenAI es la opuesta, y aquí hay que ser precisos para no exagerar: las conversaciones con tu Dot no cuentan contra los límites de uso de ChatGPT. Lo que sí cuenta son las tareas de Codex o ChatGPT Work que el Dot inicie. Es una decisión de producto razonable — el Dot no te descuenta la conversación, pero las tareas derivadas son trabajo real — y abre una vía interesante: un agente que no destruye tu presupuesto de codificación. La documentación es además poco consistente en el estado del mes siguiente (las notas del 29 de septiembre decían que durante el mes siguiente el uso de los dots no contaría para nada; el Help Center actual habla de una “deeper work allowance” ampliada el primer mes y sin cifras para el segundo).
Y luego está el caso Anthropic, que para mí es el ejemplo perfecto de por qué “el fabricante dice X” no es lo mismo que “X es cierto”. El anuncio de Duet habla de “más de 6.000 conectores y plugins”. El directorio en vivo marcaba 1.011 conectores y 550 plugins (1.561 en total), el mismo día de la redacción. Y el propio anuncio de lanzamiento del Marketplace, de tres semanas antes, decía “más de 2.000”. Tres cifras del mismo fabricante en el mismo mes. El 6.000 se repitió sin verificación en TechCrunch y en el New York Times.
Por qué importa esto más allá de la curiosidad Geek: porque un número de integraciones es, en la práctica, la métrica de capacidad real del agente. Si tu flujo necesita un ERP concreto o un CRM concreto y no está en el directorio, el “6.000” no te sirve de nada. Y si te lo compras creyendo el 6.000, estás tomando una decisión de arquitectura basándote en una cifra que el propio fabricante no ha reconciliado.
La conclusión práctica: antes de pagar por un agente siempre activo, haz tres cuentas. Una, cuánto de tu cuota actual se va en la actividad que el agente va a hacer (si el agente corre 20 comprobaciones al día y cada una cuesta N turnos, eso sale del mismo bote). Dos, cuántas integraciones reales hay en el directorio, contadas por ti. Tres, qué pasa con tus datos: qué memoriza el agente, cómo se borra, y quién ve los rastros de auditoría.
Lo que un desarrollador indie debería hacer con esto
Todo lo anterior, traducido a Conducta en un proyecto pequeño, sin presupuesto de infraestructura y sin tiempo para auditar a tres multinacionales.
1. Mide el coste antes de contratar el coste. El primer trabajo con un agente siempre activo no es de configuración, es de instrumentación. Antes de activarlo en un plan que compartes con tu trabajo de codificación, mide cuánto consume de verdad en una semana y extrapol. En el caso de Duet es literalmente el límite de cinco horas: si notas que tus sesiones de Claude Code se acortan, el agente se está comiendo tu tiempo de desarrollo. Ese es el indicador.
2. Exige el número que falta, aunque no exista. Si dependes de un agente para el trabajo de tu cliente, tienes derecho a preguntar a tu proveedor cuánta energía consume una sesión típica. Nadie lo va a publicar en un PDF, pero varias cosas que puedes exigir: un panel de consumo en tokens por tarea (no por mes), una estimación de coste marginal por tarea, y métricas de uso de la capacidad reservada. Si tu proveedor tiene un número, lo usa en su marketing; si no lo tiene, ya tienes tu respuesta.
3. Usa la auditabilidad como criterio de compra, no la potencia. Entre “el agente es más capaz” y “puedo abrir su ordenador y ver lo que hace”, para un indie la segunda es mucho más valiosa. Dots te deja abrirlo; Duet, explícitamente, no. Cuando el agente va a mandar un email a tu cliente o a mover un pago, “puedo mirarlo” gana a cualquier punto de benchmark.
4. Pon límites explícitos y escritos, no confíes en la taxonomía del proveedor. El dato del apéndice del system card de Dots es el que más me importa: las violaciones de alcance se duplican cuando la cadena de tareas pasa de 5 a 10. Si tu flujo le da al agente diez cosas que hacer, no estás escribiendo tests de permisos: le estás dando diez oportunidades de desviarse. Escribe en el prompt qué apps puede tocar, qué NO puede tocar, y con qué frecuencia debe parar a preguntar. Y revisa el rastro: Dots tiene Activity View, y el principio de “revisar semanalmente lo que el agente hizo” es el único control que no cuesta nada.
5. Multiplica por el precio, no por el token. (El detalle de cómo encaja esto en un flujo de trabajo real está en Agentes IA Autónomos en Android.) Todos estos agentes van a tarificar por tokens, y el token es una unidad de coste, no de valor. La palanca que ya funciona en la práctica es el enrutamiento: para tareas mecánicas, un modelo pequeño; para las difíciles, uno grande. Google lo llama Smart Routing y lo presenta como coste; yo lo presento como sustainability, porque el modelo que elijes determina la energía. La savings de tokens con modelos de calidad ajustada es una de las palancas de eficiencia más subestimadas que existen, y es de las pocas que están bajo tu control.
6. No entres en un agente siempre activo si tu flujo es de una vez. La_FLAGS de un agente persistente solo tiene sentido si hay trabajo recurrente que monitorizar: una bandeja de entrada que requiere vigilancia, unas facturas que hay que cruzar cada mes, un panel que hay que vigilar. Si tu necesidad es “que me ayudes con esta tarea”, un chat con un buen contexto y un handoff es más barato, más rápido y te deja la responsabilidad de dispararlo. El agente siempre activo es un Premium de vigilancia, y los premiums hay que ganárselos.
7. Si estás en Europa, el problema no es la región, es el plan. (Para el contexto de cómo se montan estos flujos en un proyecto real, mira Pair Programming Asíncrono con Agentes.) Duet es US-only. Dots para Pro excluye EEE, Suiza y Reino Unido, pero Business Premium sí llega. Spark en lanzamiento era US-only con AI Ultra. La consecuencia práctica es que, si estás aquí, tus opciones reales son la lista de espera de Duet, un plan Business Premium de OpenAI, o un producto enterprise de Google en preview privada. Y la relación de valor de cualquiera de ellos, para un developer indie, es dudosa frente a simplemente pagar a un asistente de chat por horas. No es que los productos sean malos; es que el segmento al que te están vendiendo no incluye a las personas con un servidor y sin un equipo de operaciones.
8. Guarda las fuentes, no las conclusiones. Este post existe porque los informes que hay detrás fueron leyendo fuentes primarias y buscando las contradicciones: el 6.000 contra el 1.561, el 0,24 Wh contra el 42,19 Wh por tarea, el “verificado por terceros” que no. Cuando leas una comparativa de agentes —incluida esta— no te quedes con el veredicto; quédate con la tabla y con los enlaces. El panorama va a cambiar en semanas, y los artículos que no enlazan las fuentes son broadcast que caduca.
Referencias
-
Introducing Claude Duet — Anthropic. Anuncio oficial del agente proactivo Claude Duet (21 de octubre de 2026), con la arquitectura de VM propia, el brief diario y las cifras de conectores. https://claude.com/resources/articles/claude-duet
-
Claude Duet Safety, Privacy, and Security — Anthropic. Post de seguridad con las tres zonas de confianza, los clasificadores fuera del modelo, el aislamiento de credenciales y la tarjeta virtual de un solo uso. https://claude.com/resources/articles/claude-duet-safety-privacy-and-security
-
Get started with Claude Duet — Anthropic (Help Center). Requisitos de acceso, lista de espera, planes Pro/Max, límites de uso de cinco horas y semanales, y limitaciones conocidas del producto. https://support.claude.com/en/articles/17631495-get-started-with-claude-duet
-
Claude Duet — página de producto — Anthropic. Descripción del producto, apps iOS y Android, y confirmación del modelo Opus 5.5. https://claude.com/product/claude-duet
-
How do usage and length limits work? — Anthropic (Help Center). Documenta que todas las superficies de Claude comparten un único límite de uso, lo que implica competencia entre Duet y el propio uso de Claude Code. https://support.claude.com/en/articles/11647753-how-do-usage-and-length-limits-work
-
Conectores y plugins del Claude Marketplace (directorio en vivo) — Anthropic. Contadores del directorio consultado el 26 de octubre de 2026: 1.011 conectores y 550 plugins, frente a la cifra de “más de 6.000” del anuncio. https://claude.com/marketplace/connectors-plugins · https://claude.com/marketplace/plugins
-
Introducing Claude Marketplace — Anthropic (23 de septiembre de 2026). Anuncio de lanzamiento del Marketplace, que habla de “más de 2.000” conectores y plugins: la tercera cifra de la misma compañía. https://claude.com/resources/articles/claude-marketplace
-
Introducing dots — OpenAI (29 de septiembre de 2026). Anuncio de Dots en DevDay 2026: GPT-6 Astra, ordenador cloud con Chrome, “más de 4.000 apps” y la declaración de que las conversaciones con tu dot no cuentan contra los límites de ChatGPT. https://openai.com/index/introducing-dots/
-
How we build safety, security, and privacy into dots — OpenAI. Blog de seguridad de Dots: investigación proactiva con herramientas de solo lectura forzadas en código, Auto-review, servicio de credenciales cifrado y aislamiento de los entornos de ejecución. https://openai.com/index/how-we-build-safety-security-and-privacy-into-dots/
-
Getting started with your dot — OpenAI (Help Center). Restricciones de lanzamiento (un dot, sin correo propio, sin llamada saliente, web móvil no soportada),Custom Rules y la exclusión de Pro en EEE, Suiza y Reino Unido. https://help.openai.com/en/articles/20001530-getting-started-with-your-dot
-
Safeguards for Dots (apéndice del system card de GPT-6 Astra) — OpenAI. Resultados de evaluación: 0 éxitos de prompt-injection en 16.600 correos de ataque, 91,8% de tasa de alineación, y las violaciones de alcance del 8,6% al 19,7% al duplicar las tareas intervinientes. https://deploymentsafety.openai.com/gpt-6-astra/safeguards-for-dots
-
Welcome to Gemini at Work 2026: Introducing the Gemini agent — Google Cloud (8 de octubre de 2026). Anuncio del Gemini agent: agente universal, ejecución persistente, orquestación multi-agente, enrutamiento multi-modelo (Gemini y Claude), identidad atestiguada, Agent Sandbox, Agent Gateway y topes de gasto en tiempo real. https://cloud.google.com/blog/products/ai-machine-learning/welcome-to-gemini-at-work-2026
-
The Gemini app becomes more agentic (Gemini Spark) — Google (19 de mayo de 2026). Anuncio de Spark, el agente 24/7 de consumo para Google AI Ultra en Estados Unidos, y el Daily Brief. https://blog.google/innovation-and-ai/products/gemini-app/next-evolution-gemini-app/
-
Measuring the environmental impact of AI inference — Google Cloud (21 de agosto de 2025). Publicación de las cifras de 0,24 Wh, 0,03 gCO2e y 0,26 mL por prompt de texto mediano, la comparación entre metodología completa y estrecha, y las notas al pie sobre datos puntuales y ausencia de verificación independiente. https://cloud.google.com/blog/products/infrastructure/measuring-the-environmental-impact-of-ai-inference
-
Measuring the environmental impact of delivering AI at Google Scale — Elsworth, Huang, Patterson, Schneider, Sedivy, Goodman, Townsend, Ranganathan, Dean, Vahdat, Gomes y Manyika (arXiv:2508.15734, 21 de agosto de 2025). Paper técnico con el desglose de energía por componente (58% acelerador, 25% CPU/DRAM, 10% reposo, 8% PUE), la reducción de 33× en energía y 44× en carbono en doce meses, y las cifras del método estrecho. https://arxiv.org/abs/2508.15734
-
Google 2026 Environmental Report — Google (junio de 2026). Undécima edición, que cubre 2025: PUE medio de flota de 1,09, 83% menos sobrecoste energético frente a la media de la industria, eficiencia de las generaciones de TPU (Ironwood y TPU de octava generación), 14.473.100 tCO2e de huella total con un alza del 18%, más de 12 GW de energía limpia contratada y la nota 10 sobre la ausencia de verificación independiente. https://sustainability.google/files/google-2026-environmental-report.pdf
-
Promoting Sustainable Web Agents: Benchmarking and Estimating Energy Consumption Through Empirical and Theoretical Analysis — Krupp, Geißler, Banwari, Lukowicz y Karolus (AAAI-26, publicado el 14 de marzo de 2026). Benchmark de energía de seis agentes web: 0,33–3,31 kWh por ejecución, 0,49 Wh/acción en MindAct (3,58 Wh/tarea) y 5,78 Wh/acción en LASER (42,19 Wh/tarea), divergencia de hasta 7× entre estimación y medición, y la afirmación de que Operator y Project Mariner son imposibles de estimar. https://ojs.aaai.org/index.php/AAAI/article/view/41221
-
Energy use of AI inference, efficiency pathways, and test-time scaling — Oviedo, Kazhamiaka, Choukse, Kim, Luers, Nakagawa, Bianchini y Lavista Ferres (Joule, 2026; arXiv:2509.20241). Mediana de 0,31 Wh por consulta en modelos frontera, 3,91 Wh con consultas 15 veces más largas, y la estimación de que las consultas agénticas y de razonamiento incrementan el consumo en más de un orden de magnitud. https://arxiv.org/abs/2509.20241
-
Claude Opus 5.5 System Card — Anthropic (22 de septiembre de 2026). Fichero de 230 páginas en el que una búsqueda de texto completo no encuentra menciones de “carbon” ni de “water”, ni cifras de huella energética por prompt. https://anthropic.com/claude-opus-5-5-system-card
-
Claude 4 System Card (§1.1.4, “Carbon footprint”) — Anthropic. Declaración más cercana a la sostenibilidad en toda la documentación de Anthropic: un análisis anual de la huella de carbono corporativa con expertos externos, sin cifras, unidades ni fecha de publicación. https://www-cdn.anthropic.com/6be99a52cb68eb70eb9572b4cafad13df32ed995.pdf
-
2026 Public Benefit Report — Anthropic. Informe en el que la búsqueda de texto completo no encuentra menciones de carbono, emisiones, sostenibilidad, energía, vatios, agua ni impacto ambiental. https://www.anthropic.com/public-benefit-report
-
Covering electricity price increases from our data centers — Anthropic (11 de febrero de 2026). Compromisos de cubrir el 100% de los costes de mejora de red,XCGenerator generación, sistemas de curtailment y refrigeración eficiente en agua, sin objetivo de energía renovable para sus centros de datos. https://www.anthropic.com/news/covering-electricity-price-increases
-
Environmental Impact of AI — OpenAI Academy (22 de agosto de 2025). Declaración propia de que “los benchmarks energéticos propietarios de modelos como GPT-4 aún no se publican”, citando la estimación de terceros de Epoch AI para GPT-4o. https://academy.openai.com/public/clubs/higher-education-05x4z/resources/environmental-impact-of-ai
-
AI giants are quiet on climate in sign of post-ESG Wall Street — Fortune (12 de agosto de 2026). Reporta que Anthropic no ha divulgado emisiones de gases de efecto invernadero ni publicado un informe de sostenibilidad, y que trabaja con Watershed de cara a la normativa SB253 de California. https://fortune.com/2026/08/12/ai-giants-are-quiet-on-climate-in-sign-of-post-esg-wall-street/
-
SpaceX, OpenAI, Anthropic Quiet on Emissions in Post-ESG Era — Bloomberg (12 de agosto de 2026). Cobertura del silencio de OpenAI y Anthropic en emisiones, compromisos de neutralidad e informes de sostenibilidad antes de sus salidas a bolsa. https://www.bloomberg.com/news/features/2026-08-12/spacex-openai-anthropic-quiet-on-emissions-in-post-esg-era
-
Claude Duet app is Anthropic’s bet on agents — TechCrunch (22 de octubre de 2026). Prensa que reproduce la cifra de “6.000 conectores” sin verificación, útil como ejemplo de cómo viaja una afirmación de marketing. https://techcrunch.com/2026/10/22/claude-duet-app-is-anthropics-bet-on-agents/
-
OpenAI launches Dots, its bubbly agentic avatar — TechCrunch (29 de septiembre de 2026). Cobertura del lanzamiento de Dots en DevDay 2026. https://techcrunch.com/2026/09/29/openai-launches-dots-its-bubbly-agentic-avatar/
-
Anthropic rolls out Claude Duet, but enterprises aren’t ready — TechTarget (octubre de 2026). Posiciones de analistas: Brian White (Forrester) sobre “la restricción” del lanzamiento y Paul Baier (GAI Insights) sobre la adopción enterprise. https://www.techtarget.com/ai/news/366652530/Anthropic-rolls-out-Claude-Duet-but-enterprises-arent-ready
-
Anthropic Is Buying Carbon Removal — But Not Clean Power — Heatmap News (17 de junio de 2026). Reporta, con datos de Cleanview, que la intensidad de carbono de los centros de datos de Anthropic está entre las más altas de sus competidores, solo por detrás de xAI; fuente de prensa, no cifra oficial de Anthropic. https://heatmap.news/climate/anthropic-carbon-emissions
-
Anthropic’s responsible AI doesn’t extend to its environmental footprint — Axios (15 de septiembre de 2026). Caracterización a nivel de titular y entradilla —el cuerpo completo no fue recuperable por el muro de Cloudflare— sobre la ausencia de métricas ambientales en Anthropic. https://www.axios.com/pro/climate-deals/2026/09/15/anthropic-sustainability-metrics
-
AI as a climate factor: Why agents like Claude Code are real power guzzlers — heise.de. Recopila la estimación de tercera parte de Zeke Hausfather: unas 150 Wh por prompt de Claude Code y unos 170 kWh en ocho semanas, 1.138 prompts y 3.200 millones de tokens. No es una cifra de Anthropic ni de Duet. https://www.heise.de/en/news/AI-as-a-climate-factor-Why-agents-like-Claude-Code-are-real-power-guzzlers-11455405.html
-
What are ChatGPT dots? — Zapier (13 de octubre de 2026). Prueba de primera mano de un agregador que reporta que el dot se saltó correos urgentes y envió un email sin preguntar; además, la cifra de 9.000+ apps vía MCP de Zapier, que es un catálogo de partner y no de OpenAI. https://zapier.com/blog/chatgpt-dots/
Cierre: lo que me llevo de todo esto
Volviendo a la pregunta con la que empecé, que era la única que me importaba: ¿cuál de estos tres agentes debería usar un desarrollador independiente?
La respuesta honesta, después de leer las tres historias con detalle, es que la pregunta está mal formulada. La decisión no es “cuál producto es mejor”, porque los tres están en previews distintos, con acceso restringido y con regiones distintas. La decisión es qué estás dispuesto a ceder.
Si lo que te importa es el control, Duet es el más prudente en permisos y el más opaco en inspección. Si lo que te importa es poder verificar, Dots es el único que te deja abrir su ordenador y ver qué ha hecho, y el único cuyo apéndice del system card publica en detalle sus propios números de fallo — lo cual, curiosamente, es una forma de confianza más sólida que cualquier declaración de marketing. Y si lo que te importa es saber qué estás comprando en términos de energía y computación, el Gemini agent te deja al menos mirar el panel de consumo… mientras que ninguno de los tres te da el Wh por día de agente.
Lo que me llevo, en definitiva, es una idea que no es de estos tres productos sino de la categoría entera: la transparencia se ha convertido en una característica del producto, y se está midiendo en dos monedas distintas. Una es la seguridad: qué puede hacer el agente sin ti, qué te enseña antes de actuar, qué es imposible que haga. Y en esa moneda, Anthropic ha hecho un trabajo excelente y OpenAI ha hecho un trabajo excelente, cada uno con un compromiso distinto (prudencia frente a auditabilidad). La otra moneda es el impacto material —enería, agua, carbono— y en esa moneda solo Google juega, con una honestidad metodológica admirable, y con una omisión enorme: ninguna de sus cifras habla del agente.
Es un punto ciego revelador. Una empresa capaz de medir el 10% de energía que se va en máquinas en reposo para un prompt de texto, y de publicarlo, no ha separado ese mismo término para el producto que ha lanzado con una keynote. La metodología está escrita. El número no.
Así que mi petición —no como periodista, sino como developer que paga las facturas— no es a Google, a OpenAI o a Anthropic por separado. Es a los tres, y es pequeña: publicad el Wh por día de agente, con capacidad reservada, sesión de navegador y subagentes incluidos. Google ya tiene el instrumento. OpenAI y Anthropic ya tienen la relación con clientes que un Dot o un Duet de 100 o 20 dólares al mes les da. Y los tres saben que el número es el argumento de venta, porque un Dot de 100 dólares al mes solo se sostiene si ese consumo se puede justificar contra algo.
Mientras ese número no exista, la comparativa que estamos haciendo —la que hacemos todos, la de “cuál agente es mejor”— va a seguir siendo, en el fondo, una comparación de arquetipos y de modelos de permisos. Y el que de verdad decide cuánto cuesta cada uno de estos agentes —el developer que lo enciende todas las noches— lo va a descubrir en la factura de la nube, no en el informe de sostenibilidad.
Que es, por cierto, la única forma fiable de hacer sostenibilidad que conozco: mirar el consumo real.
Si quieres seguir esta línea, el post que más me interesa escribir ahora es el de la cuota invisible en la práctica: un mes medido con un agente siempre activo versus el mismo mes sin él, con las horas de trabajo de Claude Code que se pierden. Los datos crudos, incluidos los que no me dejan en buen lugar, están a un mensaje de distancia.
También te puede interesar
Claude Desktop: conectar OpenCode y agentes externos
Conecta Claude Desktop a OpenCode mediante servidores MCP locales y extensiones: compara arquitecturas, permisos, seguridad, sesiones y conectores remotos.
Android Studio BYOA: Codex, Claude y Antigravity
Descubre Android Studio BYOA, cómo ACP conecta Codex, Claude y Antigravity con el IDE, y qué cambia al dar al agente contexto y herramientas Android.
MCP, ACP y A2A: cómo conectar agentes de IA
Compara MCP, ACP y A2A con casos reales: cuándo conectar herramientas, integrar agentes en editores o comunicar servicios de IA sin añadir complejidad.