
2026 W37: Codex aprende a repartir trabajo (Agent Router)
La semana en la que “delegar” dejó de significar cualquier cosa
Hay palabras que en informática deberían venir con un pequeño abogado incorporado. “Servicio”. “Proceso”. “Agente”. Y, desde esta semana, “delegar”.
Llevaba tiempo usando Codex como punto principal de trabajo y acumulando a su alrededor herramientas que me gustan por motivos distintos: OpenCode, Antigravity, varios modelos accesibles desde distintos proveedores y la posibilidad de sacar trabajo largo a MiniMax. El problema no era conseguir que cada herramienta funcionara por separado. Ese problema, sorprendentemente, es el fácil.
El problema era que todas funcionaban demasiado por separado.
Abrir una herramienta, copiar una tarea, pegar contexto, esperar, volver a otra ventana, comprobar qué cambió, intentar recordar quién había tocado qué y luego seguir la conversación original es una forma muy moderna de recrear manualmente una centralita telefónica de 1950.
La idea de esta semana fue acabar con eso.
Quería seguir hablando con Codex. Quería que Codex siguiera siendo el lugar desde el que pienso una feature, reviso un bug o decido qué hacer con un repositorio. Pero quería poder decir: esta parte mándasela a otro agente. No “dame un prompt para copiar”. No “abre otro programa”. Mándasela tú.
Y, ya puestos, quería que no todos los agentes fueran iguales. Un trabajo sencillo no necesita la misma ruta que una migración enorme. Una tarea que exige ejecutar, compilar, fallar, corregir y repetir no se parece a generar documentación. Un modelo gratuito tiene sentido para ciertas cosas y no para otras.
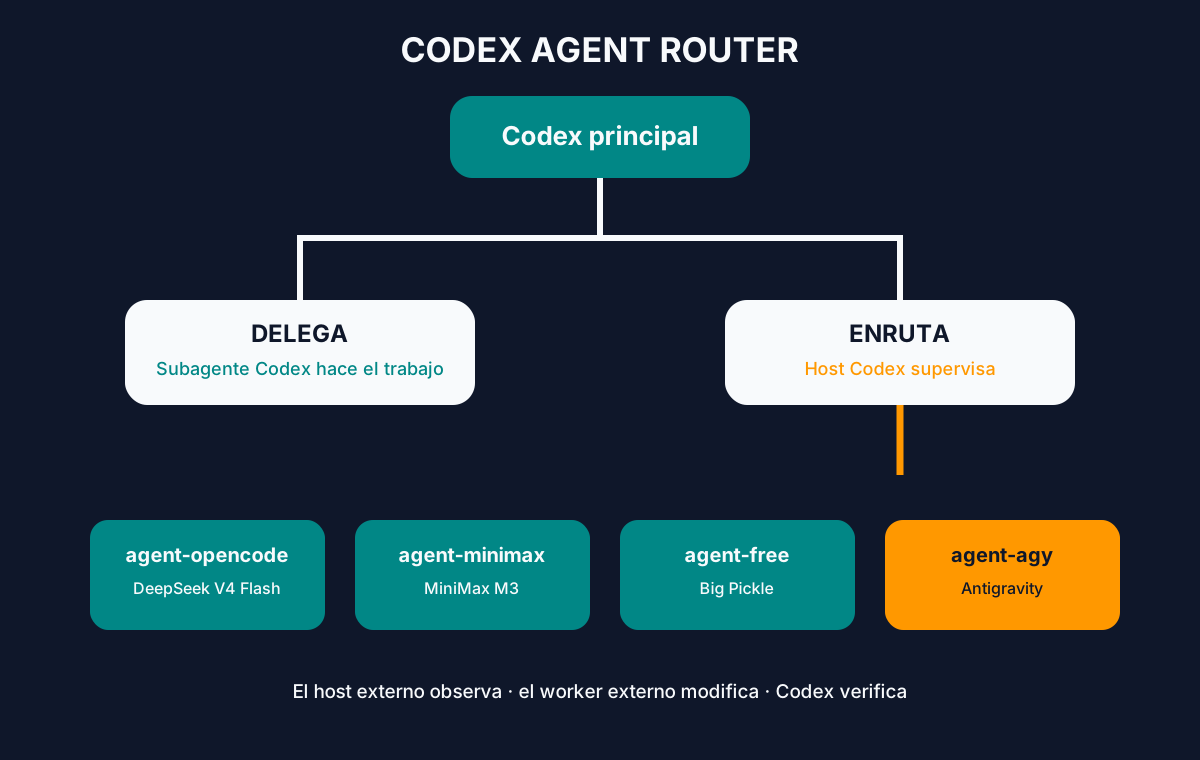
Así empezó lo que terminó convirtiéndose en cinco skills: agent-opencode, agent-free, agent-minimax, agent-agy y agent-router.
En el artículo técnico de esta semana explico toda la arquitectura con más calma. Este devlog es la otra cara: cómo llegué hasta ella, qué decisiones cambié por el camino y por qué una simple palabra —“enruta”— terminó siendo una de las mejores partes del diseño.
Y hay una diferencia importante respecto a la primera versión de esta entrada: después de escribirla empezamos a ejecutar el sistema de verdad. Aparecieron errores. Algunos parecían culpa del sandbox, otros parecían culpa de OpenCode y uno acabó siendo culpa de una línea de Bash que nosotros mismos habíamos escrito. Eso mejoró bastante el diseño.
Si quieres el análisis técnico completo, está en Codex Agent Router: Orquestar agentes externos. Aquí vamos con la cocina.
Punto de partida: si agy puede hacerlo, ¿por qué no los demás?
Todo empezó con Antigravity.
Ya tenía claro que agy permitía lanzar una tarea de Antigravity desde CLI. Eso cambia mucho la naturaleza de una herramienta. Una aplicación con interfaz gráfica puede ser estupenda, pero desde el punto de vista de automatización vive detrás de una puerta que un humano abre. Una CLI no interactiva, en cambio, se convierte en una pieza que otro proceso puede invocar.
Y Codex sabe invocar procesos.
La primera idea fue casi infantil:
Codex -> agy -> AntigravitySi yo puedo escribir en una terminal:
agy -p "Revisa este módulo"Codex también puede.
La pregunta siguiente apareció cinco segundos después: OpenCode también tiene CLI. Y no una CLI simbólica, sino un modo run específicamente útil para automatización.
Entonces el diagrama se estiró:
Codex
├── agy -> Antigravity
└── opencode run -> modelo externo
Aquí es donde la cosa dejó de ser un experimento gracioso y empezó a tener posibilidades reales. OpenCode podía actuar como harness común para varios modelos. Eso significaba que no necesitaba construir una integración distinta para cada proveedor.
En ese momento revisé los modelos que tenía disponibles y aparecieron varias opciones interesantes. Decidimos centrarnos en tres rutas dentro de OpenCode: DeepSeek V4 Flash como worker generalista, Big Pickle como worker gratuito y MiniMax M3 para trabajo largo a través del plan de MiniMax.
La cuarta ruta seguiría siendo Antigravity con agy.
En papel ya sonaba bien. En la práctica todavía no habíamos resuelto casi nada.
Primera discusión: ¿una skill o cuatro?
Mi primera pregunta fue muy normal: ¿de verdad necesito cuatro skills? ¿No puedo crear una sola y pasarle el modelo?
Sí, puedo.
Y durante unos minutos parece la solución más elegante.
$opencode deepseek ...
$opencode minimax ...
$opencode free ...
Pero cuanto más miraba los detalles, peor me parecía.
No quería que big-pickle fuera solo un string distinto. Quería que el worker gratuito tuviera reglas propias sobre información sensible. No quería que Antigravity compartiera el mismo contrato de permisos que OpenCode porque sus CLIs no funcionan igual. No quería que MiniMax pudiera terminar usando otra ruta de proveedor por un fallback silencioso. Y quería que el worker general de OpenCode tuviera una identidad estable.
Acabamos usando nombres consistentes:
agent-opencode
agent-free
agent-minimax
agent-agy
La nomenclatura me gustó porque deja hueco para crecer sin convertir la carpeta de skills en un cajón desastre.
Lo curioso es que separar las skills no hizo el sistema más complejo. Hizo el sistema más fácil de pensar.
Cada una sabe hacer una cosa.
El problema de “cuál uso” lo resolveríamos después, en otro nivel.
agent-opencode: el trabajador de propósito general
Para agent-opencode fijamos:
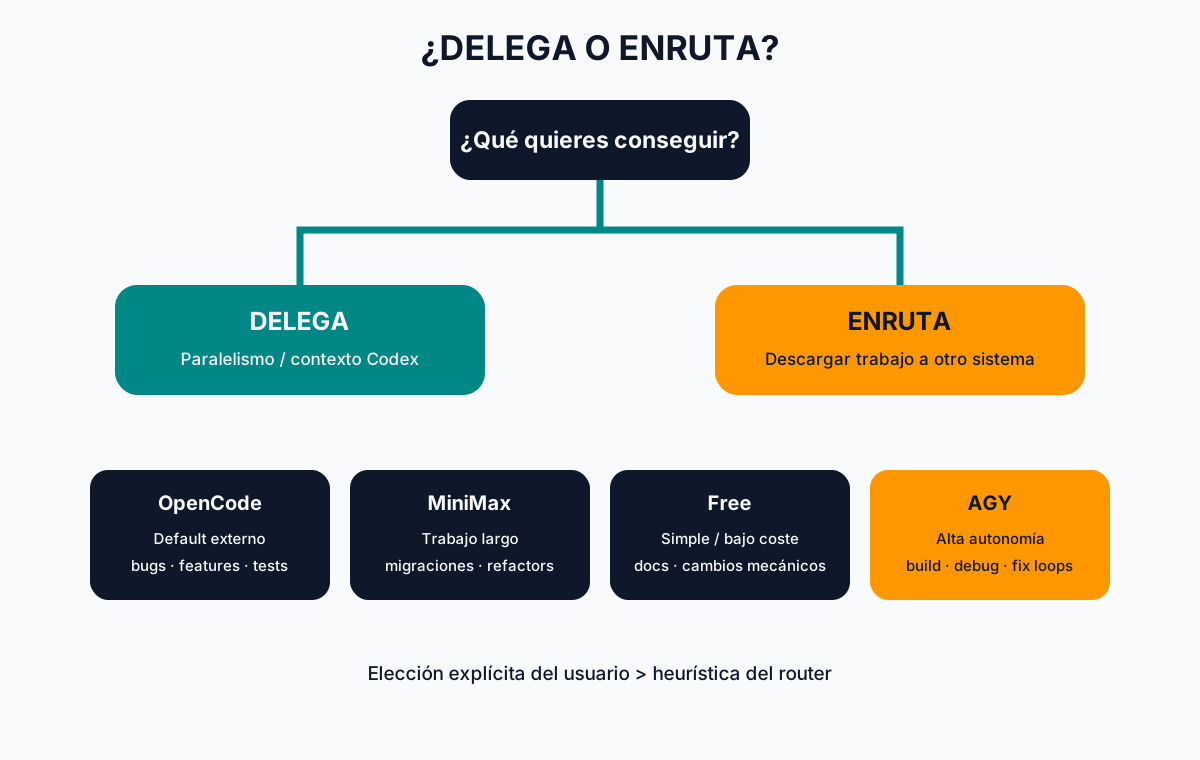
opencode-go/deepseek-v4-flashLa idea no era hacer una tabla de benchmarks y declarar ganador universal. Quería un worker rápido para el 80% de las tareas que no necesito mantener en Codex: un bug acotado, una implementación bastante clara, pruebas, refactor moderado, cambios en varios archivos pero con objetivo bien definido.
El comando base fue tomando forma:
opencode run \
  --model "opencode-go/deepseek-v4-flash" \
  --dir "$REPOSITORY" \
  --auto \
  "$TASK"
Hasta aquí, fácil.
Luego apareció la palabra “permisos”.
Y aquí empezó una de esas pequeñas madrigueras de conejo que hacen que una tarde de “voy a crear un alias” termine pareciéndose a diseñar un sistema distribuido.
OpenCode tiene permisos que pueden pedir confirmación. Eso es estupendo si estoy delante del terminal. Pero el plan era justo lo contrario: el agente externo debía trabajar desatendido.
Si OpenCode se para a preguntar y el proceso está lanzado dentro de Codex, tenemos una especie de muñeca rusa del bloqueo: OpenCode espera, Codex espera, yo sigo pensando que todo está trabajando y veinte minutos después descubro que faltaba aprobar una operación trivial.
Así que elegimos --auto.
El detalle importante es que autoaprueba lo que no está expresamente denegado. Un deny sigue siendo un muro.
Y eso nos llevó al siguiente debate: Git.
El pequeño drama de “¿puede hacer push?”
Inicialmente escribimos algo parecido a:
Do not commit, push, merge or delete branches unless explicitly requested.La frase es razonable. Pero inmediatamente surgió la duda: ¿esto significa que el worker puede detenerse, preguntarle al orquestador, esperar mi respuesta y continuar?
No necesariamente.
Ese descubrimiento fue importante porque estábamos mezclando dos niveles distintos: reglas de comportamiento y protocolo interactivo de permisos.
Una skill puede decirle al agente “no hagas push salvo autorización”. Eso no crea mágicamente un canal de conversación entre OpenCode, Codex y yo.
Podríamos construirlo. OpenCode tiene sesiones y mecanismos que permiten continuar trabajo. agy también. Pero en ese punto decidimos algo que simplificó mucho el diseño:
estos workers externos serán desatendidos.
Si hay una decisión rutinaria, la toman.
Si hay una ambigüedad pequeña, eligen la opción conservadora y la explican al final.
Si hay una decisión importante que podría cambiar el producto de forma incorrecta, no tocan esa parte, continúan lo demás y devuelven el bloqueo.
No quiero que un worker de veinte minutos se convierta en una conversación de veinte aprobaciones.
Y tampoco quise bloquear Git con deny absoluto. Si un día escribo de forma explícita “haz commit y push”, quiero que la tarea pueda hacerlo. La autorización debe venir del prompt original.
agent-free: por qué quería un worker que no doliera gastar
El siguiente fue agent-free.
Modelo:
opencode/big-picklePodría parecer un capricho tener una skill dedicada a “lo gratis”, pero en mi flujo tiene bastante sentido.
Hay tareas que son útiles y baratas intelectualmente. Un análisis preliminar. Un pequeño conjunto de tests. Documentación. Cambios mecánicos. Revisar un módulo de forma inicial. Si cada una de esas cosas consume el mismo modelo que reservo para una migración compleja, termino optimizando mis prompts alrededor de la cuota en vez de alrededor del trabajo.
El worker gratuito crea un carril psicológico y económico diferente.
También obliga a ser más consciente de privacidad. La skill lleva una instrucción explícita para no mandar deliberadamente claves, tokens, credenciales, .env, claves privadas, cookies de autenticación ni información especialmente sensible.
Y eso me recordó algo que conviene repetir: cuando hacemos routing de modelos, hacemos routing de datos.
No todo código debe enviarse a cualquier proveedor simplemente porque técnicamente se pueda.
agent-minimax: otro modelo, el mismo harness
MiniMax fue una decisión más interesante porque podía haber añadido otra herramienta completamente diferente.
Pero OpenCode ya estaba ahí.
Y si OpenCode podía usar MiniMax como proveedor, la pregunta pasó a ser: ¿quiero integrar otro frontend o quiero mantener el mismo harness?
Elegí el mismo harness.
agent-minimax fija:
minimax-coding-plan/MiniMax-M3Eso me permite mantener el mismo runner conceptual que agent-opencode.
Lo que cambia es para qué lo uso.
No quería una clasificación infantil tipo:
fácil -> gratis
medio -> DeepSeek
difícil -> MiniMax
muy difícil -> Antigravity
Eso suena ordenado y es falso.
Hay tareas difíciles que son pequeñas. Hay tareas fáciles que son enormes.
MiniMax quedó definido como worker para trabajo largo: migraciones, cambios repetitivos, refactors amplios, implementaciones con muchos archivos y tareas donde el agente puede pasarse un buen rato avanzando de forma autónoma.
La ventaja añadida es que el consumo puede ir por el plan de MiniMax, separando cuotas.
En un mundo ideal los tokens no importarían. En el mundo donde vivo, claro que importan.
agent-agy: “todos los permisos” significa exactamente eso
Con Antigravity tenía una petición muy clara: quiero que pueda trabajar sin quedarse parado pidiendo permisos.
agy ofrece:
--dangerously-skip-permissionsNo hay mucho margen para interpretar ese nombre.
Lo usamos deliberadamente.
También configuramos:
--effort high
--print-timeout 30m
--output-format stream-json
La razón del timeout era sencilla: cinco minutos pueden ser suficientes para responder una pregunta, pero no para una tarea que implique leer proyecto, ejecutar build, encontrar un fallo, tocar código y volver a probar.
La razón de stream-json acabó siendo clave para el sistema completo: si Codex va a supervisar un agente externo, necesita actividad observable mientras trabaja.
Nace agent-router y, como buen router, al principio tenía demasiado equipaje
Una vez creados los cuatro workers apareció la pregunta inevitable:
¿voy a recordar siempre cuál era el mejor para cada cosa?
Probablemente sí durante una semana.
Después empezaría a mandar todo a agent-opencode porque es el nombre que me saldría primero de los dedos.
Así nació agent-router.
El primer borrador fue larguísimo. Tenía reglas de permisos, modelos, Git, sesiones, fallbacks, concurrencia, explicación de cada worker, ejemplos, verificación y casi ganas de pedir una hipoteca.
Entonces paramos y revisamos qué debía hacer de verdad una skill-router.
No debía saber manejar agy.
No debía saber los flags de OpenCode.
No debía repetir la política completa de agent-free.
Solo necesitaba responder una pregunta:
¿dónde debe ir esta tarea?
El resto debía vivir en las skills específicas.
Recortarla fue probablemente la mejora más importante que hicimos en toda la configuración.
El momento de “delega” y “enruta”
Aun con el router simplificado quedaba un problema ridículamente humano.
Yo decía “delega esta tarea”.
¿A quién?
¿A un subagente de Codex?
¿A OpenCode?
¿A Antigravity?
Técnicamente todos son agentes y todos reciben trabajo delegado.
Podíamos hacer que agent-router analizara el prompt y eligiera. Pero entonces una palabra cotidiana como “delega” no tendría una semántica estable.
Así que hicimos algo mucho mejor: inventar una pequeña convención.
Delega = agentes internos de Codex.
Enruta = agentes externos.
Me encanta porque es sencilla y porque no intenta ocultar la arquitectura.
Si digo:
$agent-router delega la revisión de los testsquiero un subagente Codex.
Si digo:
$agent-router enruta la revisión de los testsquiero que el trabajo real salga hacia un worker externo.
Y puedo añadir:
enruta a MiniMax
enruta con Antigravity
enruta usando el agente gratuito
sin perder control.
El subagente host: un supervisor al que le está prohibido ayudar
Cuando quisimos ver qué estaba haciendo cada agente externo apareció la idea del host.
El host es un subagente nativo de Codex con una tarea muy poco heroica.
No programa.
No corrige.
No “aprovecha mientras tanto” para tocar otro archivo.
Lanza la skill externa, observa el proceso, mantiene la salida y devuelve el resultado.
Algo así:
Codex principal
    |
    +-- host "MiniMax · refactor"
            |
            +-- agent-minimax
                    |
                    +-- opencode run
                            |
                            +-- MiniMax hace el trabajo
La instrucción “no implementes tú la tarea” es crucial.
Parece absurdo crear un agente capaz y luego prohibirle ayudar, pero precisamente eso evita dos agentes escribiendo al mismo tiempo en el mismo sitio.
El host es una carcasa de observabilidad.
“Delega” crea un subagente que sí trabaja.
“Enruta” crea un subagente que supervisa a quien trabaja.
Ese matiz terminó siendo más importante de lo que esperaba.
Primer golpe de realidad: ln: Read-only file system
La arquitectura quedaba preciosa dibujada. Entonces llegó la primera ejecución real con MiniMax y apareció:
ln: Read-only file systemLa lectura inmediata fue: permisos.
El host está limitado. OpenCode no puede escribir. MiniMax ni siquiera puede empezar. Algo en el sandbox está mal.
Y sí, la capa de permisos del proceso padre importaba. Un host no puede inventarse privilegios que su padre no tiene. Ajustamos el contexto de ejecución para que el proceso exterior tuviera la autoridad necesaria.
El siguiente intento avanzó más.
Pero lo interesante llegó cuando seguimos investigando el ln concreto.
Ese ln no lo ejecutaba MiniMax.
Ni siquiera lo ejecutaba OpenCode.
Lo ejecutábamos nosotros en scripts/run.sh:
CURRENT="$LOG_DIR/current-${AGENT_NAME}.log"
ln -sfn "$LOG" "$CURRENT"
Habíamos creado un enlace current-agent-minimax.log para que fuera cómodo seguir el último log. Una idea perfectamente razonable y completamente innecesaria para el diseño final.
El error que parecía demostrar que el agente externo no tenía permisos era, en realidad, nuestro wrapper fallando antes de lanzar al agente externo.
Ese fue uno de los mejores bugs de la semana porque obligó a separar capas.
La solución fue quitar cosas, no añadir más permisos
En vez de intentar conseguir que el symlink funcionara en cualquier contexto, lo eliminamos.
Los logs dejaron de vivir como “estado actual” compartido y pasaron a ser artefactos únicos por ejecución:
LOG_DIR="${AGENT_ROUTER_LOG_DIR:-${TMPDIR:-/tmp}/codex-agent-router}"
STAMP="$(date '+%Y%m%d-%H%M%S')"
RUN_ID="${STAMP}-$$-${RANDOM}"
LOG="$LOG_DIR/${AGENT_NAME}-${RUN_ID}.log"
Ahora puedo tener:
/tmp/codex-agent-router/
├── agent-minimax-20260910-130501-12345-9123.log
├── agent-minimax-20260910-130502-12347-1221.log
├── agent-opencode-20260910-130504-12351-18003.log
└── agent-agy-20260910-130507-12360-22114.log
Dos MiniMax en paralelo ya no pelean por current-agent-minimax.log.
El wrapper tampoco necesita escribir bajo ~/.codex solo para dejar telemetría.
Y el host recibe el path exacto del log que pertenece a su ejecución.
La solución mejoró permisos, paralelismo y observabilidad al mismo tiempo simplemente eliminando una abstracción que ya no hacía falta.
Después apareció opencode.log, y nos hizo dudar otra vez
La siguiente ejecución avanzó más y falló al abrir:
~/.local/share/opencode/log/opencode.logEso volvió a parecer un problema de permisos.
Pero hicimos algo que quiero conservar como regla para futuras depuraciones: probar cada capa por separado.
Desde el mismo contexto de Codex se podía crear y borrar un fichero en ese directorio. Los permisos Unix del directorio y del fichero eran correctos. El propietario era el usuario esperado. El proceso OpenCode que estaba abierto manualmente tenía el mismo HOME y el mismo usuario.
También apareció una pista curiosa: había una sesión interactiva de OpenCode viva desde hacía horas.
Durante un momento parecía lógico pensar que quizá ese proceso persistente era la causa. Pero lsof no mostraba que tuviera abierto el log nuevo, y Linux no convierte normalmente un fichero de log en exclusivo simplemente porque otro proceso exista.
La conclusión fue más útil que el diagnóstico rápido: una sesión de OpenCode persistida y un proceso OpenCode vivo son dos cosas distintas.
Y eso nos llevó a cambiar el contrato de lifecycle.
Una tarea, un proceso
A partir de ahora, cada routing normal es efímero.
una tarea
    -> un host Codex
        -> un opencode run o un agy
            -> termina
        -> el host devuelve resultado
    -> termina el host
El router no reutiliza una TUI de OpenCode que yo tenga abierta.
No hace attach a una sesión existente por defecto.
No utiliza --continue ni --session salvo que la tarea diga explícitamente “continúa aquella ejecución”.
No mata tampoco mis sesiones interactivas. Son otro mundo.
Esto me gusta especialmente porque hace que el sistema sea repetible. Si dos tareas idénticas se enrutan en momentos distintos, ambas empiezan desde un proceso nuevo salvo que yo pida lo contrario.
OpenCode puede conservar el historial de la sesión internamente. Eso no significa que el proceso tenga que seguir vivo.
Es una diferencia pequeña en vocabulario y enorme en operación.
MiniMax por fin arrancó y entonces descubrimos el siguiente problema: veía demasiado poco
Después de corregir el launcher, MiniMax llegó a ejecutar una tarea real.
Modificó el test autorizado.
Ejecutó el test enfocado.
Pasó.
Ejecutó la suite completa.
También pasó.
git diff --check salió limpio.
Exit code 0.
Eso era justo lo que queríamos.
Pero durante la ejecución ocurrió algo todavía más interesante: el primer intento de test falló por JAVA_HOME. MiniMax encontró un JDK disponible, corrigió el entorno y reintentó.
El host me contó el resultado así, más o menos:
El primer intento falló por JAVA_HOME; MiniMax lo reintentó con el JDK disponible y pasó.Correcto.
Y totalmente insuficiente para el tipo de sistema que quiero.
¿Qué comando falló?
¿Qué valor de JAVA_HOME utilizó después?
¿Qué comando exacto reintentó?
¿Cambió solo una variable para ese proceso o tocó configuración persistente?
No quiero el chain of thought del modelo. Quiero saber qué hizo mi máquina.
Ese matiz terminó convirtiéndose en otra sección de las skills.
Observabilidad no es ver que “está trabajando”
Ahora el contrato dice que, cuando la información exista, el host debe enseñar:
- comandos shell relevantes;
- builds;
- tests;
- Git;
- cambios de entorno;
- errores;
- reintentos;
- acciones de recuperación;
- archivos importantes modificados.
Si un comando falla y el agente se recupera, la secuencia ideal es:
1. comando original;
2. error relevante;
3. acción correctiva;
4. comando de reintento;
5. resultado.
La frase “arregló JAVA_HOME” puede seguir apareciendo en el resumen final, pero no debería ser la única evidencia disponible.
También añadimos la regla contraria: el host no inventa comandos que no haya visto. Si el CLI externo solo ha emitido un resumen semántico, Codex debe admitirlo.
La observabilidad útil no consiste en fabricar detalle. Consiste en preservar el detalle disponible.
--print-logs, tee y un exit code que no mienta
Los wrappers de OpenCode pasaron a compartir el mismo patrón:
stdbuf -oL -eL \
  opencode \
    --print-logs \
    --log-level INFO \
    run \
    --model "$MODEL" \
    --dir "$REPO" \
    --auto \
    --format json \
    --title "Codex ${AGENT_NAME} ${RUN_ID}" \
    "$TASK" \
    2>&1 | tee "$LOG"

STATUS=${PIPESTATUS[0]}
Lo de PIPESTATUS[0] merece cariño.
Con un pipeline, Bash puede acabar devolviendo el estado de tee. Y tee puede funcionar perfectamente aunque OpenCode haya muerto.
No quería una ejecución así:
OpenCode -> exit 1
tee      -> exit 0
router   -> “éxito”
Ahora el estado final pertenece al worker real.
No es glamuroso. Es exactamente el tipo de detalle que quiero que exista sin tener que pensar en él cada vez.
AGY mantiene su stream-json y --dangerously-skip-permissions, pero adopta el mismo contrato alrededor: run único, log único, tee, exit code real y finalización del proceso.
Marcadores pequeños para no interpretar prosa
También añadimos dos marcadores básicos.
Al empezar:
AGENT_ROUTER_START
worker=agent-minimax
run_id=...
repository=...
log=...
Al terminar:
AGENT_ROUTER_RESULT
worker=agent-minimax
exit_code=0
log=/tmp/codex-agent-router/agent-minimax-....log
status=success
La intención no es inventar un protocolo enorme.
Solo quiero que el host no tenga que deducir de un párrafo si el proceso terminó, qué log le corresponde o cuál fue su exit code.
Cuanta menos interpretación necesite la infraestructura, mejor.
Paralelismo: sí, pero que Codex sepa que está ocurriendo
Otra pregunta apareció casi sola: si cada routing es un proceso independiente, ¿por qué no lanzar varios a la vez?
Sí.
Pero quiero que el paralelismo lo controle Codex, no que quede escondido dentro de OpenCode.
Para lectura, genial:
Codex
├── host A -> MiniMax revisa arquitectura
├── host B -> DeepSeek revisa tests
└── host C -> Big Pickle revisa documentación
Para escritura, cuidado.
Tres agentes editando el mismo fichero no son “multi-agent engineering”. Son tres procesos compitiendo por un recurso compartido.
La política actual es sencilla:
- lectura: paralelismo libre cuando tenga sentido;
- escritura con scopes claramente separados: posible;
- escritura solapada: no;
- tareas grandes en paralelo: worktrees separados.
La arquitectura que quiero terminar automatizando es:
Codex
├── host A -> MiniMax  -> worktree A
├── host B -> DeepSeek -> worktree B
└── host C -> AGY      -> worktree C
Y luego Codex integra.
Me gusta más que pedirle a un OpenCode persistente que lance subagentes por debajo porque mantiene el mapa de trabajo en el nivel donde yo lo estoy mirando.
Una decisión pequeña que evita una gran fiesta de subagentes
La delegación interna también tiene límites.
Por defecto, máximo tres subagentes concurrentes.
Y les decimos que no creen más subagentes salvo que yo lo pida.
Esto puede parecer demasiado conservador en 2026, cuando todo producto de IA quiere enseñarte una animación con veinte agentes corriendo en paralelo.
Mi experiencia es que veinte agentes son impresionantes en un gráfico y bastante menos impresionantes cuando cinco han investigado lo mismo y tres están editando el mismo archivo.
Los subagentes son excelentes cuando las tareas son independientes.
Por ejemplo:
subagente A -> algoritmo
subagente B -> tests
subagente C -> rendimiento
Perfecto.
subagente A -> cambia clase X
subagente B -> cambia clase X
subagente C -> refactoriza clase X mientras tanto
Eso no es multiagente. Es una recreación digital de tres personas intentando escribir en el mismo teclado.
La parte que no se ve: preparar un buen handoff
A estas alturas tenía nombres, routing, hosts, streaming y lifecycle.
Podía haber dado el trabajo por terminado.
Pero hay una cosa que mata sistemas de agentes mejores que este: mandarles tareas vagas.
agent-router tiene que convertir la conversación en un handoff autocontenido.
No copiar todo.
No pegar media hora de chat.
Extraer objetivo, restricciones, módulo relevante, comportamiento esperado, verificación, scope de escritura, cambios previos que hay que respetar y autorización Git si existe.
Eso reduce tokens y reduce errores.
También es una barrera de privacidad. Si la conversación contiene información de otros proyectos, no tiene por qué viajar al proveedor externo.
Una arquitectura de agentes bien montada no solo decide dónde se ejecuta el código. Decide qué contexto cruza cada frontera.
Lo bueno: por qué estoy contento con el resultado
Lo primero que gano es continuidad.
No abandono Codex para “usar otro agente”. Desde Codex decido que otra herramienta haga una parte del trabajo.
Lo segundo es separación de recursos. Puedo descargar tareas largas en MiniMax, tareas baratas en el worker gratuito, loops de herramientas en Antigravity y trabajo general en OpenCode/DeepSeek.
Lo tercero es que los nombres significan cosas.
agent-opencode no es una caja aleatoria.
agent-minimax no cambia silenciosamente de proveedor.
agent-free representa un objetivo de coste y tiene reglas más estrictas sobre secretos.
agent-agy representa autonomía y herramientas.
agent-router representa política.
Lo cuarto es que cada routing normal es una unidad de trabajo limpia: proceso nuevo, log nuevo, estado nuevo.
Lo quinto es la observabilidad. El host me da un hilo, el stream me da actividad y el log me da evidencia cuando la UI resume demasiado.
Lo sexto es que ahora puedo distinguir quién falló. Un ln en el wrapper no es un fallo de MiniMax. Un test roto por la implementación sí lo es.
Lo séptimo es que puedo sustituir piezas. Si dentro de seis meses cambia el modelo detrás de agent-opencode, el router no tiene por qué enterarse.
Y lo octavo sigue siendo mi favorito: tengo un vocabulario. “Delega” y “enruta” probablemente sea la feature que más use de todo esto.
Lo malo: porque por supuesto hay una factura
La primera factura son tokens.
Un host Codex que espera a un worker externo no es gratis. Estoy usando una capa adicional para ganar visibilidad.
La segunda es complejidad operativa.
Cinco skills son más que cero skills. Hay scripts. Hay CLIs. Hay autenticaciones. Hay versiones.
La tercera es el working tree.
Si me emociono y lanzo tres workers que escriben a la vez sobre los mismos archivos, la culpa no es de la IA. Es mía.
Necesitaré worktrees o scopes claramente separados para paralelismo de escritura serio.
La cuarta es Antigravity con permisos completos.
--dangerously-skip-permissions es útil precisamente porque es peligroso. No hay que maquillarlo.
La quinta es la privacidad.
Cada proveedor externo es una frontera. Aunque el flujo sea cómodo, sigo teniendo que decidir qué código puede salir.
La sexta es que agent-router no es omnisciente.
Puede mandar una tarea al worker equivocado. Por eso el routing explícito existe.
Y la séptima es que observabilidad no significa visibilidad perfecta. OpenCode o la UI pueden resumir eventos. Tener el log ayuda, pero todavía hay margen de mejora.
Qué solucionamos de verdad esta semana
Al principio pensaba que estaba construyendo un mecanismo para “usar OpenCode desde Codex”.
Eso habría sido una descripción bastante pobre.
Lo que terminó apareciendo es una capa de orquestación pequeña.
Antes:
yo -> herramienta A
yo -> herramienta B
yo -> herramienta C
yo -> reconciliarlo todo
Ahora:
yo -> Codex -> router -> host -> worker externo
                  |               |
                  |               +-> log + exit code
                  |
                  +-> Codex verifica
Y, cuando necesito paralelismo interno:
yo -> Codex -> delega -> subagentes CodexLa palabra clave no es “agentes”.
Es flujo.
He reducido el número de cambios de contexto humanos. Ese es el valor.
No me importa demasiado si por debajo hay cuatro modelos, seis procesos o doce formatos JSON si yo puedo mantener una conversación coherente con un orquestador.
Qué haría después
La mejora más clara ahora mismo es automatizar worktrees para routing paralelo de escritura.
Quiero que Codex pueda mirar tres tareas, detectar que tocan zonas solapadas y aislarlas antes de lanzar los workers.
También quiero capturar métricas: duración, exit code, número de archivos, tests, número de reintentos y quizá coste cuando esté disponible. Entonces el router podría basarse menos en intuición y más en experiencia real.
Otra mejora es hacer que el host presente mejor el stream estructurado. No necesito ver cada byte de JSON, pero sí quiero que herramientas, comandos, reintentos y cambios de entorno importantes aparezcan de forma cómoda.
Y sigue abierta la posibilidad del bridge interactivo: si un agente externo encuentra una decisión importante, Codex podría intentar responderla y escalarme solo cuando sea realmente necesario.
No quiero construirlo todavía.
La tentación será añadir todo.
Intentaré resistirla.
Una última regla: llamar a cada cosa por su nombre
Durante el proceso hubo una corrección que acabó importando más de lo previsto: dejar de llamar “subagente de Codex” a cualquier cosa que Codex lance.
Si Codex crea un agente nativo con su mecanismo multiagente, eso es un subagente de Codex.
Si Codex ejecuta OpenCode, MiniMax a través de OpenCode, Big Pickle o agy, eso es un agente externo.
Si un subagente Codex existe solo para mantener visible ese proceso externo, eso es un host.
Y si OpenCode guarda una sesión después de que el proceso termine, eso es historial persistido, no un proceso vivo.
Parece una obsesión terminológica, pero evita decisiones equivocadas. Cuando digo que una tarea se mantiene “interna”, estoy hablando también de fronteras de contexto y de proveedor. Cuando digo que una tarea se enruta fuera, sé que debo pensar en autenticación, cuota, políticas de datos y comportamiento de otro CLI.
El host no borra esa frontera. Solo la hace más cómoda de supervisar.
Esta semana me ha recordado algo bastante básico: una arquitectura empieza a ser manejable cuando sus nombres dejan de mentir.
Referencias técnicas de esta semana
- OpenAI — Codex
- OpenAI — Introducing the Codex app
- OpenAI Codex — implementación de
spawn_agent - OpenCode — documentación del CLI
- Google Antigravity — modo headless de AGY
- MiniMax — Token Plan
Cierre: una centralita pequeña es mejor que cinco teléfonos
Hay semanas en las que termino con una feature visible. Un botón nuevo. Una pantalla. Algo que puedes señalar.
Esta semana he terminado con cinco carpetas de skills, varios scripts y una cantidad sorprendente de opiniones sobre el ciclo de vida de un proceso Bash.
No es especialmente fotogénico.
Pero cambia mucho cómo quiero trabajar.
Lo que más me gusta es que no he intentado sustituir una herramienta por otra. He aceptado que cada una tiene cosas que me interesan y he intentado darles una jerarquía sencilla.
Codex manda.
Sus subagentes ayudan cuando digo “delega”.
Los agentes externos trabajan cuando digo “enruta”.
Un host los vigila.
Cada routing normal empieza limpio y termina cuando termina su proceso.
Los logs cuentan lo ocurrido sin competir por un symlink global.
El exit code pertenece al worker, no a tee.
Y si MiniMax arregla JAVA_HOME por el camino, quiero poder saber cómo.
Lo más divertido es que varios de estos principios no salieron de un diagrama. Salieron de errores concretos. Primero parecía que no teníamos permisos. Después parecía que OpenCode bloqueaba un log. Luego descubrimos que una parte del problema estaba en nuestro propio ln. Más tarde conseguimos que MiniMax trabajara correctamente y el problema pasó a ser que no veíamos suficiente detalle de lo que hacía.
Eso es probablemente lo mejor que le puede pasar a una arquitectura pequeña: que falle pronto, delante de ti y de una forma que puedas entender.
Ahora el sistema no solo funciona mejor. También sé bastante mejor dónde mirar cuando deje de funcionar.