
GitHub Pages: portfolio privado con mirror público
Índice de contenidos
Hace tiempo publiqué una guía general de GitHub Pages y Astro. Ese artículo explica cómo levantar un portfolio estático, configurar el dominio y desplegarlo con GitHub Actions. Pero mi propio portfolio terminó necesitando algo distinto: quería que el código que publico fuese visible, auditable y fácil de desplegar, sin convertir todo mi espacio de trabajo en un repositorio público.
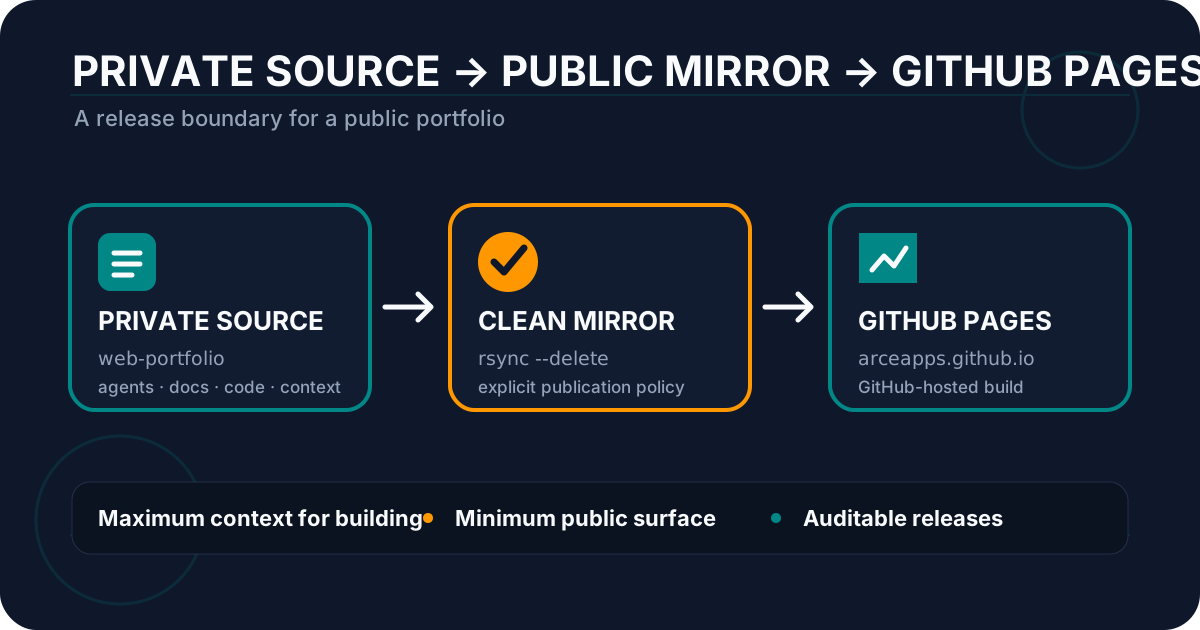
La solución que uso hoy no consiste en esconder un repositorio de Pages detrás de un truco. Es una arquitectura con dos repositorios y dos responsabilidades:
ArceApps/web-portfolioes la fuente privada;ArceApps/arceapps.github.ioes el mirror público;- un workflow del repositorio privado prepara una copia limpia;
- un self-hosted runner ejecuta esa sincronización;
- el repositorio público construye la web en un runner hospedado por GitHub;
- GitHub Pages publica el resultado.
En otras palabras: trabajo en privado, publico una distribución explícita y mantengo el despliegue público separado del entorno donde viven mis notas, especificaciones, prompts y herramientas internas.
Ese matiz importa. GitHub Pages puede trabajar con repositorios privados en planes compatibles. Por tanto, la motivación de este diseño no es “saltarse una limitación de Pages”. La motivación es controlar con precisión qué parte del repositorio privado se convierte en software público.
Este artículo documenta la arquitectura real que uso en mi portfolio, con el workflow, el script de filtrado, las decisiones de seguridad y también los puntos que todavía mejoraría.
El problema: un portfolio es más que los archivos que sirven al navegador
En un proyecto pequeño es fácil pensar que un repositorio web contiene solo esto:
src/
public/
package.json
astro.config.mjs
En la práctica, mi repositorio de trabajo contiene bastante más. Hay documentación interna, planes técnicos, bitácoras, configuración de agentes, prompts, especificaciones y ficheros que son útiles para desarrollar, pero que no tienen por qué formar parte de la distribución pública.
La diferencia es importante:
repositorio de trabajo != artefacto que quiero publicarPodría intentar resolverlo manteniendo todo en un único repositorio público y confiando en .gitignore. Pero .gitignore no es una frontera de publicación: solo controla qué archivos no se añaden a Git. Si un archivo interno ya está versionado, seguirá siendo público.
También podría mantener un único repositorio privado y desplegar directamente a Pages cuando el plan lo permita. Eso resuelve la privacidad del código, pero elimina una propiedad que me interesa: tener un repositorio público que represente exactamente la versión publicable del sitio y que pueda inspeccionarse por separado.
La arquitectura con mirror me da una tercera opción:
workspace privado
      │
      │ filtro explícito
      ▼
distribución pública
      │
      │ build
      ▼
GitHub Pages
El repositorio público no es mi workspace. Es una release source.
La arquitectura completa
El flujo real es este:
ArceApps/web-portfolio (privado)
          │
          │ push a main
          ▼
GitHub Actions
runs-on: self-hosted
          │
          │ scripts/sync-mirror.sh
          │ elimina contenido interno
          ▼
copia limpia temporal
          │
          │ rsync --delete
          ▼
ArceApps/arceapps.github.io (público)
          │
          │ push a main
          ▼
GitHub Actions
runs-on: ubuntu-latest
          │
          │ pnpm build
          ▼
artifact ./dist
          │
          ▼
actions/deploy-pages
          │
          ▼
       arceapps.com
Hay dos pipelines unidos por Git, no por un directorio compartido.
Eso significa que cada lado tiene una frontera clara:
| Capa | Responsabilidad |
|---|---|
| Repo privado | Desarrollo, contenido, automatización y material interno |
| Self-hosted runner | Preparar y publicar una copia limpia |
| Repo público | Contener solo el código que acepto hacer público |
| Runner de GitHub | Compilar el sitio público |
| GitHub Pages | Servir el artefacto estático |
Esta separación también reduce el privilegio necesario en cada fase. El runner privado necesita leer el repositorio privado y escribir en el mirror. El runner público no necesita acceso al repositorio privado.
Primera pieza: el workflow que sale del repositorio privado
En web-portfolio tengo un workflow llamado sync-to-public.yml. Se dispara cuando main cambia y también puede ejecutarse manualmente.
La estructura esencial es esta:
name: Sync to public arceapps.github.io

on:
  push:
    branches:
      - main
  workflow_dispatch:

concurrency:
  group: sync-to-public
  cancel-in-progress: false

jobs:
  sync:
    if: github.repository == 'ArceApps/web-portfolio'
    runs-on: self-hosted
Hay tres decisiones pequeñas que considero importantes.
1. Solo se ejecuta en el repositorio privado
La condición:
if: github.repository == 'ArceApps/web-portfolio'parece redundante porque el workflow ya vive allí. No lo es tanto cuando parte del código termina replicado a otro repositorio.
Si por error un workflow de mantenimiento llega al mirror, esta condición evita que se comporte como si siguiera estando en la fuente privada.
En mi caso, además, el propio script excluye el workflow de sincronización del mirror. Es una defensa en profundidad: no dependo de una única barrera.
2. Uso un grupo de concurrencia
concurrency:
  group: sync-to-public
  cancel-in-progress: false
No quiero dos sincronizaciones escribiendo simultáneamente en main del repositorio público.
Podría utilizar cancel-in-progress: true, pero en un pipeline de publicación prefiero que una ejecución que ya ha comenzado termine y que la siguiente se procese después. Es una decisión conservadora: prioriza una secuencia de commits coherente sobre ahorrar unos minutos.
3. El runner es privado
runs-on: self-hostedEl runner que toca el repositorio privado vive en mi infraestructura. Eso me permite controlar herramientas, cachés, red y entorno.
Pero aquí hay una regla de seguridad que considero más importante que la comodidad: ese runner no debe convertirse en un ejecutor general para código no confiable procedente de un repositorio público.
Los runners autohospedados son persistentes. No nacen limpios para cada job como los runners efímeros de GitHub. Si ejecutas una contribución maliciosa, el atacante puede intentar dejar persistencia, leer archivos del host o capturar credenciales que aparezcan en trabajos posteriores.
Por eso mi arquitectura actual hace algo deliberado: el self-hosted runner participa en el lado privado; el repositorio público compila con ubuntu-latest.
Dos checkouts: origen privado y destino público
El workflow hace primero checkout del repositorio fuente:
- name: Checkout private source
  uses: actions/checkout@v4
  with:
    fetch-depth: 0
Después clona el repositorio público en un subdirectorio separado:
- name: Checkout public repo destination
  uses: actions/checkout@v4
  with:
    repository: ArceApps/arceapps.github.io
    token: ${{ secrets.PUBLIC_RELEASE_TOKEN }}
    path: public-repo
    ref: main
El árbol del job queda conceptualmente así:
$GITHUB_WORKSPACE/
├── .git/                 # historia de web-portfolio
├── src/
├── public/
├── scripts/
└── public-repo/
    ├── .git/             # historia independiente del mirror
    ├── src/
    └── public/
Ese detalle es clave. No hago git push --mirror.
Un git push --mirror replica referencias e historia Git. Eso sería justo lo que no quiero cuando el repositorio origen contiene commits con archivos o contexto que no deseo publicar.
Yo replico el working tree filtrado, no la historia privada.
El mirror público crea su propia secuencia de commits del tipo:
chore: sync clean mirror from web-portfolioAsí, el repositorio público tiene una historia de publicación independiente.
El corazón del sistema: construir una copia limpia
La parte más importante no es GitHub Pages. Es scripts/sync-mirror.sh.
La versión actual empieza de forma muy simple:
#!/usr/bin/env bash
set -euo pipefail

SOURCE_DIR="${1:-.}"
DEST_DIR="${2:-/tmp/public-mirror}"

rm -rf "$DEST_DIR"
mkdir -p "$DEST_DIR"
set -euo pipefail es casi obligatorio para este tipo de script:
-e: aborta ante un comando que falla;-u: evita variables no definidas silenciosamente;pipefail: hace que un fallo dentro de un pipeline no quede oculto.
Después llega el filtro real:
rsync -av --delete \
  --exclude='.git' \
  --exclude='.github/workflows/sync-to-public.yml' \
  --exclude='.opencode' \
  --exclude='agents' \
  --exclude='docs' \
  --exclude='openspec' \
  --exclude='AGENTS.md' \
  --exclude='BUGS.md' \
  --exclude='AUDIT_WEB_*.md' \
  --exclude='CONTEXT.md' \
  --exclude='design.md' \
  --exclude='test-results' \
  --exclude='.astro' \
  --exclude='dist' \
  --exclude='node_modules' \
  --exclude='public-repo' \
  "$SOURCE_DIR/" "$DEST_DIR/"
Esto crea una copia desde cero en un directorio temporal.
No modifica el repositorio de trabajo. No borra carpetas internas. No necesita una rama especial llena de commits de limpieza.
Esa propiedad hace que el proceso sea mucho más fácil de razonar:
fuente intacta
   +
regla de publicación
   =
copia publicable
Por qué --delete es más importante de lo que parece
En un mirror, copiar archivos nuevos no basta.
Imagina que ayer tenías:
public/old-logo.svgHoy lo eliminas del repositorio privado. Si la sincronización solo hace una copia incremental sin eliminar, el mirror podría conservar old-logo.svg para siempre.
Eso produce un problema sutil: el repositorio público deja de representar el estado actual de la fuente.
Por eso utilizo --delete tanto al crear la copia como al pasarla al checkout del mirror:
rsync -av --delete --exclude='.git' \
  "$RUNNER_TEMP/clean-mirror/" public-repo/
La semántica que busco es:
destino = copia exacta de lo permitido en origenno:
destino = todo lo que alguna vez copiéPara una distribución pública, los archivos obsoletos también son una forma de fuga.
La excepción crítica: no borrar .git del mirror
Cuando sincronizo sobre public-repo/, excluyo .git:
--exclude='.git'Sin esa exclusión destruiría la identidad del repositorio destino.
Quiero reemplazar el árbol de trabajo, pero conservar:
public-repo/.git/porque ahí viven:
- el remote correcto;
- la rama;
- la historia pública;
- la configuración necesaria para crear el siguiente commit.
Después la secuencia es convencional:
cd public-repo

git config user.name "github-actions[bot]"
git config user.email "github-actions[bot]@users.noreply.github.com"

git add -A
Uso git add -A, no git add ., porque quiero que Git registre también archivos eliminados.
Finalmente:
if git diff --staged --quiet; then
  echo "No changes to sync to public repo."
else
  git commit -m "chore: sync clean mirror from web-portfolio"
  git push ...
fi
No creo commits vacíos. Si el resultado público no ha cambiado, el pipeline termina sin ensuciar la historia.
Denylist frente a allowlist: el principal trade-off del diseño
Mi script actual usa una denylist:
publica todo
excepto estas rutas
Es cómodo en un proyecto web porque los nuevos componentes, estilos o imágenes se publican automáticamente.
El inconveniente es evidente: si mañana creo una carpeta interna nueva y olvido añadirla a los --exclude, puede llegar al mirror.
Para un portfolio personal acepto ese equilibrio porque reviso el repositorio y el contenido interno está bastante estructurado. Pero si aumentase la sensibilidad del proyecto, cambiaría de enfoque.
Una allowlist invertiría la regla:
no publiques nada
salvo estas rutas
Por ejemplo:
mkdir -p "$DEST_DIR"

rsync -av \
  package.json \
  pnpm-lock.yaml \
  astro.config.mjs \
  tsconfig.json \
  "$DEST_DIR/"

rsync -av src/ "$DEST_DIR/src/"
rsync -av public/ "$DEST_DIR/public/"
rsync -av scripts/ "$DEST_DIR/scripts/"
Es menos automática. Cada nueva carpeta pública tiene que incorporarse explícitamente.
Pero la propiedad de seguridad es mejor:
olvidar una ruta provoca un build roto, no una publicación accidental.
En sistemas donde la confidencialidad pesa más que la comodidad, prefiero ese modo de fallo.
Un mirror filtrado no sustituye a una buena gestión de secretos
Hay una tentación peligrosa: pensar que, como secrets.env está excluido del mirror, ya es seguro guardarlo en Git.
No.
El filtro protege la distribución pública, no convierte el repositorio privado en un gestor de secretos.
Las credenciales deben seguir viviendo en GitHub Secrets, en un almacén de secretos o en el entorno de ejecución.
El script de mirror me sirve para separar:
- documentación interna;
- especificaciones;
- configuración de agentes;
- outputs de pruebas;
- directorios de trabajo.
No lo considero una segunda oportunidad para “ocultar” claves que nunca deberían haberse versionado.
La credencial que escribe en el repositorio público
Para clonar y hacer push al destino, el workflow utiliza:
token: ${{ secrets.PUBLIC_RELEASE_TOKEN }}La credencial tiene una función muy concreta: permitir que el pipeline privado escriba en ArceApps/arceapps.github.io.
La regla que aplicaría aquí es la de mínimo privilegio:
- acceso solo al repositorio público;
- solo los permisos Git necesarios;
- sin permisos de organización que no hagan falta;
- rotación y caducidad razonables.
Un fine-grained personal access token es mejor que un token clásico si encaja con la configuración. Un GitHub App puede ser aún mejor cuando quieres credenciales de corta duración. Y si la única operación fuese Git por SSH, un deploy key con escritura sería otra opción.
Hay además un detalle de endurecimiento que quiero corregir en una siguiente iteración de mi propio workflow. Actualmente el git push construye una URL con el token:
git push "https://x-access-token:${PUBLIC_RELEASE_TOKEN}@github.com/ArceApps/arceapps.github.io.git" mainFunciona, pero pasar secretos como argumentos de proceso no es mi opción favorita en un host persistente. GitHub advierte de que otros procesos o trabajos del mismo sistema pueden llegar a inspeccionar argumentos de línea de comandos.
Preferiría evitar que el secreto aparezca en el comando, reutilizando la autenticación configurada por actions/checkout, usando un helper de credenciales temporal, un GitHub App o un mecanismo equivalente.
No invalida la arquitectura, pero sí es un buen ejemplo de por qué conviene revisar cómo circula una credencial, no solo dónde se guarda.
El mirror público inicia un segundo pipeline
Hasta este punto no he desplegado ninguna web.
Solo he publicado código limpio en:
ArceApps/arceapps.github.ioEse repositorio tiene su propio workflow deploy.yml.
La primera decisión que quiero destacar es esta:
jobs:
  build:
    if: github.repository == 'ArceApps/arceapps.github.io'
    runs-on: ubuntu-latest
El build público usa un runner hospedado por GitHub, no mi self-hosted runner.
Esto es deliberado.
El repositorio público es, por definición, una superficie más expuesta. Aunque yo controle quién puede escribir en main, prefiero que el proceso que compila su contenido no tenga acceso por defecto a mi máquina privada.
El pipeline instala sus herramientas desde cero:
- name: Install pnpm
  uses: pnpm/action-setup@v4
  with:
    version: 10

- name: Setup Node
  uses: actions/setup-node@v4
  with:
    node-version: '20'
    cache: 'pnpm'

- name: Install dependencies
  run: pnpm install --no-frozen-lockfile
Después actualiza los datos que usa el portfolio:
- name: Update Google Play Data
  run: pnpm run apps:update
y compila:
- name: Build
  run: pnpm run build
  env:
    CONTACT_FORM_KEY: ${{ secrets.CONTACT_FORM_KEY }}
En Astro, el resultado termina en dist/.
Publicar en GitHub Pages con el flujo oficial
El repositorio público usa las acciones de Pages:
- name: Setup Pages
  uses: actions/configure-pages@v4

- name: Upload artifact
  uses: actions/upload-pages-artifact@v3
  with:
    path: ./dist
Después un job separado despliega el artefacto:
deploy:
  if: github.repository == 'ArceApps/arceapps.github.io'
  needs: build
  runs-on: ubuntu-latest
  environment:
    name: github-pages
    url: ${{ steps.deployment.outputs.page_url }}
  steps:
    - name: Deploy to GitHub Pages
      id: deployment
      uses: actions/deploy-pages@v4
Y el workflow declara los permisos mínimos que Pages necesita:
permissions:
  contents: read
  pages: write
  id-token: write
Me gusta esta separación entre build y deploy porque el despliegue solo existe si el build previo ha terminado correctamente.
Si pnpm build falla, no hay artefacto válido que desplegar. Pages no debería sustituir la versión anterior por un artefacto roto.
Qué ocurre exactamente cuando hago git push
Una arquitectura se entiende mejor recorriéndola de extremo a extremo.
Supongamos que cambio un artículo y hago:
git push origin mainEntonces sucede esto:
- GitHub recibe el nuevo commit en
web-portfolio. sync-to-public.ymlse activa.- El job se asigna al self-hosted runner.
- El runner clona el repositorio privado.
- Clona
arceapps.github.iodentro depublic-repo/. - Ejecuta
scripts/sync-mirror.sh. - El script crea un directorio temporal vacío.
rsynccopia todo excepto las rutas internas.- Un segundo
rsync --deletereemplaza el working tree del repositorio público. - Se conserva
public-repo/.git. git add -Acalcula el delta público.- Si no hay diferencias, el pipeline termina.
- Si las hay, crea un commit de sincronización.
- Ese commit se hace push a
maindel mirror. - El push activa
deploy.ymlen el repositorio público. - GitHub arranca un
ubuntu-latest. - Instala pnpm, Node y dependencias.
- Ejecuta la actualización de datos y
pnpm build. - Sube
dist/como artefacto de Pages. actions/deploy-pagespublica la nueva versión.
Hay dos commits potencialmente distintos para una sola modificación:
commit de desarrollo privado
            ↓
commit de distribución pública
Eso no es ruido accidental. Representa dos conceptos distintos.
Por qué no desplegar directamente desde el repositorio privado
Es una alternativa perfectamente válida, y en muchos proyectos sería la que elegiría.
Si Pages está disponible para el tipo de repositorio y el plan que utilizas, puedes hacer:
repo privado → build → PagesEs más sencillo.
Entonces, ¿por qué mantengo el mirror?
1. Separación de responsabilidades
El repositorio privado es mi entorno de trabajo. El público representa el producto publicable.
2. Transparencia selectiva
Puedo enseñar el código del sitio sin publicar agentes, notas, planes ni documentos auxiliares.
3. Historia pública limpia
Los commits del mirror describen releases del sitio, no toda la actividad interna.
4. Desacoplamiento de infraestructura
El despliegue público puede usar sus propios secrets, permisos, settings de Pages y runners.
5. Una frontera explícita
La publicación deja de ser “todo el repositorio” y se convierte en una transformación que puedo revisar y probar.
A cambio pago con complejidad: dos repositorios, una credencial de escritura y un paso extra de sincronización.
No vendería este patrón como universal. Me compensa porque mi repositorio privado es más que el código del sitio.
Seguridad del self-hosted runner: la parte que no ignoraría
Tener tu propio runner es atractivo. También aumenta tu responsabilidad.
GitHub avisa de que un self-hosted runner puede quedar comprometido de forma persistente si ejecuta código no confiable.
En un runner hospedado por GitHub, la máquina se prepara de nuevo para el trabajo. En un runner autohospedado tradicional, un job puede modificar el host y ese estado puede sobrevivir.
Por eso aplico estas reglas:
No ejecuto PR públicos arbitrarios en el runner privado
Un pull request desde un fork puede modificar un script de build. Si ese script termina en mi servidor personal con secretos o acceso a red interna, el problema deja de ser “CI”.
Mantengo el runner vinculado al repositorio privado
No quiero que cualquier repositorio de la organización pueda seleccionar esa etiqueta accidentalmente.
Los runner groups permiten limitar qué repositorios o workflows pueden utilizar un runner.
Separo publicación privada de build público
El mirror es precisamente la frontera.
privado + self-hosted
        │
        ▼
mirror
        │
        ▼
público + GitHub-hosted
Esa decisión reduce mucho el número de caminos por los que código público podría alcanzar mi infraestructura.
Qué archivos excluyo y por qué
Mi lista actual tiene varias categorías.
Metadatos y herramientas internas
.opencode
agents
openspec
AGENTS.md
Sirven para orquestar y documentar el trabajo de desarrollo. No son runtime del portfolio.
Documentación y especificaciones
docs
CONTEXT.md
design.md
AUDIT_WEB_*.md
BUGS.md
Pueden contener decisiones, borradores o contexto que no forma parte de la web pública.
Artefactos generados
.astro
dist
node_modules
test-results
No quiero versionar outputs reproducibles o dependencias locales en el mirror.
Infraestructura específica del origen
.github/workflows/sync-to-public.yml
public-repo
El mirror no debe volver a ejecutar el mecanismo que lo genera.
Clasificar las exclusiones por intención me parece mejor que mantener una lista plana. Ayuda a detectar cuándo aparece una nueva clase de fichero.
Cómo probaría el mirror como si fuese código de producción
La mejora que más valor aportaría ahora es dejar de tratar sync-mirror.sh como un simple script auxiliar y añadirle tests de contrato.
Por ejemplo, un test podría crear esta fuente:
fixture/
├── src/index.ts
├── public/logo.svg
├── agents/private.md
├── docs/design.md
└── CONTEXT.md
Ejecutar:
./scripts/sync-mirror.sh fixture outputy comprobar:
test -f output/src/index.ts
test -f output/public/logo.svg

test ! -e output/agents
test ! -e output/docs
test ! -e output/CONTEXT.md
También probaría el comportamiento de --delete:
- sincronizar un archivo público;
- borrarlo de la fixture;
- volver a sincronizar;
- verificar que desaparece del destino.
Y añadiría un test inverso especialmente útil:
ninguna ruta interna conocida puede existir en outputEso convierte una política de publicación en una condición ejecutable.
Otra mejora: un manifiesto de la distribución pública
Una idea que me gusta es mantener un pequeño fichero declarativo, por ejemplo:
include:
  - src/**
  - public/**
  - scripts/**
  - package.json
  - pnpm-lock.yaml
  - astro.config.mjs
  - tsconfig.json

exclude:
  - agents/**
  - docs/**
  - openspec/**
El script podría leer ese manifiesto, y un test validar que no aparecen nuevas rutas de primer nivel sin clasificación.
El objetivo no es crear un framework. Es hacer visible una pregunta que hoy depende de disciplina:
¿esta carpeta pertenece al producto público o al workspace privado?
Cuanto más explícita sea esa decisión, menos probable es una fuga accidental.
Fallos parciales: pensar en el sistema como dos transacciones
El pipeline puede fallar en varios puntos:
A) falla el filtrado
B) falla el push al mirror
C) falla el build público
D) falla el deploy de Pages
Cada fallo tiene consecuencias diferentes.
Si falla antes del push público
El mirror no cambia. Producción tampoco.
Si el mirror recibe el commit pero el build falla
La fuente pública contiene un commit que no llegó a producción.
Eso no me parece necesariamente malo. GitHub Actions deja el fallo visible y la versión anterior de Pages continúa siendo la referencia desplegada.
Si dos cambios llegan muy seguidos
La concurrencia del workflow privado serializa la sincronización. En el lado de Pages también es razonable tener una política de concurrencia si el ritmo de publicación aumenta.
Lo importante es que el estado nunca dependa de copiar manualmente archivos entre carpetas.
El repositorio público también es una herramienta de auditoría
Hay un beneficio que no valoré al principio.
Puedo inspeccionar:
ArceApps/arceapps.github.iocomo lo vería cualquier visitante y responder:
- ¿se publicó una carpeta que no debía?
- ¿hay archivos generados innecesarios?
- ¿el diff público de este cambio tiene sentido?
- ¿la release contiene solo lo necesario?
El diff entre dos commits del mirror es una auditoría de superficie pública.
En el repositorio privado, un PR puede contener cambios en código, documentación interna y automatización. En el mirror, el commit resultante elimina ese ruido y muestra únicamente lo que cruzó la frontera.
No todo lo “interno” tiene que ser secreto
Quiero hacer otra distinción.
agents/ está excluido del mirror, pero eso no significa necesariamente que cada línea sea confidencial.
Lo mismo ocurre con docs/.
La arquitectura no debería convertirse en una obsesión por esconder cualquier detalle de implementación. El valor está en decidir qué constituye el producto publicado.
Mañana podría decidir que una guía interna merece hacerse pública. En ese caso la movería a una ubicación pública o cambiaría la política.
La privacidad aquí es una propiedad de arquitectura, no una etiqueta moral sobre los archivos.
Alternativas que consideraría
Hay varias formas razonables de resolver el mismo problema.
Opción A: repositorio privado directo a Pages
private repo → PagesLa más simple cuando no necesitas código fuente público separado.
Opción B: build privado y publicar solo dist
private repo → build → repo público con HTML generadoReduce todavía más la superficie pública: ni siquiera expones el código Astro.
A cambio, el mirror deja de ser un repositorio útil para estudiar el proyecto.
Opción C: orphan branch
Podrías publicar una rama gh-pages sin historia compartida.
Funciona, pero prefiero un repositorio separado cuando la frontera privado/público es una parte importante del diseño.
Opción D: Pages externas
Cloudflare Pages, Netlify o Vercel pueden construir directamente desde un repo privado.
Son excelentes opciones. Mi motivo para quedarme con GitHub Pages es que todo el flujo ya vive en GitHub y el sitio es completamente estático.
Cómo generalizar el patrón
El mismo enfoque sirve para más cosas que un portfolio.
Por ejemplo:
monorepo privado
├── producto
├── documentación interna
├── scripts
└── ejemplos publicables
puede producir:
repo público SDKo:
repo público de documentaciónEl patrón abstracto es:
source
  ↓
policy
  ↓
public projection
  ↓
build/deploy
La pieza importante es policy.
En mi caso hoy está expresada con rsync --exclude. Podría ser un script TypeScript, un manifest, una lista de includes o incluso un build que genere un paquete.
El mirror no tiene por qué parecerse al origen.
Un ejemplo mínimo reutilizable
Si quisiera explicar el patrón sin nada específico de mi portfolio, empezaría con algo así:
name: Publish public mirror

on:
  push:
    branches: [main]

jobs:
  mirror:
    runs-on: self-hosted
    steps:
      - uses: actions/checkout@v4

      - uses: actions/checkout@v4
        with:
          repository: my-org/public-site
          token: ${{ secrets.PUBLIC_REPO_TOKEN }}
          path: public-repo

      - name: Build clean source tree
        run: |
          rm -rf "$RUNNER_TEMP/release"
          mkdir -p "$RUNNER_TEMP/release"

          rsync -av --delete \
            --exclude='.git' \
            --exclude='internal' \
            --exclude='docs/private' \
            ./ "$RUNNER_TEMP/release/"

      - name: Publish
        run: |
          rsync -av --delete --exclude='.git' \
            "$RUNNER_TEMP/release/" public-repo/

          cd public-repo
          git add -A

          if git diff --staged --quiet; then
            exit 0
          fi

          git commit -m "chore: publish source mirror"
          git push origin main
No copiaría este ejemplo a producción sin adaptar permisos y autenticación. Pero contiene las propiedades esenciales:
- dos checkouts;
- directorio temporal limpio;
- política de exclusión;
- preservación de
.git; --delete;- ausencia de commits vacíos.
Lo que mejoraría en mi siguiente iteración
Si diseñase una versión 2 del sistema, mi lista sería esta.
1. Convertir el filtro en allowlist
Al menos para los directorios de primer nivel.
2. Añadir tests automáticos del mirror
El pipeline debería fallar si aparece una ruta interna.
3. Reducir el alcance y vida de la credencial
Preferiblemente GitHub App o una credencial específica de repositorio.
4. Evitar el token en argumentos de proceso
La autenticación debería quedar fuera del git push visible.
5. Fijar acciones por commit SHA en la ruta sensible
Usar tags como @v4 es cómodo. En pipelines donde una acción tiene acceso a secretos o capacidad de publicación, fijar una revisión exacta reduce riesgo de supply chain.
6. Revisar permisos explícitos del workflow privado
No depender de permisos por defecto si el job solo necesita una fracción.
7. Generar un informe de publicación
Algo tan sencillo como:
files published: 742
files excluded: 61
top-level dirs: src, public, scripts
haría cada ejecución más fácil de auditar.
Una consecuencia interesante para trabajar con agentes de IA
Hay un motivo adicional por el que esta arquitectura encaja bien con mi forma actual de desarrollar.
Mi repositorio privado puede contener contexto rico para agentes:
agents/
docs/
specs/
prompts/
bitácoras/
Ese contexto mejora el trabajo del agente, pero no tiene por qué ser parte del producto.
Sin una frontera de publicación, empiezas a diseñar el workspace condicionándolo por lo que te da miedo hacer público.
Con el mirror puedo optimizar ambas cosas por separado:
workspace → útil para construir
release   → mínima para publicar
Esto me parece una idea importante para proyectos asistidos por IA. Los agentes funcionan mejor con contexto. Las releases funcionan mejor con superficie pequeña.
No tienen por qué ser el mismo árbol.
Lecciones que me llevo
Después de usar este sistema, hay varias ideas que generalizaría.
Publicar es una transformación
No considero el repositorio privado como “lo que se despliega”. Lo considero la entrada de un proceso que produce una distribución.
La historia Git también es información
Filtrar archivos pero replicar toda la historia habría roto el objetivo. Por eso el mirror tiene historia propia.
Un runner privado es infraestructura, no un checkbox
En cuanto un workflow ejecuta en tu máquina, debes pensar en aislamiento, persistencia, credenciales y código no confiable.
Fallar cerrado es mejor para datos sensibles
Una allowlist rota un build cuando olvidas algo. Una denylist puede publicar algo cuando olvidas algo. El modo de fallo importa.
Un repositorio público limpio tiene valor por sí mismo
No es solo un intermediario para Pages. Es una representación auditable del producto.
Conclusión
Mi portfolio podría desplegarse con menos piezas. Podría construir directamente desde el repositorio privado o mover todo al repositorio público.
Pero ninguna de esas opciones representa exactamente cómo quiero trabajar.
Quiero un workspace privado en el que pueda guardar contexto técnico, agentes, especificaciones y herramientas sin pensar continuamente en la exposición pública. Y quiero, al mismo tiempo, un repositorio público que muestre el código real que construye el sitio.
Por eso terminé con este flujo:
web-portfolio
   privado
      │
      │ self-hosted runner
      │ filtro reproducible
      ▼
arceapps.github.io
   público
      │
      │ GitHub-hosted runner
      ▼
GitHub Pages
      │
      ▼
arceapps.com
La parte más útil no es rsync, ni Astro, ni siquiera Pages.
Es la frontera.
Cuando el repositorio de desarrollo y la distribución pública dejan de ser la misma cosa, puedes diseñar cada uno para su propósito: máximo contexto para construir, mínima superficie para publicar.
Y para un proyecto indie que cada vez acumula más automatización, esa separación me resulta más valiosa que cualquier truco de CI.
Bibliografía y referencias
- GitHub Docs — Using custom workflows with GitHub Pages
- GitHub Docs — About self-hosted runners
- GitHub Docs — Adding self-hosted runners
- GitHub Docs — Secure use reference for GitHub Actions
- GitHub Docs — Managing access to self-hosted runners using groups
- GitHub Docs — Compromised runners
- GitHub Docs — Configuring a publishing source for GitHub Pages
- ArceApps — GitHub Pages para Android Devs: portfolio profesional
También te puede interesar

GitHub Agentic Workflows: la automatización de código con agentes de IA
CI/CD ya automatiza builds y deploys, pero todavía dedicamos horas a triage, fallos de CI y documentación desalineada. GitHub Agentic Workflows lleva la automatización un paso más allá: agentes que operan dentro de límites definidos para encargarse de ese trabajo repetitivo con criterio.

Automatización de Versionado con GitHub Actions en Android
Descubre cómo automatizar completamente el versionado de tu app Android con GitHub Actions: desde commits hasta Google Play Store, sin intervención manual.

Semantic Versioning en CD/CI: La Ciencia Entre Versiones
Domina el versionado semántico en pipelines de CI/CD. Aprende a calcular versiones automáticamente y garantizar la trazabilidad total en tus despliegues Android.